 要使用 Mastodon 网页应用,请启用 JavaScript。或者,也可以尝试适用于您平台的 Mastodon 原生应用程序。
每日HackerNews RSS
抱歉。
《黑客的复兴》(The Hacker's Renaissance)是对自1986年原始宣言发布以来,黑客文化四十载演变的批判性思考。作者指出,曾经由纯粹的好奇心、颠覆精神和对自由的追求所定义的黑客精神,如今已被企业利益、风险投资和表演性的“网红”文化所净化与商品化。 尽管作者感叹现代黑客行为已从对真理的无政府式追求,转变为由漏洞赏金和合规框架定义的职业路径,但他们坚持认为这种精神并未消亡。相反,它已转入暗处,在独立基础设施、开源倡导以及拒绝在探索时寻求许可的行为中得以延续。 该宣言最后向下一代发出了行动号召:拒绝将你们的技艺商品化,优先追求深厚的技术知识而非证书,并重拾反叛精神。归根结底,它提醒人们,黑客行为从来不仅仅关乎技术本身,而在于在受控系统之外进行思考与构建的激进举动。这场复兴始于一个选择:停止消费,开始创造,且无需再次寻求认可。
抱歉。
作者对当前“代理型人工智能”(agentic AI)软件的爆发浪潮深表怀疑,并认为其中大部分是“虚假宣传”。尽管作者渴望使用能自动化处理软件开发中繁琐行政任务(如需求界定和质量保证)的工具,但他指出目前市场上的产品未能兑现承诺。 核心质疑在于,这些工具是由缺乏真实环境可用性测试的工程师开发的,导致产品普遍存在上手难度大、配置复杂且可靠性差等问题。作者以 ONA 平台为例,描述了一段令人沮丧的经历:该工具在进行基础集成时耗费了大量信用额度,最终带来的不是开发流程的精简,而是更多的“为了工作而工作”。 作者总结认为,这些公司正在自毁营销:如果代理型 AI 真如所宣称的那样有效,开发团队自己理应能交付出极其精致、无瑕的软件。然而现实是,当前的生态系统仍然充斥着大量昂贵且漏洞百出的工具,它们不仅没有帮助,反而阻碍了专业开发人员的工作。
这场 Hacker News 上的讨论聚焦于关于基于大模型的编程智能体(LLM-based coding agents)实际价值的激烈争论。
批评者认为,“十倍生产力”的炒作与可观测数据之间存在巨大差距。他们指出,主流开源项目并未表现出 AI 驱动带来的功能或可靠性激增,且维护者正越来越多地禁止 AI 贡献,因为这些内容往往是低质量的“废料”。一些怀疑论者认为科技行业在很大程度上是表演性的,AI 被用来制造一种进步的幻觉,以推高股价或为职业发展提供正当理由。
反之,支持者认为,对于那些具备正确驾驭能力的人来说,AI 是强大的工具。他们主张 AI 在特定任务(如调试、SIMD 优化和原型设计)上表现出色,而且许多“隐形”的生产力提升正发生在专有项目中,或者被那些觉得没必要公开工作流程的个人所实现。
最终,共识在于:尽管智能体编程并非“虚假宣传”,但它也不是万能药。它显著降低了“一次性”代码的门槛,但在高层架构和可维护性方面仍力不从心,往往将瓶颈从编写代码转移到了审查和修正 AI 生成的内容上。
2006年,作者创建了一个开源C++ UTF-8库。最近,他试图通过为ASCII字符添加专门的快速路径分支来优化其UTF-8解码过程。 在Clang上的初步测试结果令人印象深刻:纯ASCII文本的吞吐量翻了三倍,混合文本的性能也提升了34%。然而,GCC在处理ASCII时毫无提升,处理混合内容时性能甚至略有下降。 经调查汇编代码后,作者发现GCC的优化器已经有效地移除了对ASCII的验证检查,使得手动优化显得多余。相反,Clang并未进行此类优化,这意味着手动修改带来了显著的提升。 为了确保一致性,作者重构了代码,将验证逻辑以内联方式放入解码函数中。这种方法令两款编译器都表现良好,不仅保持了Clang上的收益,还在GCC上实现了15%至20%的混合文本性能提升。这一经验提醒我们,编译器行为差异巨大,深入研究生成的汇编代码对于有效的性能调优至关重要。
抱歉。
请启用 JavaScript 和 Cookie 以继续。
《经济学人》的一篇文章在 Hacker News 上引发了讨论,指出人工智能生成的法律诉讼正在司法系统中造成“公地悲剧”。AI 降低了法律诉讼的门槛,导致诉讼激增,使官僚机构不堪重负,不仅造成了严重的积案,还增加了雇主和法院的成本。
评论者的观点各不相同:
* **系统性失败与司法准入:** 一些人认为这是法律“民主化”的积极表现,使个人能够挑战以往因高昂诉讼成本而受到保护的企业或国家权力。另一些人则认为这是国家治理能力不足的迹象,即系统无法处理增加的业务量。
* **关于“滋扰诉讼”的辩论:** 批评者认为 AI 降低了诉讼质量,导致企业和法院在毫无根据的诉讼上浪费资源。支持者则反驳称,系统本身就存在偏见,这些诉讼只是将现有问题置于“聚光灯”下。
* **关于“悲剧”标签的讨论:** 多位用户指出,“公地悲剧”这一术语存在争议,并引用埃莉诺·奥斯特罗姆的研究指出,问题不在于公地本身,而在于缺乏有效的管理、问责制以及灵活的行政设计。
本仓库提供了一项研究成果及一个用于管理“全局设备标识符”(GDID)的加固工具(`degdid.ps1`)。GDID 是由微软 DeviceAdd 基础设施分配的 64 位设备 PUID。关键在于,即使是在本地账户下,Windows 也会生成此标识符;公开记录显示,微软可将这些 ID 与 URL、时间戳及 IP 地址进行关联。 所提供的 PowerShell 脚本专为非受管的个人版 Windows 10/11 安装环境设计。其工作原理是清除本地存储中现有的 GDID 状态,并通过网络层面的封锁,防止系统生成新的标识符。 **关键注意事项:** * **适用范围:** 本工具不会抑制常规遥测或基于浏览器的追踪;它专门针对 DeviceAdd 生命周期。 * **影响:** 封锁必要的网络通道会导致依赖微软账户的功能(如 Microsoft Store、Xbox、OneDrive 登录及手机连接)降级或失效。 * **使用说明:** 该工具需要在高权限的 PowerShell 会话中运行,旨在用于隐私研究与系统加固。用户应注意,本脚本按“原样”提供;输出的状态数据包含敏感的机器识别信息,切勿公开共享。 详细的文档、兼容性限制及恢复说明已包含在本仓库中。
对不起。
2025年,波兰国内生产总值(GDP)达到9229亿欧元,占欧盟经济总量的4.9%。这一里程碑确立了波兰作为欧盟第六大经济体的地位,超过了比利时、瑞典和奥地利等国,并继续保持其在中东欧地区的经济主导地位。 波兰的崛起得益于持续的工业发展、强劲的出口以及旺盛的国内消费。2025年,波兰以3.6%的增长率远超欧盟1.5%的平均增长水平。德国继续引领欧盟,其经济总量约占欧盟18.8万亿欧元经济总量的四分之一。 然而,欧盟统计局指出,这些宏观经济数据并不等同于个人的富裕程度。尽管波兰的经济分量不断增加,但其人均GDP仍低于欧盟平均水平,不足欧盟标准的85%。这突显了一个国家的经济总量与居民实际生活水平之间的区别。
抱歉。
 在《沉默:一部文学史》(*Silence: A Literary History*)中,凯特·麦克劳林(Kate McLoughlin)探讨了沉默的多面性,内容涵盖从1918年停战协定等历史时刻,到围绕气候变化和跨性别身份的现代焦虑。麦克劳林将沉默划分为“创伤型”、“斯多葛型”和“快乐型”三种,尽管她的分析倾向于前两者,且往往强调沉默是抗议、绝望或政治压迫的工具。
这本书是一部内容广博、有时显得杂乱的文学与历史联想集。虽然麦克劳林巧妙地审视了莎士比亚《科里奥兰纳斯》(*Coriolanus*)中的“优雅沉默”或《冬天的故事》(*The Winter’s Tale*)中的奇迹复活等深刻时刻,但她偶尔也会将沉默的定义扩展至孤独或隐居。作者试图将不同人物纳入这一框架,这有时会导致矛盾;例如,她将玛格丽特·卡文迪什(Margaret Cavendish)称为“沉默的怪物”,尽管这位公爵夫人以其无法抑制的健谈而闻名。总的来说,这本书是一项范围广泛、有时让人应接不暇的研究,它主张沉默从不是中立的,而是一种复杂、不断变化的呈现,需要深入解读——无论它是官方的国家纪念仪式,还是安静而激进的反抗行为。
抱歉。
Zscaler ThreatLabz 近期的一份报告显示,勒索软件攻击者已不再进行无差别的攻击,而是利用针对性的“业务特权”来勒索赎金。研究人员通过分析 351 名受害者发现,攻击者将目标锁定在平均年龄 46 岁的中层管理人员,而非公司高管。 这些攻击者会进行广泛的侦察,以识别出有权影响财务和运营决策的人员,例如会计、人力资源和 IT 部门的员工。通过入侵这些中层管理人员,网络犯罪分子得以获取预算、供应商合同和支付审批系统的权限,从而有效地向公司施压,迫使其支付赎金。 该策略将“业务特权”——即授权交易或管理敏感数据的权力——置于传统的管理或技术访问权限之上。研究结果凸显了勒索软件生态系统中一个令人担忧的趋势:攻击者正日益专注于数据窃取和战略性勒索,而非单纯的加密。当勒索要求发出时,黑客往往已经摸清了组织的报告架构,以确保他们拥有足够的筹码来迫使受害者支付赎金。
抱歉。
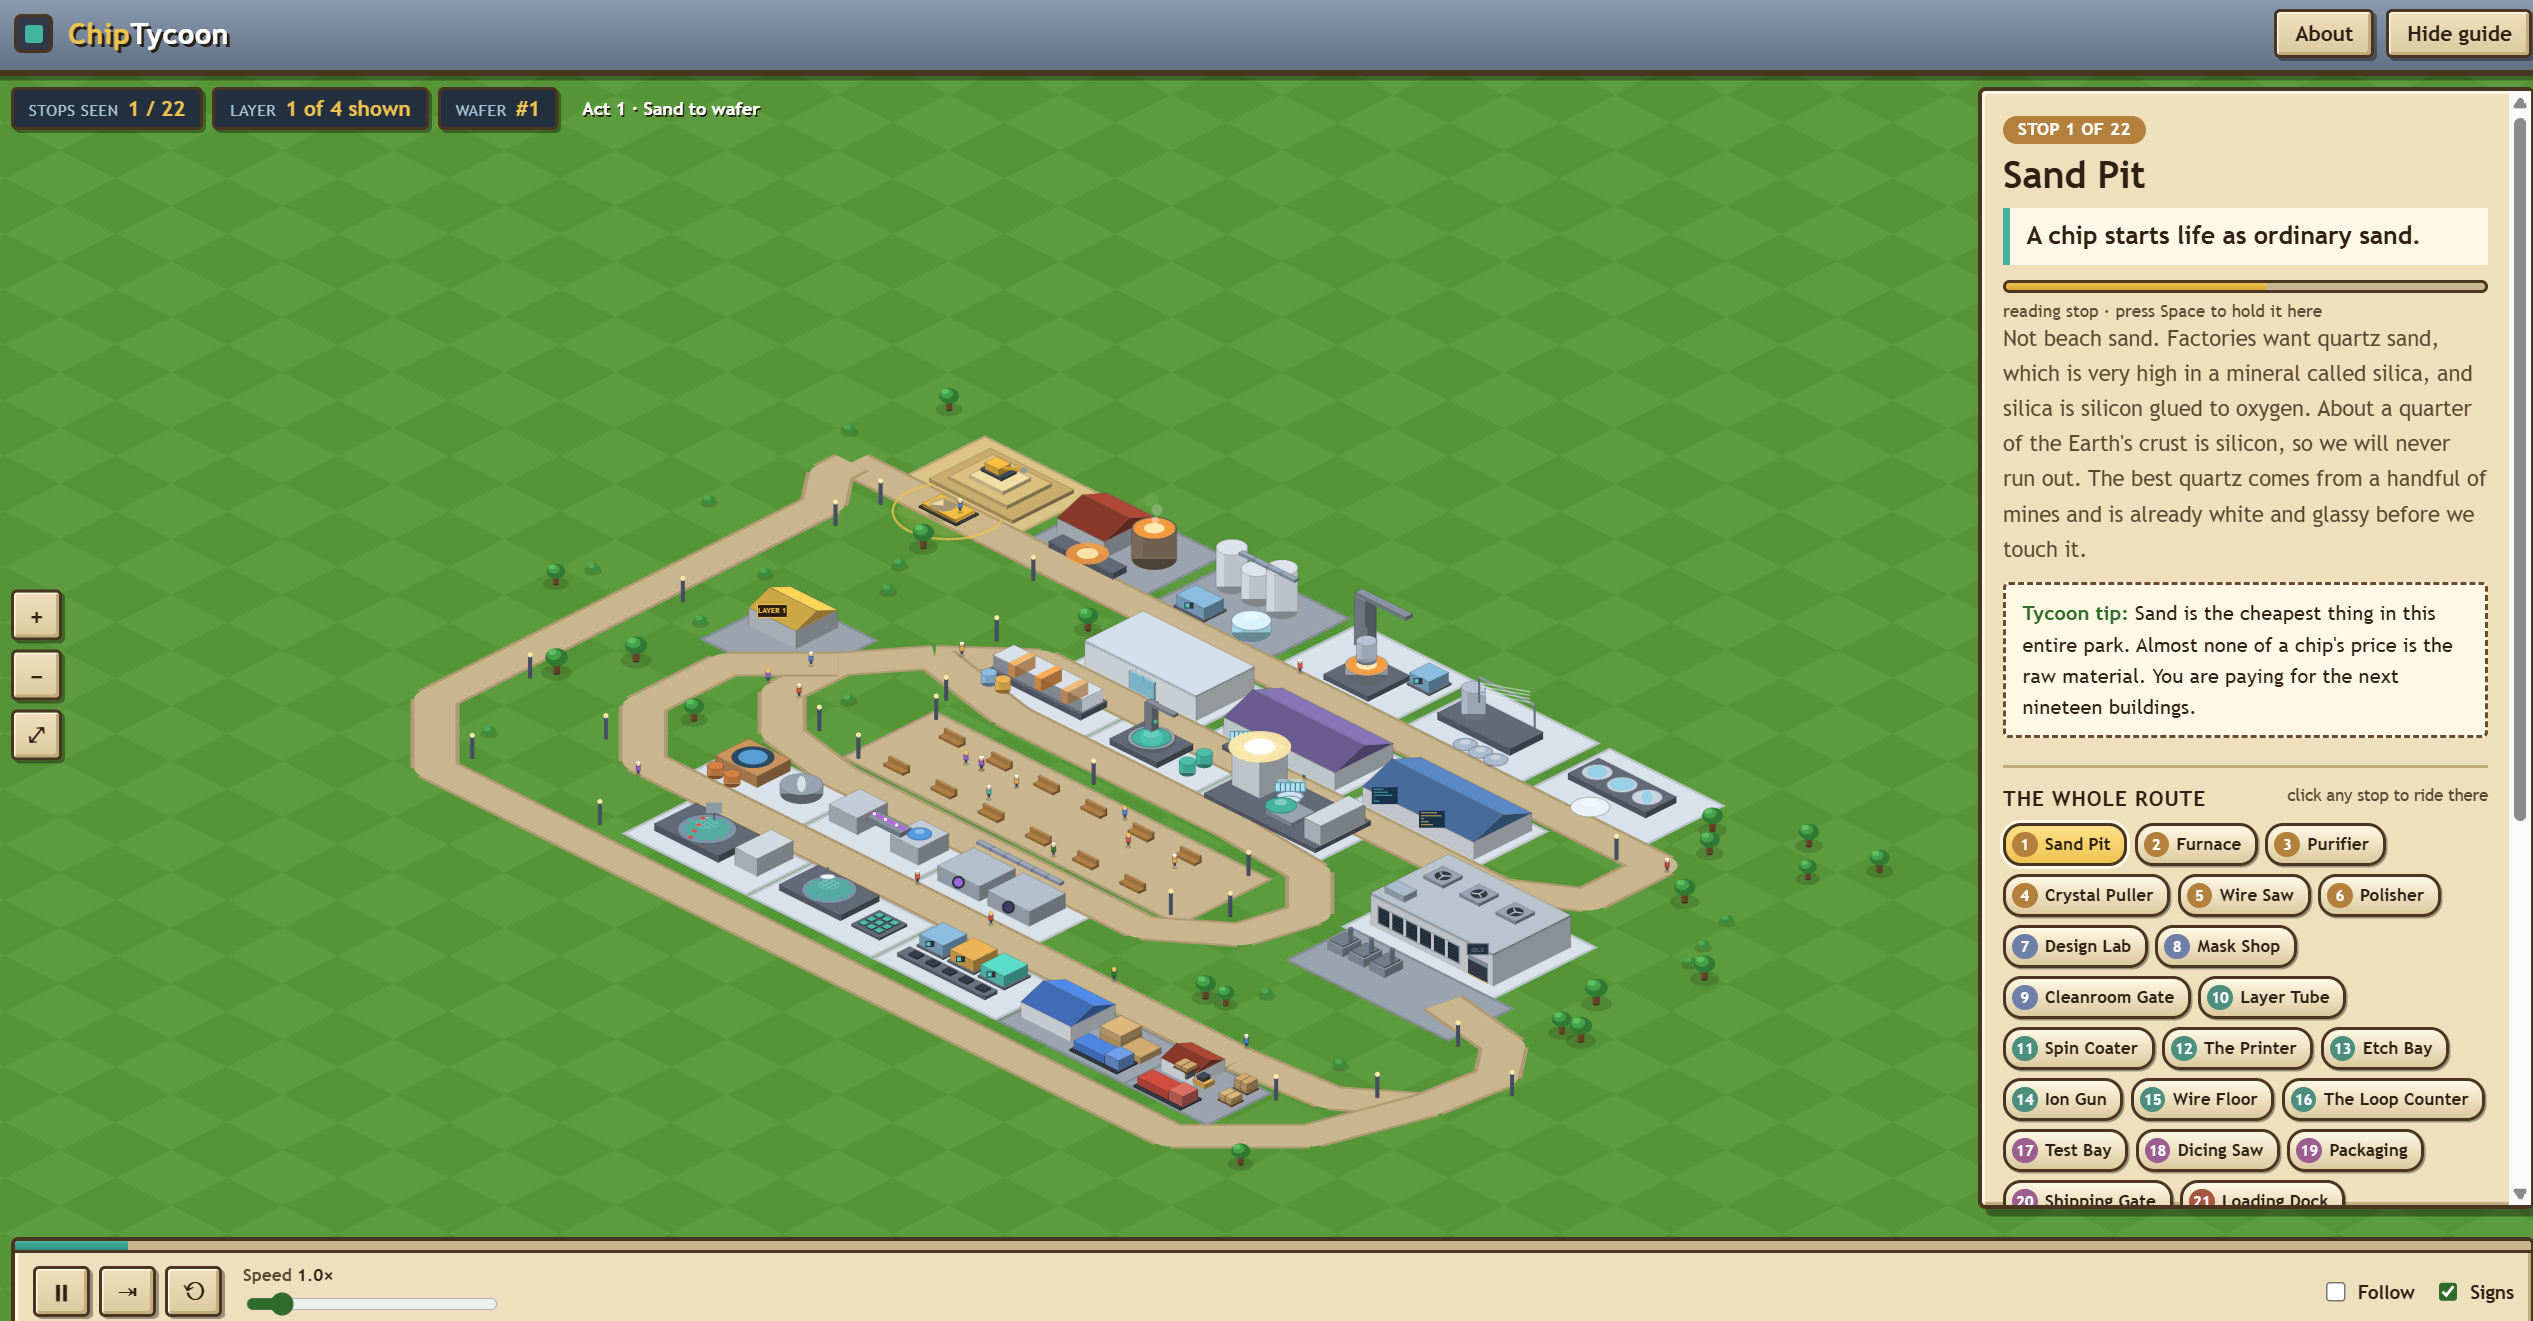 作者对 AI 生成文本那种简单且枯燥的特性感到不满,于是开发出了一种学习复杂技术主题的更有效方法:交互式模拟。
与阅读静态内容不同,作者利用大语言模型(LLM)编写“大亨类(Tycoon-style)”网页动画代码。该过程包括:
1. **建立基础知识**并核实其准确性。
2. **开发模拟程序**,将流程(例如芯片制造)可视化。
3. **通过 GitHub Pages 部署项目**。
这种方法通过作者的项目《ChipTycoon》得到了展示,它允许用户将抽象概念映射为视觉对象,从而显著提高记忆力。通过实时观察材料的转化过程,用户是在结构化的交互流程中进行学习,而非被动阅读。
为进一步完善该方法,作者建议引入 3D 对象映射以增强真实感,并加入解谜和知识测评等游戏化元素。这种“通过模拟进行学习”的框架,将复杂且晦涩的过程转化为直观、有趣的体验。
关于使用大语言模型(LLM)进行学习的 Hacker News 讨论揭示了两种截然不同的观点:支持者将其视为变革性的教育工具,而怀疑者则认为它们只是容易产生“幻觉”的“专业知识生成器”。
**支持 LLM 的观点:**
支持者强调“苏格拉底式教学法”——即利用 LLM 进行提问、引导推理并生成定制化测验,从而通过主动参与加深理解。许多用户认为 LLM 在阐明复杂的教科书概念、突破学习瓶颈以及制定个性化学习路径方面表现出色。一些人认为,将繁琐的研究工作交给人工智能,可以让他们更专注于高层架构设计和问题解决。
**反对 LLM 的观点:**
怀疑者认为,LLM 会营造一种“学习假象”(即“教育娱乐化”),而无法帮助学习者构建扎实的思维模型。一个主要担忧是缺乏可验证的“事实基础”;与经同行评审的教科书或经过审核的课程不同,LLM 生成的文本往往冗长、充满“噪音”,且容易一本正经地胡说八道。批评者指出,真正的精通需要经历钻研原始资料带来的“痛苦”挣扎,而人工智能绕过了这一过程。
**共识:**
大多数参与者一致认为,LLM 是“辅助工具,而非替代品”。它们最适合用于加速整合来自可靠教科书的信息,或在练习过程中提供反馈,前提是学习者必须始终保持对自身知识体系构建的主导权。