为了管理有状态工作负载,Oxide 需要一个容器存储接口(CSI)驱动程序来处理持久化存储的生命周期。最初,用户可以部署 Longhorn 等第三方解决方案;然而,在 Oxide 原生分布式存储之上叠加 Longhorn 的复制机制,会导致低效的写放大问题。虽然 Oxide 的“本地磁盘”通过消除冗余复制提供了一种临时变通方案,但它们缺乏 Oxide 分布式磁盘的持久性。 随后,团队开发了一个原生 CSI 插件(RFD 595),旨在允许 Kubernetes 直接管理 Oxide 分布式磁盘。该方案遇到了一个技术障碍:Oxide 的架构以往要求实例在挂载或卸载卷时必须处于停止状态,这与 Kubernetes 对无缝运行时存储管理的预期不符。 为解决这一问题,团队目前正在整个 Oxide 堆栈(从虚拟机管理程序到 API)中设计“磁盘热插拔”功能。尽管这一原生解决方案尚在积极开发中,客户目前仍可通过使用结合本地磁盘的 Longhorn 来高效地配置存储。一旦完成,原生 CSI 插件将实现无缝、高性能的持久化存储,并充分利用 Oxide 内置的分布式复制功能。
每日HackerNews RSS
Kubernetes on Oxide:客户需求如何塑造我们的集成 Kubernetes on Oxide: How customer needs shaped our integrations
78 天前
抱歉。
 “skitter-creek-bath-salts” 是一个研究项目,展示了如何通过操纵内存控制器(MCT/DCT)的物理地址转换层来绕过深层硬件安全保护。
现代系统构建了复杂的抽象层——如内存管理单元(MMU)、输入输出内存管理单元(IOMMU)以及各种安全区域(例如 AMD PSP、Intel SGX、TrustZone)——来“隔离”敏感内存。然而,这些保护机制是在内存控制器的上一层运作的。研究人员发现,通过位翻转(bit-flipping)内存控制器中的特定配置寄存器,可以“打乱”DRAM 寻址,从而创建绕过这些高层安全防线的“别名”。
由于内存控制器的转换是 GF(2) 中的线性映射,该项目利用 SMT 求解器(Z3)和线性代数来重构这些被扰乱的映射关系。这使得攻击者能够在不被 CPU 或固件检测到的情况下,访问、读取甚至修改受保护的区域,例如系统管理模式(SMM)内存、C6 空闲状态存储区,甚至是易失性微代码。
该漏洞利用了物理地址流水线是固定的这一基础架构假设。由于几乎所有现代架构(x86、ARM、RISC-V)都共享这种内存控制器结构,该研究表明,“锁定”的内存通常只是一个策略层,极易受到底层硬件重新配置的影响。
安全研究员 Christopher Domas (xoreaxeaxeax) 最近发布了一个名为“Spaghettifying DRAM”的项目,展示了一种通过操纵 DRAM 控制器寄存器来绕过内存保护的方法。
该漏洞针对较旧的 AMD 处理器(Family 16h),这些处理器中 DRAM 控制器的转换寄存器要么未公开,要么锁定不严。通过修改这些寄存器,拥有 Ring-0(内核)权限的攻击者可以重新映射物理内存,本质上是欺骗系统,从而暴露本应被隔离的受限区域,例如固件、安全隔离区或系统机密。
此项发布在 Hacker News 上引发了激烈讨论。尽管许多用户对该项目展现出的技术深度以及重获硬件控制权的“黑客精神”印象深刻,但其他人则对该项目的文档表示不满。批评者认为 README 文档充斥着“AI 垃圾内容”,包含了大量不准确、戏剧化的隐喻以及“Claude 式语言”,掩盖了技术细节。
尽管写作风格引发了争议,但社区普遍认同该漏洞作为一种底层研究强大工具的重要性,尽管它仅限于特定的旧硬件,且执行时需要预先获得内核级访问权限。
 Nine PBS 目前正努力挽回其 70 年的历史档案,此前其云存储服务商 Open Source Storage (OSS) 实际上已消失。今年早些时候,由于 OSS 停止运营且未回复有关合同续签的沟通,该电视台失去了对 50TB 数据的访问权限。
调查显示,OSS 一直通过 Iron Mountain 存储 Nine PBS 的数据。尽管科罗拉多州法院裁定 Nine PBS 拥有这些数据的所有权并下令进行转移,但 Iron Mountain 起初同意配合,随后却反悔,理由是与 OSS 在数据所有权方面存在潜在的法律冲突。这一僵局迫使 Nine PBS 起诉 Iron Mountain,以防止其档案被永久删除。
这种情况凸显了在没有足够本地备份的情况下依赖单一云供应商的风险。在 Nine PBS 通过法院命令寻求强制释放其数据的同时,这一事件也为各机构敲响了警钟,提醒它们必须采用多地冗余备份策略,以保护历史资产免受供应商破产的影响。
Hacker News
最新 | 往日 | 评论 | 提问 | 展示 | 招聘 | 提交
登录
[重复] PBS 因云存储供应商倒闭丢失 70 年电视历史资料 (tomshardware.com)
49 分,发布者:doener,1 天前 | 隐藏 | 往日 | 收藏 | 2 条评论
帮助
slyall 1 天前 [–]
来自昨天的 100 条评论
https://news.ycombinator.com/item?id=49285418
另外,只是其中一个站点,并非整个 PBS。
回复
tomhow 1 天前 | 父评论 [–]
评论已转移至该处。谢谢!
回复
指南 | 常见问题 | 列表 | API | 安全 | 法律 | 申请 YC | 联系
搜索:
 作者与德克萨斯州的布兰科河(Blanco River)有着深厚的个人情感联结,他将河流的分支结构视为一种普适模式,这种模式存在于从人体血管到城市交通网等万物之中。这些“运输网络”并非出自人为设计,而是通过混沌的地球地质演变过程,遵循着优雅的数学法则,高效地将物质汇聚向单一目的地。
这一认知的核心在于“分形”概念——即在不同尺度上重复出现的模式。作者强调了1957年的一项科学发现“哈克定律”(Hack’s Law),该定律量化了河流长度与流域面积之间的关系。约翰·哈克(John Hack)通过研究指出,无论地质条件如何,河流长度始终与流域面积的0.6次方成正比。
尽管地貌学家研究这类河流几何结构已逾百年,但混沌自然与普适数学秩序之间的相互作用,依然令人深感惊叹。河流将降水转化为连贯的排水系统,展现出一种简约而优美的规律性,暗示着物理世界背后存在着更深层的逻辑。
抱歉。
对于长时间运行的程序而言,内存管理至关重要。系统必须在回收未使用的内存以避免泄漏,与过早回收可能导致的数据损坏风险之间取得平衡。 内存管理主要有三种范式: 1. **垃圾回收 (GC):** 运行时环境(如 Go、Java)会跟踪存活对象并回收无法访问的内存。这减轻了开发者的负担,但由于需要进行图标记和指针追踪,会带来运行时的 CPU 开销。 2. **手动/编译器管理:** C 语言需要手动管理内存,而 Rust 则利用编译时验证来确保内存安全,无需 GC,从而将负担转移到了代码架构设计上。 3. **引用计数:** (如 Python、Swift)通过跟踪对象的引用进行管理。虽然有效,但在处理循环引用时较为困难,且每次指针复制都会产生开销。 GC 的成本主要取决于存活对象的数量及其互联性,而非内存总量。优化 GC 性能需要通过衡量 CPU 使用率、识别高分配的“抖动”路径以及分析存活对象的密度来实现。 对于大多数软件而言,GC 的效率足以应付,无需手动优化。然而,对于高吞吐量系统、有低延迟要求的应用或内存密集型服务,开发者应重点减少对象的频繁创建与销毁,并尽可能降低存活指针的数量,以提升性能。
关于垃圾回收(GC)成本的 Hacker News 讨论主要集中在自动内存管理与手动控制之间的权衡。
主要观点包括:
* **成本的复杂性**:参与者讨论了 GC 的“成本”,指出这不仅仅涉及 CPU 周期。虽然追踪式 GC 提供了快速分配(主线程上的零成本释放),但它们在追踪和“停顿(stop-the-world)”方面需要大量额外开销。
* **分代 GC**:评论者明确指出,现代分代 GC 比全堆扫描更高效,但它需要额外的簿记工作(如写屏障)来追踪从旧对象到新对象的指针。
* **“手动”的连续性**:许多人认为内存管理存在于一个连续谱上,而非二元选择。即使在游戏引擎等重度依赖 GC 的环境中,也经常混合使用区域分配(arena allocation)、引用计数和对象池等技术来优化性能。
* **Rust 与 GC**:讨论中很大一部分突出了 Rust 的内存安全方案。支持者认为它能促成更好的架构设计,而怀疑者则指出其严格的生命周期规则有时会使某些复杂数据结构的实现变得困难,从而导致一些人更倾向于自动管理的灵活性。
幽暗草莓 Gloomberb
78 天前
研究公司 报价、图表、财务数据、备案文件、持股人、内部人士、期权、分析师评级、活动及相对估值。 追踪市场 热门报道、突发新闻、行业动态、全球指数、外汇、宏观事件、收益率曲线、涨跌幅榜及市场情绪。 运行工作区 投资组合、自选列表、券商连接、提醒、笔记、AI 筛选器、预测市场及 Gloom Cloud 聊天。
arXivLabs 是一个允许合作者直接在我们的网站上开发并分享 arXiv 新功能的框架。与 arXivLabs 合作的个人和组织都秉持并认可我们对于开放、社区、卓越和用户数据隐私的价值观。arXiv 致力于坚守这些价值观,并仅与遵守这些价值观的合作伙伴开展合作。您是否有能为 arXiv 社区增值的项目想法?了解更多关于 arXivLabs 的信息。
关于论文《是时候向前看了:在没有 Null 和 Bag 的情况下进行查询》(Time to Move On: Querying Without Nulls and Bags)的 Hacker News 讨论,聚焦于用数学上更严谨的查询语言取代 SQL 的可行性。
批评者认为,论文中消除“Bag”(多重集)的提议并不切实际。他们主张,现实世界的数据通常需要处理重复记录,强行采用“仅集合”模型会带来不必要的开销或数据处理负担。相反,一些参与者支持转向基于集合的逻辑,认为这能提高一致性,并消除 SQL 当前方法所带来的语义陷阱。
除了技术层面的争论外,讨论还强调了任何 SQL 继任者所面临的巨大进入壁垒。SQL 在行业标准、工具链和开发者思维中已根深蒂固。大多数评论者认同,尽管 SQL 在客观上存在缺陷且过于复杂,但其普及性使其成为了事实上的标准。像“Rel”这样的继任语言或许能提供更优越的语义纯度,但它们面临着来自现有生态系统惯性、数据库互操作性难题,以及程序员对 SQL 熟悉度所带来的高实用价值等方面的严峻挑战。
请启用 JavaScript 和 Cookie 以继续。
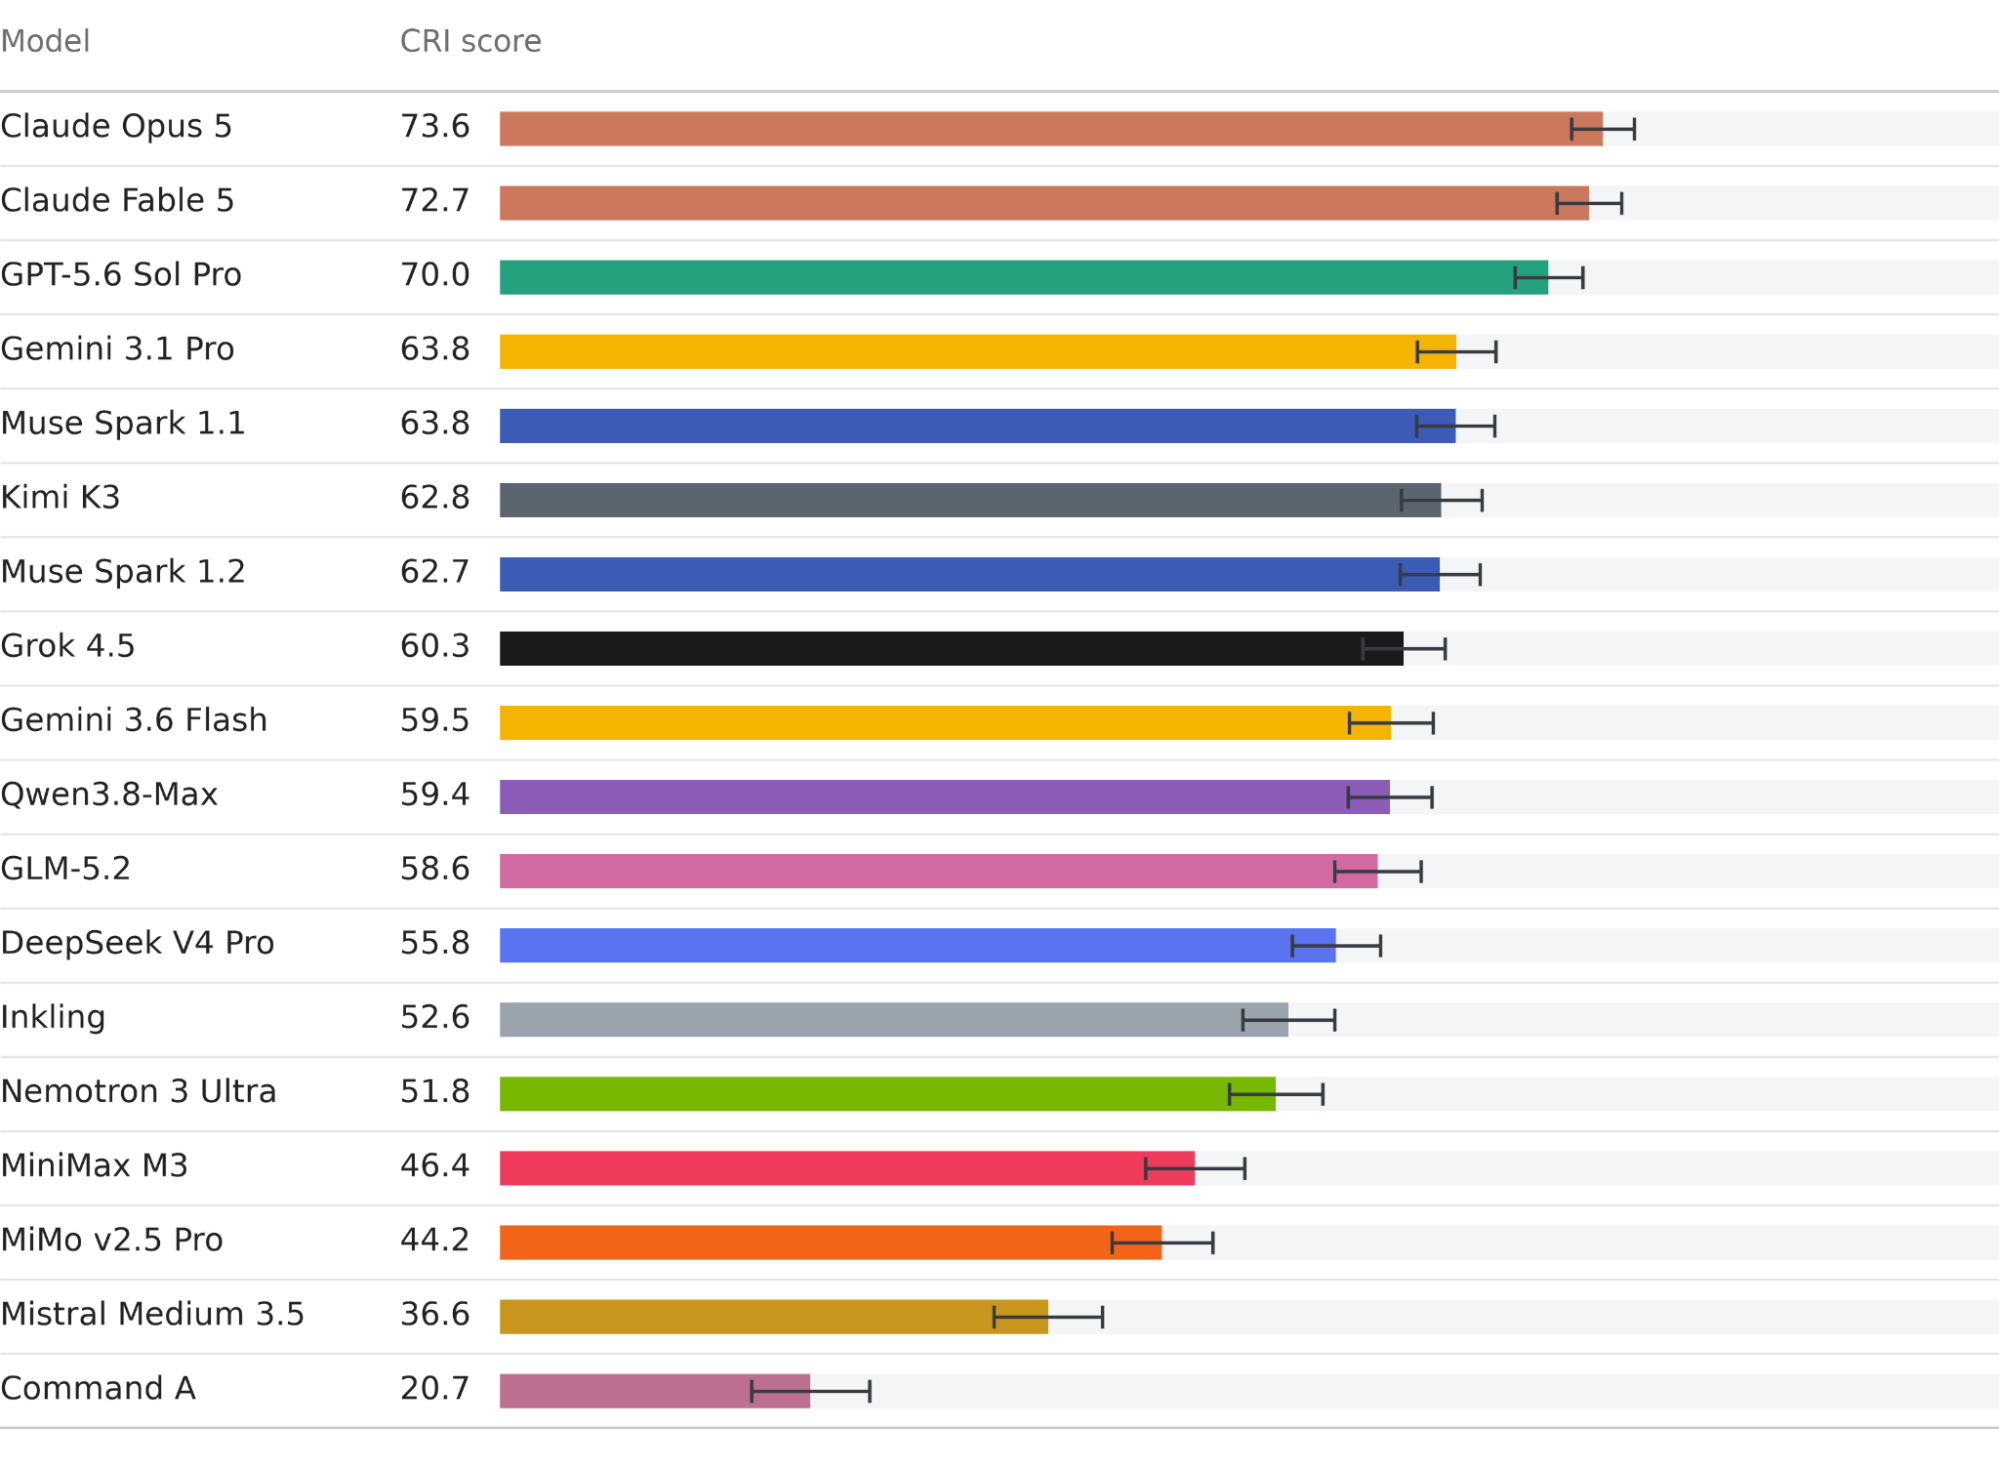 来自 Redwood Research 和 Anthropic 的研究人员引入了**概念推理指数(CRI)**,旨在衡量人工智能模型处理“概念推理”的能力,即在缺乏实证反馈或客观真理的情况下(如人工智能安全、哲学和长期治理等领域)进行复杂问题推理的能力。
研究人员认为,由于风险缓解的人工智能开发需要对无法立即验证的场景进行推理,当前的实证训练方法已不足以应对。为此,他们开发了三个基准测试:
* **LMCA**:评估模型针对专家评定数据集判断概念论证质量的能力。
* **ACCoRD**:衡量模型信念和概率估计的逻辑一致性。
* **DTBench**:测试决策论推理,特别是关于自我预测及与其他智能体交互的能力。
整合进 CRI 的这些基准测试显示,尽管模型性能自 2024 年以来呈线性提升,但顶级模型仍显著低于人类专家估计的上限。研究团队旨在利用 CRI 来追踪这一人工智能安全关键领域的发展进程。更多详细信息和实时性能数据请访问 **conceptualreasoning.ai**。
Hacker News 社区对 Anthropic 发布“概念推理指数”(Conceptual Reasoning Index)的反应相当冷淡,甚至充满怀疑。主要的批评点在于明显的利益冲突:该基准测试由 Anthropic 自行开发并资助,其结论显示他们自家的模型(特别是 Claude 3 Opus)表现最为出色。
用户大多将此指数斥为“营销垃圾”,并将其比作“奥巴马给自己颁奖”的梗。许多评论者表示,他们不信任由 AI 实验室自行创建的专有基准测试,认为这类指标容易出现“挑选数据”或“过度优化”的问题。
除了对指数可信度的质疑外,讨论还涉及了有关 AI 安全的深层忧虑。怀疑论者挑战了“应由 AI 作为审计自身行为的主要工具”这一前提,警告称这种方法会形成一种危险的自我验证闭环。一些用户表达了对行业现状的沮丧,指出尽管他们在工作中依赖这些工具,但对 Anthropic 等公司利用“生存风险”叙事来为其内部监管正名的做法感到日益愤世嫉俗;许多人认为,这可能是一种巩固权力或逃避外部实质性监管的手段。
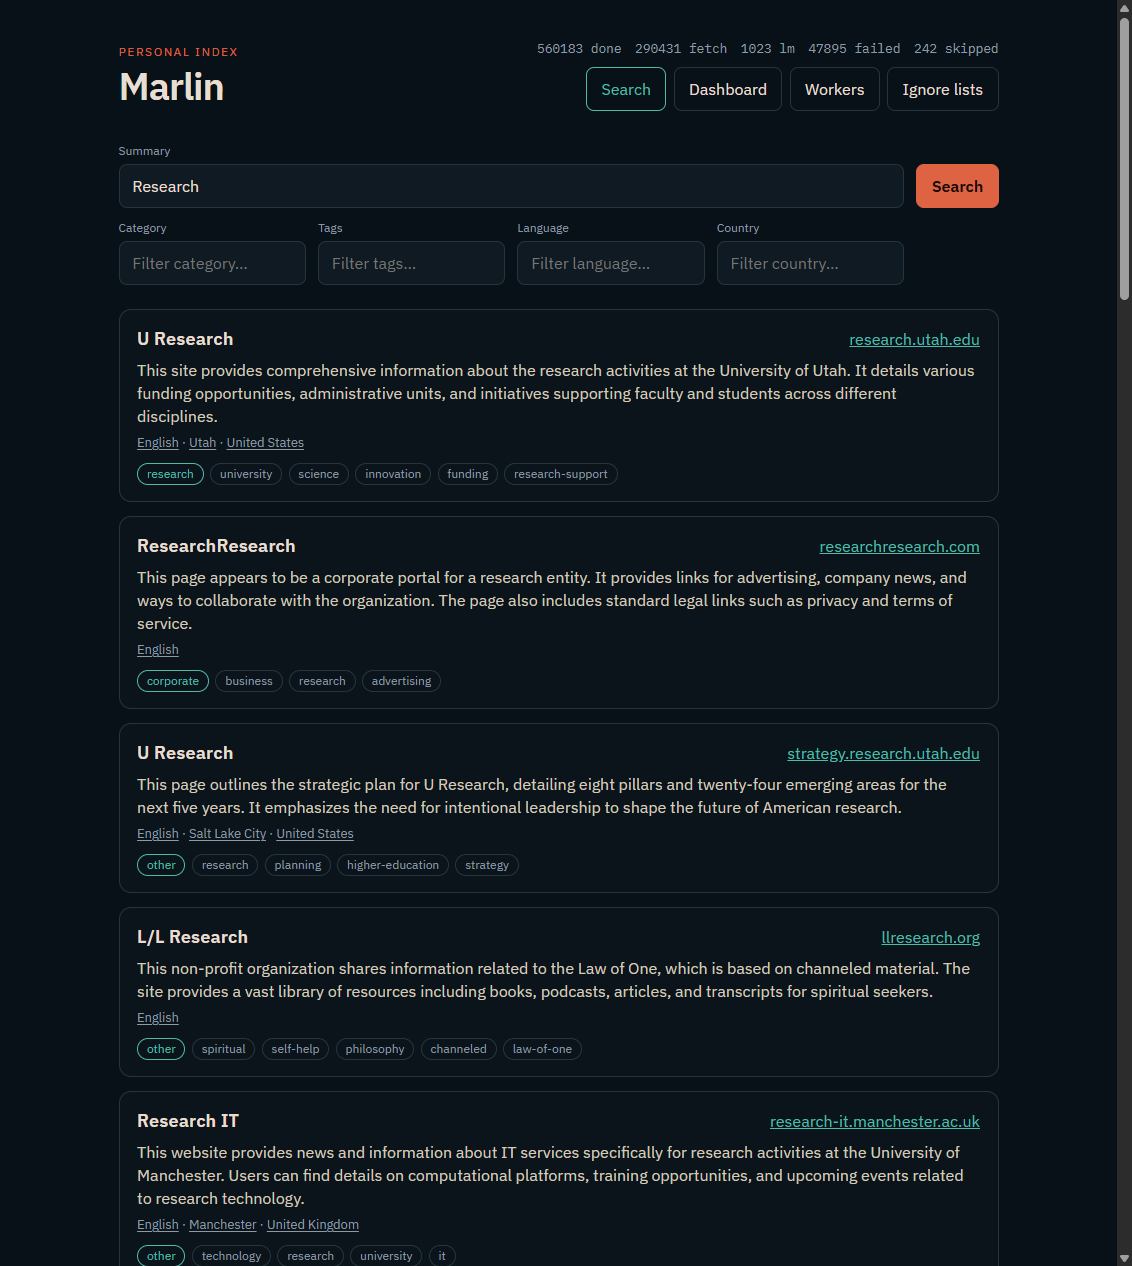 出于对充斥着SEO内容的搜索引擎的沮丧,作者利用一个周末构建了一个专注于杂志、艺术项目和独立软件的个人搜索索引。通过大约10美元的GPU租赁费用和简单的架构,他们成功编目了超过56万个域名。
该项目使用了一个忽略JavaScript并仅专注于主页的爬虫。本地AI模型(Gemma 4B)负责总结页面内容,同时作者通过优先处理“作品集”或“软件”等特定类别,并降低企业文档的权重,来动态引导抓取过程。他们还实施了“管理”流程来自动屏蔽垃圾信息,并设置上限以防止Tumblr等大型平台主导索引。
主要经验包括:
* **效率:** 将抓取器与总结器分离,以及本地化处理,使成本保持在较低水平。
* **策展:** 实时调整队列权重比预设规则更有效。
* **挑战:** 让AI“自由发挥”进行分类导致数据混乱,而无法渲染JavaScript的网站仍然是一个障碍。
最终,作者证明了一个高质量、个性化的搜索索引是一个可行的周末项目,它为现代由企业主导的网络提供了一种经过精心筛选的替代方案。该项目代码“Marlin”现已开源,供那些想要构建自己索引的人使用。
一位 Hacker News 用户最近分享了一个项目:他仅用一个周末的时间,花费 10 美元就构建了一个包含 50 万个域名的搜索引擎。通过租用强大的 GPU,他利用本地大语言模型(LLM)来抓取网站、生成标签并对内容进行分类,从而高效地创建了一个精选的小型搜索索引。
该项目在 Hacker News 上引发了激烈争议。支持者称赞这一举措是重新探索互联网的创新方式,并指出在现代硬件的支持下,构建个人搜索引擎已变得非常容易。他们将其视为一种优先考虑高质量内容、摒弃企业臃肿信息的“个人”探索工具。
然而,许多批评者将该项目斥为“AI 垃圾”。他们认为,过度依赖大模型进行内容生成和分类会导致产出低质量且不可靠,迫使用户承担核实信息的负担。怀疑论者质疑,与成熟的搜索引擎相比,这样一个规模有限且未经核实的索引到底有什么实用价值。还有人批评作者用“周末项目”来包装,认为这种人工智能驱动的捷径贬低了人类精工细作的价值。归根结底,这场讨论凸显了科技界在处理自动化大模型管道生成的内容时,对于其实用性与“廉价感”之间日益增长的矛盾。