
每日HackerNews RSS
抱歉。
如果特斯拉的无人驾驶出租车队能盈利,他们是不会卖给你的。 If a Tesla Cybercab fleet were profitable, Tesla wouldn't sell you one
45 天前
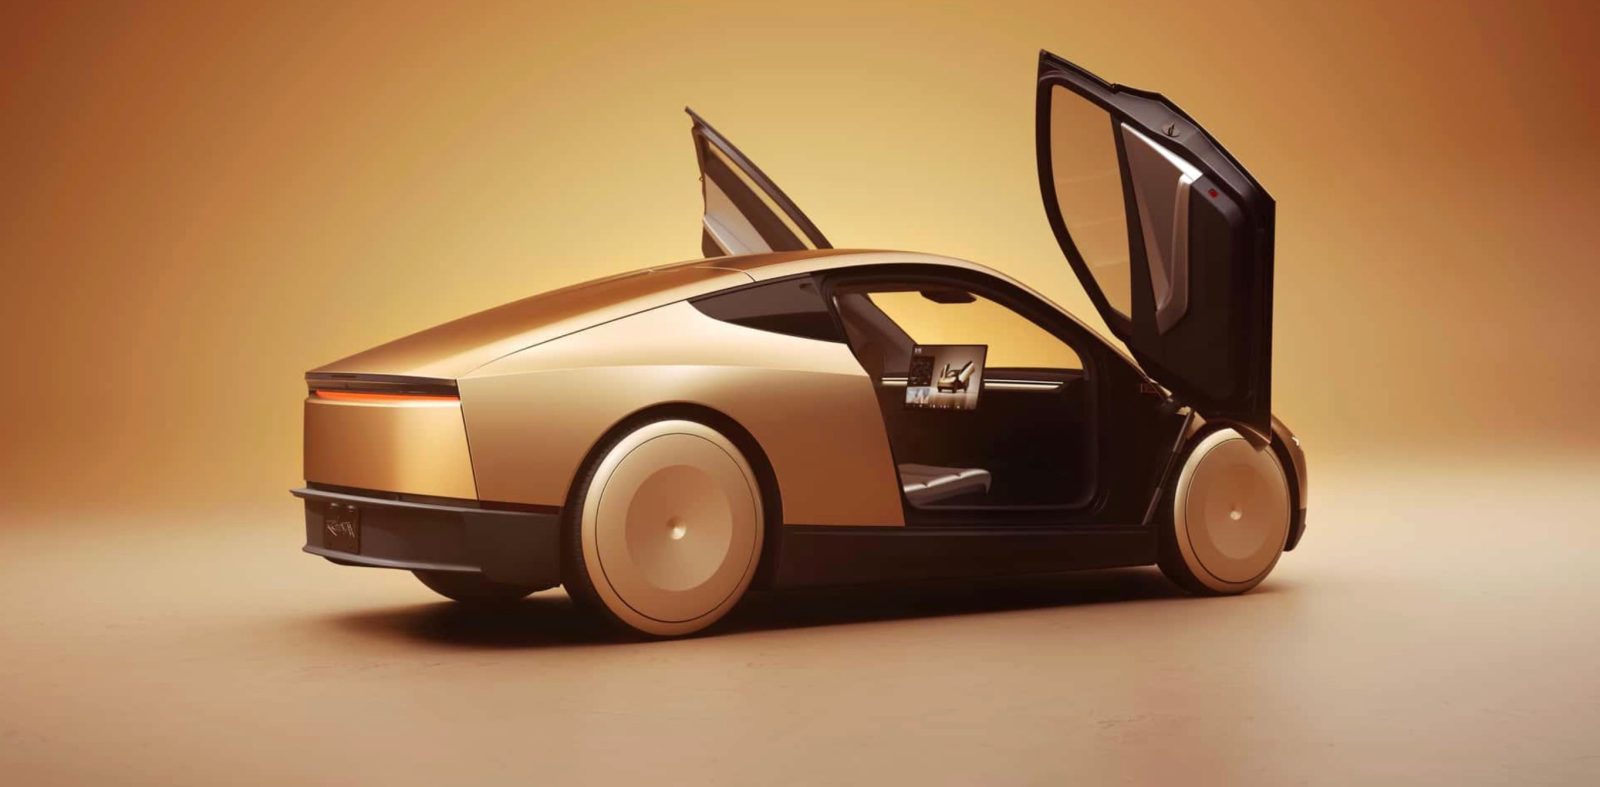 特斯拉再次向企业推销购买并运营“Cybercab”自动驾驶出租车车队的商机,并承诺提供丰厚的被动收入。然而,这与2019年那项从未实现的失败承诺如出一辙,当时导致早期投资者及如MisterGreen等公司蒙受了巨额财务损失,甚至导致后者破产。
问题的核心在于逻辑上的不一致:如果Cybercab真的是能够每年产生巨额利润的“印钞机”,特斯拉大可将整个车队留给自己运营,而非将其出售给外部买家。通过将这些车辆转嫁给第三方,特斯拉成功地将高昂的资本成本和资产折旧风险转移到了买家身上,同时继续掌控软件、网络及服务费用。
在这种安排下,买家承担了整个项目的财务风险,而该项目却完全由特斯拉掌控。特斯拉随时拥有削减价格、优先调度自家车辆或更改收益分配比例的权力。归根结底,Cybercab的推销策略是一种“轻资产”手段,旨在通过转嫁风险来保护特斯拉的利润空间。这再次证明:如果一个商业机会看起来好得不切实际,那它很可能就是个陷阱。
在2003年1月的一封电子邮件中,比尔·盖茨表达了对微软用户体验的强烈不满,并详述了他下载Windows Movie Maker和Plus!软件包失败的经历。他形容微软官网“慢得可怜”且“无法使用”,并指出整个下载过程就像一个无法破解的谜题。盖茨批评了Windows更新过程中复杂的多步骤操作、“添加/删除程序”列表中充斥着测试文件的混乱状况,以及重复且易出错的数据录入表格。他总结道,公司对易用性的漠视简直“令人震惊”。 这封邮件引发了微软高管层内部的紧急应对,以解决这些系统性问题。随后的邮件往来揭示了一家在组织孤岛中挣扎的公司:领导层争论着究竟该由市场部门还是工程部门来“负责”用户体验。内部批评指出,更新流程过于僵化、令人困惑,并且在关键补丁的标注上使用了“令人恐惧”的用词。归根结底,这次交流凸显了公司在优先考虑统一、以用户为中心的下载与安装体验上的普遍缺失;开发者们也承认,当时的流程确实是一团“乱麻”,需要立即但缺乏协调的改进。
在这篇关于其具有深远影响的“数据流模型”(Dataflow Model)论文的回顾中,作者 Akidau 等人反思了流式分析领域的十年历程。虽然该论文准确地识别了向无界、乱序数据转变的趋势,并确立了事件时间和强一致性的重要性,但作者们也承认其中存在重大的概念性错误。 他们认为,自己过分强调了流处理的机制(特别是窗口和触发器),而牺牲了更简单、更稳健的数据库式抽象。作者们现在认识到,“流与表”的二分法是伪命题;流和表仅仅是同一数据的不同访问表现形式。业界向 SQL、增量视图维护和物化视图的转变证明,其目标本应是屏蔽流处理的复杂性,而非将其暴露出来。 最终,作者们得出结论:最成功的流处理范式是那些对用户配置要求最低的范式。他们认为,流处理的未来在于将这些原则整合到标准数据库模型中,不再将流处理视为一种独立的范式,而是将其作为一种保持数据新鲜度的专业化机制。
围绕《重访数据流模型》的讨论揭示了业界资深人士的一个共识:专用的流处理模型在很大程度上未能成为通用分析的主流。尽管流处理曾被视为实现高吞吐量、低延迟系统的理想范式,但专家们如今一致认为,SQL 依然是更优越的抽象。
这种转变源于两个事实:首先,大多数公司实际上并不需要真正的低延迟处理;其次,与批处理系统相比,流处理系统的运维复杂且成本高昂。随着现代数据仓库实现了足够快的数据摄取速度,维持复杂、有状态流架构的理由已不复存在。
行业领袖越来越倾向于将流处理视为数据库底层的实现细节,而非面向终端用户的独立编程模型。未来可能属于“增量维护的物化视图”,即数据流技术的核心优势——如数据完整性标记和避免重复计算——被集成到标准的批处理系统中。虽然流处理对于特定的超大规模问题仍是一种有价值的架构选择,但趋势正在从定制化的流处理语言转向以 SQL 为核心的统一模型,从而将运维的复杂性对用户屏蔽。
必应壁纸展示《哈利·波特》与《神奇动物》系列电影套装广告 Bing Wallpaper showing Ad for Harry Potter and Fantastic beasts box set
45 天前
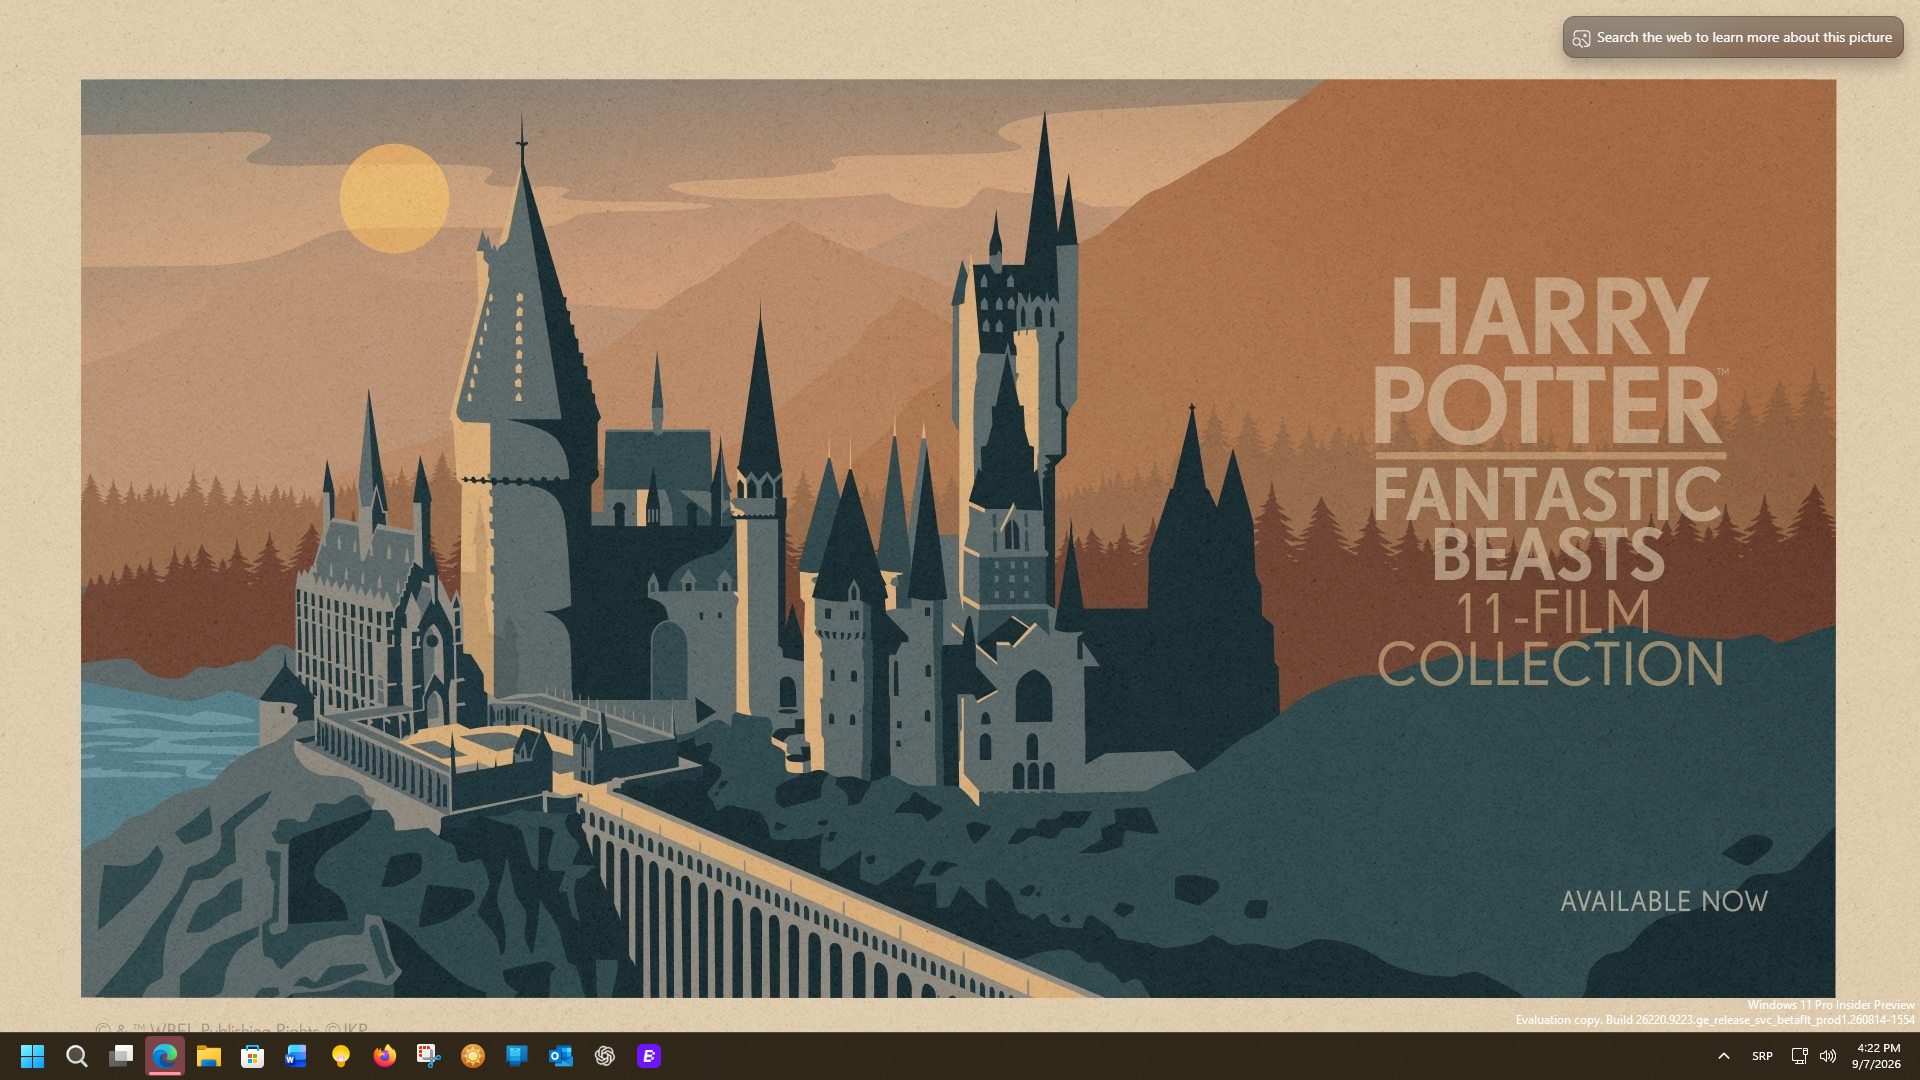 我使用必应壁纸已经很多年了,一直很愉快。但今天我第一次发现壁纸的位置竟然出现了一个广告。这种变着法子收费的行为简直不可理喻。这用户体验太糟糕了,直接占据了整个屏幕,让我一度以为自己安装了什么流氓软件或恶意程序。
抱歉。
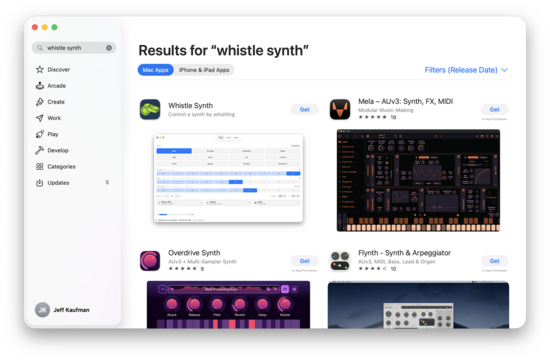 一位开发者发布了一款免费的开源 Mac 应用,允许用户通过吹口哨来控制合成器。通过利用人工智能重构代码库,开发者成功将音频延迟从 80 毫秒降低至仅 5 毫秒,并消除了性能卡顿。
该应用包含多种新音色,包括“无八度”贝斯和拉杆风琴,这些都是通过与 AI 的反复协作开发出来的。开发者还增加了一个五度音程设置,以扩展口哨的音域。虽然开发者在使用 AI 设计长笛和电钢琴等复杂高音音色时遇到了一些挑战,但他们成功利用 AI 完成了 Mac App Store 的提交流程,包括图标设计和行政要求。
该项目证明了 AI 辅助开发的价值,使开发者能够升级并发布一个原本无法实现的热门项目。建议用户配合外接麦克风和有线耳机使用,以获得最佳体验。
 在这篇文章中,作者挑战了将“小”与“简单”混为一谈的普遍观点。他指出,Unix 哲学虽然推崇小巧、模块化的工具,但这些工具往往高度耦合且逻辑复杂。作者以词频计算为例,说明了 Unix 管道(pipelines)由于强制将聚合与排序紧密交织在一起,反而迫使开发者采用了复杂的变通方案。
作者引用 Rich Hickey 对“简单”的定义(即“未交织”或解耦),强调真正的简单在于关注点的分离。尽管小程序在资源受限的环境中很有用,但它们往往缺乏大型、复杂系统所具备的灵活性。相比之下,那些具备良好解耦特性的系统——例如 Clojure 将类型检查与数据表示分离的方法,或是 SQL 的声明式本质——则更为优越。
作者总结道,虽然实现这种程度的解耦通常需要高难度的工程投入,但其回报是更易于维护和扩展的系统。归根结底,开发者应追求构建“简单”而非仅仅是“小”的程序,通过识别并消除不必要的隐性依赖,从而创建稳健、灵活且真正解耦的架构。
抱歉。
bzip3 bzip3
45 天前
 BZip3 是 BZip2 的高性能继任者,专为压缩文本和代码而优化。它采用了先进的架构,结合了上下文混合熵编码器、基于快速后缀数组的 Burrows-Wheeler 变换,以及混合 LZ77/PPM 式的压缩方法。
基准测试表明,BZip3 在实现更高压缩比的同时,还能保持快速的并行解压速度,其性能经常超越其前身以及 XZ 和 Zstandard 等竞争对手。如果结合 `lrzip` 等长距离去重工具,BZip3 可以达到出色的压缩效果。
该软件可通过标准构建流程或系统软件包管理器(如 Homebrew)获取。尽管 BZip3 已在各种架构上经过广泛测试,但作者仍针对数据完整性提供了标准免责声明,指出算法的复杂性使得无法 100% 排除罕见边界情况错误的可能性。BZip3 在 LGPLv3 许可下发布,并包含来自不同贡献者的模块化组件,其中包括用于 BWT 构建的 `libsais` 库。鼓励用户查阅随附文档,以获取完整的基准测试细节和针对特定架构的性能预期。
抱歉。
请启用 JavaScript 和 Cookie 以继续。
这篇 Hacker News 的讨论反映了人们对《经济学人》关于“人工智能对就业的净影响是积极的”这一主张持深切怀疑态度。尽管文章提到新增了 100 万个与人工智能相关的岗位(主要集中在数据中心基础设施领域),但评论者认为,这一数字掩盖了高质量“知识型工作”的减少。
讨论中出现了几个反复出现的主题:
* **工作质量差距:** 批评者认为,软件和法律领域的高薪职位正被不稳定的、低薪的或临时性的基础设施及蓝领岗位所取代。
* **市场扭曲:** 许多用户将“人工智能带来的就业增长”视为风险投资补贴下的短期产物或“人工智能洗白”,而非真正的、可持续的商业价值。多位参与者描述了一个停滞的就业市场,其中的招聘需求往往被视为“虚假”的或毫无回音的。
* **基础设施的可持续性:** 关于大规模数据中心建设究竟是永久性的经济转型,还是终将破裂并导致工人失业的短期泡沫,存在着重大争议。
* **对生产力的怀疑:** 许多开发人员报告称,人工智能工具增加了代码冗余和管理负担,而非实际产出,这加剧了他们对企业强制推行人工智能政策的不满。
最终,舆论倾向于深度的悲观,许多人将该文章视为与严峻就业市场现实脱节的“企业宣传”。
 回顾自己的软件工程师生涯,作者指出,尽管专业效率有所提高,但思维的敏锐度却有所下降。随着时间的推移,工作的新鲜感逐渐消退,取而代之的是不断的数字干扰、刷屏成瘾以及深度阅读习惯的丧失。他形容自己与年轻时那个勤奋好学的自己相比,感到一种“思维上的懒惰”。
为了寻求重置,作者最近在乡村度过了一个假期,切断了与日常生活的联系。这次“慢旅行”成为一个转折点;他重新发现了阅读的乐趣——两周内读完了四本书,并意外地重燃了对数学和物理的热情。
他不再满足于被动的信息获取,而是开始主动学习微积分和物理,这一过程让他回想起当初学习编程时的喜悦。尽管他不确定这些兴趣将如何与人工智能主导的科技领域交汇,但这种追求为他提供了目标感。通过以严谨的学习替代无意识的习惯,他成功找回了思维的参与感,并在纯粹的学习行为中找到了满足感。
这次 Hacker News 上的讨论探讨了“大脑腐坏”(brain rot)的感觉——即认知清晰度、注意力跨度以及深度思考能力的下降。许多人认为这是持续的数字刺激以及将脑力活动外包给人工智能和移动设备所导致的。
参与者将其比作“体力活动转型”:体力劳动消失并被久坐的生活方式所取代,从而催生了现代的“健身房”文化。他们认为我们现在正处于“脑力活动转型”之中,环境中的脑力活动已被剥离,导致人们尽管在持续消费信息,却反而感到精疲力竭。
**“摆脱大脑腐坏”的关键策略包括:**
* **拥抱无聊:** 在等待或旅行时,不再立即消费内容,而是学会与自己的思绪共处。
* **模拟爱好:** 参与需要物理、实际投入的活动,如园艺、演奏乐器、木工或修理物品,以建立认知耐力。
* **刻意制造阻碍:** 选择低科技替代方案,例如阅读纸质书或使用“功能机”,以打破算法推送带来的多巴胺奖励循环。
* **独处:** 创造“离线”环境来重置大脑,切断与数字空间中无处不在的“他人思维”的连接。