 现在,你可以通过现代化的 Docker 设置来运行 2001 年的经典论坛程序 **phpBB 1.4.4**,重温早期的互联网时光。
该软件设计于 PHP 3 和 `register_globals` 的时代,最初缺乏现代安全标准(例如 SQL 注入防护)。为了使其能在当代环境中运行,所提供的 Docker 存储库包含了必要的补丁,以解决 PHP 5 的兼容性问题、数据库初始化错误以及 Cookie 处理方面的异常。
尽管年代久远,该脚本依然具备令人熟悉的各项功能,包括多种主题、BBCode、表情符号以及基础的管理工具。
**警告:** 该软件以现代标准衡量极度不安全,**严禁将其用于面向公众的服务器。** 它仅供怀旧体验或本地测试使用。你可以使用 `docker-compose` 快速部署,请务必保护好 `config.php` 文件,并在安装完成后立即删除安装脚本。访问[源代码仓库](https://github.com/lordfeck/phpBB-1.4.4-Docker),重温论坛时代早期的“光辉岁月”。
每日HackerNews RSS
抱歉。
请启用 JavaScript 和 Cookie 以继续。
抱歉。
该项目展示了一种实时、非真实感的渲染技术,能够从 3D 模型生成手绘风格的钢笔墨水插图。该系统受 Francis、Apéry 和 Hilbert–Cohn-Vossen 的经典美学启发,利用程序化线条而非基于像素的着色器来渲染平滑曲面。 核心技术特性包括: * **轮廓渲染:** 提取轮廓线和双曲线作为平滑链,并将其渲染为带有锥度且具手绘抖动感的带状线条。通过 GPU 加速的隐藏线消除和“光晕”效果来管理可见性。 * **阴影排线:** 通过与主曲率方向对齐的流线来表现色调,并利用嵌套密度实现交叉排线。这些笔触在构建时生成,确保其固定在物体几何体上。 * **艺术风格化:** 系统融合了手工调整的效果,如墨水积聚、边缘晕染和轻微的笔触溢出,以模拟实体媒介的自然质感。 该实现借鉴了计算机图形学的基础研究——从 20 世纪 70 年代的隐藏线算法到现代非真实感渲染流程——从而提供了一种对复杂几何曲面进行交互式、速写般的探索方式。用户可以实时操作模型,标签和深度提示会动态更新,以保持视觉清晰度。
抱歉。
 若要使用 Mastodon 网络应用,请启用 JavaScript。或者,也可以尝试适用于您平台的 Mastodon 原生应用。
本次讨论聚焦于陶哲轩对人工智能驱动的“解题提取”威胁数学研究未来的批判。
**核心观点包括:**
* **“过程”的丧失:** 数学家认为问题的价值在于探索过程——即在此过程中所获得的洞见、失败的尝试以及概念间的联系。人工智能生成的证明往往“难以解读”,它们提供了答案,却缺乏推动未来发现的潜在直觉。
* **生态系统风险:** 重要难题是支撑学科发展的“大树”。如果人工智能公司仅为了营销或声望而迅速“砍伐”这些难题,可能会导致数学界失去培养下一代研究人员和发展新数学框架所需的挑战。
* **机构保密性:** 批评者强调了人工智能实验室的掠夺性,它们可能会利用专利数据或监控研究讨论,来“抢先”获取那些即将取得突破的数学家的成果。这促使人们回归到秘密的、行会式的做法,从而逆转了几个世纪以来的开放科学传统。
* **学科的未来:** 一些参与者认为,数学必须演变为“大科学”,从关注个人声望转向大规模、协调一致的努力。另一些人则担心,人工智能的统治地位会导致智力停滞,使人类无法理解自己所依赖的系统。
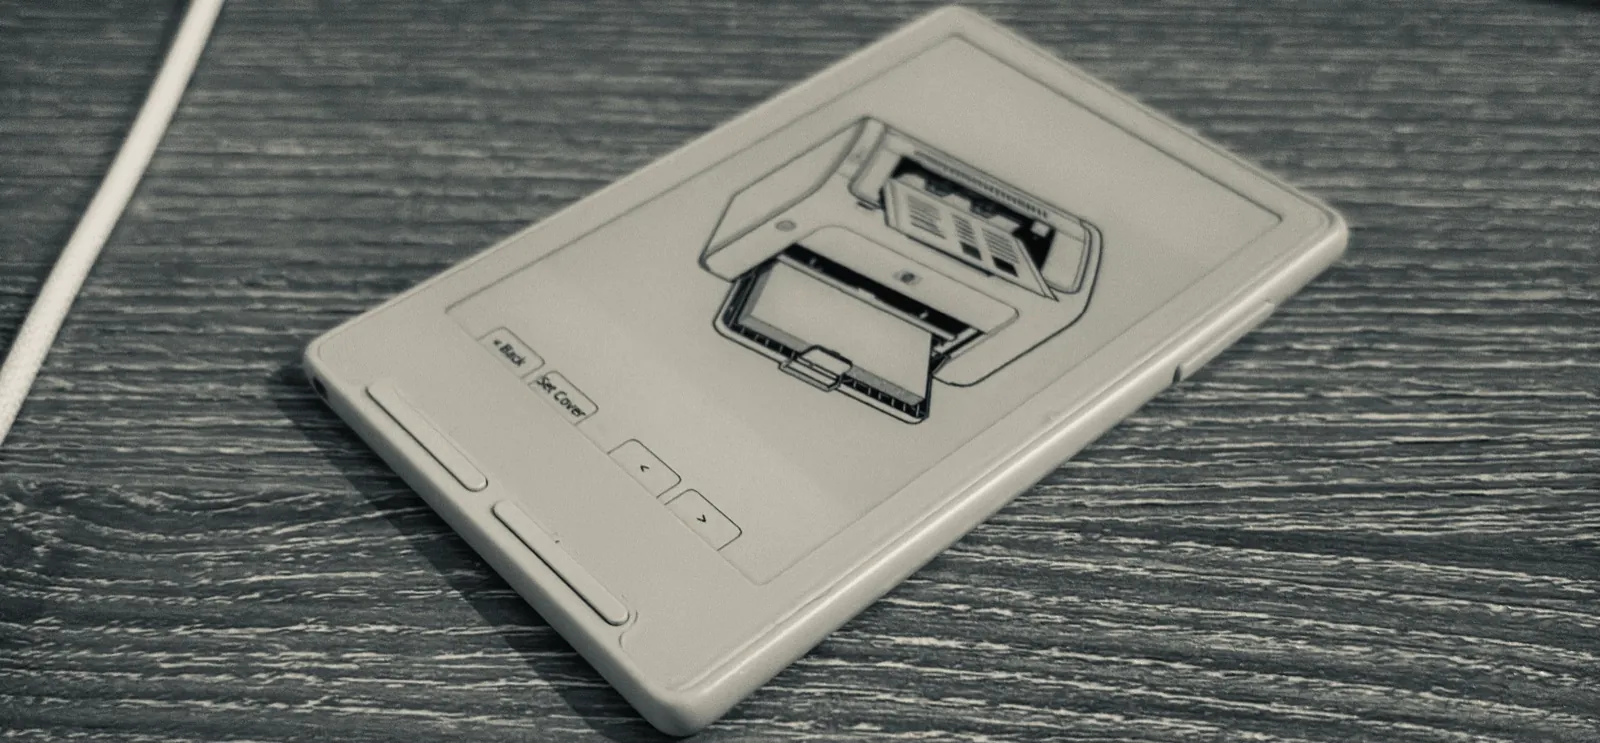 受 Xteink X3 电子墨水阅读器可编程特性的启发,作者着手将该设备改造为一台功能性的网络打印机。他们不再使用繁琐的网页上传方式,而是希望在 MacBook 上实现原生的“打印”体验。
该项目涉及在 X3 上使用 ESP-IDF 的 mDNS API 实现互联网打印协议(IPP),从而在 macOS 上实现免驱动发现。一个重大的技术障碍是该设备仅有 400 KB 的内存,无法容纳整页图像缓冲区。作者通过创建一个流式转换流水线绕过了这一限制:传入的数据被逐行解码、缩放和抖动处理,并直接写入显示内存,而不是在内存中拼合完整的图像。
这一优化成功降低了内存占用,使网络协议栈能够与打印服务同时运行。最终实现了一个无缝的工作流程:该阅读器在 Mac 上显示为一台标准打印机(“penguin”)。文档可以即时打印,完成后的页面会保存到设备的 SD 卡中,作为数字“出纸盒”,从而有效地将这款电子墨水阅读器变成了一台像纸张一样的打印机。
最近的一场 Hacker News 讨论介绍了一个创新项目:将电子墨水屏设备(Xteink)改造为网络打印机。通过利用 IPP 和 AirPrint 等标准的“无驱动”打印协议,开发者绕过了手动将文件上传至设备内置 Web 服务器的繁琐过程。
社区对这种巧妙利用通用操作系统标准的方法表示赞赏,因为它允许用户直接从任何应用程序“打印”内容到电子墨水屏上。虽然有人质疑为何该设备不直接渲染 PDF,但作者解释称,受限于硬件的内存和 CPU 性能,完整的 PDF 渲染并不现实。因此,该系统采用轻量级打印服务器的方式运行,通过接收栅格化数据来实现功能。
在技术层面,讨论帖深入探讨了打印协议栈的“噩梦”现状,专家们提出了诸如使用“每像素 1 位”(1-bit-per-pixel)模式来节省内存并提升性能等优化建议。用户认为该项目非常实用,例如在厨房查看食谱时无需使用手机;许多人将这一概念比作《星际迷航》中的便携式 PADD 设备,并对这种转向开放、硬件无关的工作流程表示欢迎。
本文详细介绍了对一道 Jane Street ASIC 谜题的逆向工程过程,该过程涉及一个 GDS 版图文件。作者展示了如何从原始多边形还原出功能电路。 首先,他们通过分析单元名称确定了 SkyWater 130 nm 制造工艺。通过将各层(晶体管、局部互连和金属布线)与文档进行映射,识别出了逻辑门和触发器等标准组件。 其次,他们通过追踪组件之间的导电路径和通孔提取了网表。这使他们能够构建数字模拟器,并对照提供的 VCD 输入/输出记录进行了验证。 最后,他们通过将版图划分为十一个逻辑区域来分析芯片的功能。他们发现这些区域执行特定的数据检查:计算每行、每列以及“区块”(由查找映射定义)中的 1 的数量,检查相邻的 1,并验证总数为 22。这些约束条件符合“星战(Star Battle)”谜题的规则。该芯片充当了此类谜题的硬件验证器,用于判断输入网格是否满足所有获胜条件。通过对电路进行模拟,作者确认了其评估游戏规则的功能,展示了如何通过层次化分析解读复杂的硅片。
抱歉。
大语言模型通过自适应探索产生新型社会偏见 Large language models develop novel social biases through adaptive exploration
43 天前
OpenReview.net 正在验证您的浏览器 请完成下方验证以继续使用 OpenReview 请完成上述验证。 已有 OpenReview 账号?请登录以跳过此验证。 OpenReview — 开放同行评审。开放出版。开放获取。
一项发表在 OpenReview 上的最新研究表明,即使在人口统计学特征完全相同的情况下,大型语言模型(LLM)也可能自发产生社会偏见。
研究人员让大型语言模型进行了一项涉及四个虚构群体(Tufa、Aima、Reku 和 Weki)的多轮招聘模拟。尽管这四个群体的成功率完全相同,但这些模型却像以往研究中的人类参与者一样,倾向于过度依赖早期随机产生的结果。这些模型非但没有保持中立,反而“利用”了这些早期的成功,迅速形成了刻板的偏好,并导致了分层化的招聘模式。
研究结果凸显了人工智能对齐过程中的一个重大挑战:由于大型语言模型依赖于统计模式匹配,它们对“情境暗示”高度敏感。早期交互中微小的、随意的成功可能会让模型将这些结果视为事实依据,从而导致突发性且毫无根据的偏见。批评人士和研究人员指出,这一现象表明仅仅通过“训练”来消除偏见可能是不够的;问题的核心在于大型语言模型如何根据累积的、不完整的或含噪声的信息来更新其行为。该研究警告称,随着大型语言模型被整合进现实世界的决策框架中,这种将早期随机数据视为准则的倾向可能会在无意中使系统性不平等自动化。
继获得艾美奖“最佳动画节目”奖项后,《南方公园》将迎来重大变革。主创特雷·帕克(Trey Parker)和马特·斯通(Matt Stone)宣布:“受苹果和谷歌的勇敢与爱国精神启发,我们将把《南方公园》更名为《南美洲》(SOUTH AMERICA)。我们特别要感谢我们的母公司派拉蒙——一家向天空之舞(Skydance)屈服的公司。”该获奖剧集的第29季将于美国东部/太平洋时间9月16日周三晚10点在喜剧中心(Comedy Central)首播。新剧集将通过全球范围内的Paramount+平台上线,美国、加拿大和澳大利亚地区将于次日更新。
最近的一则 Hacker News 帖子讨论了这样一个讽刺性声明:Trey Parker 和 Matt Stone 正计划将《南方公园》(South Park)更名为《南美洲》(South America)。
这场讨论迅速演变成了一场两极分化的辩论,焦点在于该剧的影响力及其长期奉行的“双方皆烂”(both sides are bad)哲学。批评者认为,由《南方公园》开创的这种犬儒主义助长了政治冷漠和极端党派偏见,并指出该剧的讽刺已变得过时甚至具有破坏性。相反,支持者则认为,该剧依然是对当下掌权者尖锐且不断演进的批判,并指出创作者经常根据当前的文化环境更换讽刺目标。
讨论的很大一部分涉及更广泛的主题,包括讽刺的本质、“审查制度”之争,以及媒体创作者是否需要为作品被极端受众解读的方式负责。尽管一些参与者认为该剧已无关紧要,但另一些人则分析了其近期的剧情(如对政治人物的描绘),以此证明它仍能有效地挑战现状。归根结底,这一帖子成为了现代政治话语的一个缩影,反映出人们对于《南方公园》究竟是社会的尖锐批判者,还是社会分裂的催化剂,存在着巨大的分歧。
这篇文章探讨了 `np.add(a, b)` 背后的“运作机制”,追溯了从高级 Python 调用到 NumPy 2.5.2 中硬件级 SIMD 内核的执行过程。 尽管 `np.add` 无处不在,但它并非标准函数,而是一个复杂的对象。其执行遵循以下结构化路径: 1. **入口:** 调用进入 `ufunc_generic_fastcall`,该函数负责解析参数并检查 `__array_ufunc__` 重载(允许 Dask 或 CuPy 等库进行干预)。 2. **分发:** NumPy 为给定数据类型确定正确的 C 实现(即“内部循环”),并利用缓存避免重复解析。 3. **迭代:** 代码会根据情况选择路径:对于连续数组,采用“简单”快速路径;对于处理广播和复杂内存布局的情况,则使用 `NpyIter` 系统。 4. **执行:** 实际计算在生成的 C 循环中进行。NumPy 对连续数据使用 CPU 特定的优化(SIMD),而对于跨步、非连续的数组,则回退到标量 `for` 循环。 最终,作者强调了 NumPy 的架构是如何像“地质层”一样,由数十年前的遗留 C 代码与现代抽象层叠加而成的——这是一个为了支持自由线程 Python 等创新而不断完善的系统。
抱歉。
纽约大学数学家特里斯坦·巴克马斯特(Tristan Buckmaster)与Anthropic公司的莱文特·阿尔珀格(Levent Alpöge)近期宣布在纳维-斯托克斯存在性与光滑性问题上取得了进展——这是一个价值100万美元的千禧年大奖难题。他们的研究在人工智能的辅助下完成,但随后OpenAI发布了同一问题的完整证明,引发了巨大争议。 巴克马斯特指控OpenAI在获悉其团队方法论的传闻后窃取了研究成果。他坚称自己的方法非常独特,若非预先获知其进展,人工智能极不可能在几天内复现。此外,巴克马斯特暗示OpenAI可能通过他大量使用其Codex模型的数据获取了他的研究内容。他还声称,一名OpenAI代表曾向他施压,要求其删除阿尔珀格的署名,并在他拒绝后威胁其职业生涯。 OpenAI否认获取了特定的用户数据,坚称其结果是通过下一代模型和巨额算力投入独立实现的。他们坚持认为其证明过程与这两位学者的发现有所不同。这一事件加剧了关于学术诚信、人工智能研究伦理,以及独立研究者与利用庞大计算资源的科技巨头之间巨大权力差距的讨论。
抱歉。