 桑伯恩保险地图(1870–1960)提供了美国城市历史中极其详尽的建筑级视图。虽然这些地图对历史研究极具价值,但由于它们与现代地理坐标未对齐,往往难以查阅。
为解决这一问题,作者开发了 **mapsnap**,这是一个通过将地图与现代数据对齐来实现“地理配准”的自动化工具。与费时费力的人工处理不同,mapsnap 使用光学字符识别(EasyOCR)来识别地图上的街道标签。随后,它会根据这些标签计算潜在的交叉路口,并将其与当前的街道地图进行比对。
该程序利用名为 RANSAC 的统计方法,剔除误读的文本或错误的匹配项,从而在面对文本检测中的大量“噪点”或误差时,识别出最精确的对齐方式。尽管该工具在处理弯曲街道、重命名道路或缺乏清晰标签的区域时仍存在困难,但它成功地将以往繁琐的流程实现了自动化,使历史城市数据变得更易于获取。该项目为开源项目,旨在最终完成美国国会图书馆海量桑伯恩扫描地图集的地理配准工作。
每日HackerNews RSS
Mapsnap:历史桑伯恩保险地图的自动化地理配准 Mapsnap: Automated Georeferencing for Historic Sanborn Insurance Maps
32 天前
对不起。
OpenAI 披露六起关于人工智能“令人担忧”行为的新事件 OpenAI Discloses Six New Incidents of ‘Concerning’ A.I. Behavior
32 天前
请启用 JavaScript 并关闭所有广告拦截器
抱歉。
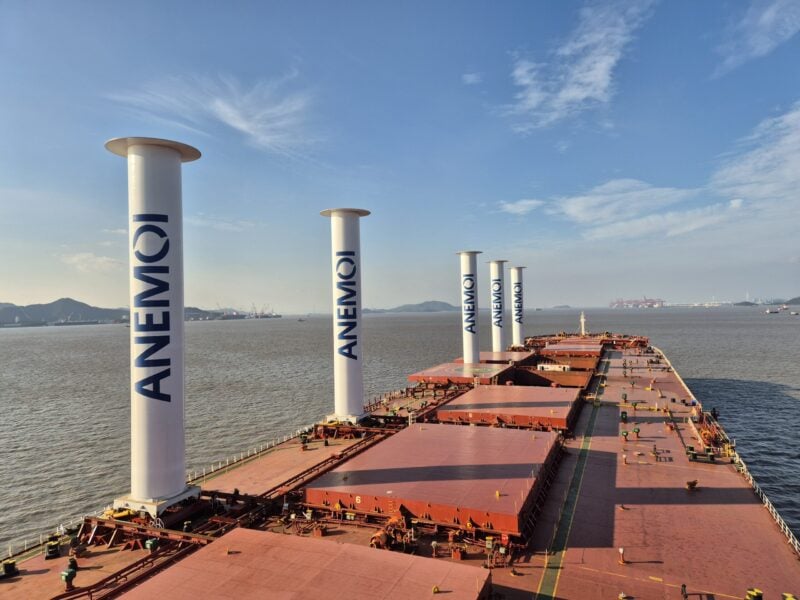 商业航运正日益拥抱风力推进技术,从早期的局部试验演变为日益成熟的行业趋势。现代系统(如自动化旋筒风帆、硬质翼帆和吸气式风帆)正被改装安装于散货船、油轮和集装箱船等大型船舶上,以辅助传统发动机。
这些技术并非旨在取代传统动力,而是利用免费的可再生风能,显著降低燃料消耗和碳排放。马士基(Maersk)、淡水河谷(Vale)和出光油轮(Idemitsu Tanker)等行业巨头正将这些系统集成到各自的船队中。据国际风船协会统计,目前已有超过100艘大型船舶配备了此类技术。
尽管风能仍是一种间歇性能源,但行业正转向一种整体化的方案,将自动化的风力辅助系统与气象导航软件、发动机管理系统及船舶设计相结合。随着法规的日益明确和运营经验的积累,风能正成为海运业脱碳战略中至关重要且切实可行的一部分。通过将古老的物理原理与先进的工程技术相结合,航运业正迈向一个更高效的未来,不再忽视海上唾手可得的免费能源。
风力辅助推进技术在商业航运中的复兴——例如弗莱特纳转子(Flettner rotors)和吸力帆——是业界反复讨论的话题。尽管现代系统旨在通过辅助传统发动机来降低燃油消耗,而非完全取代动力,但这一概念仍面临重大的现实与经济障碍。
批评人士指出,这些技术往往被宣传为“颠覆性”试验,却难以获得广泛应用。主要挑战包括:
* **运营限制:** 帆具会干扰驾驶台视野、龙门吊作业及甲板货物空间。
* **可预测性:** 航运业依赖严格的日程安排和预先计算的成本,而风力的不确定性难以与之兼容。
* **经济可行性:** 对许多运营商而言,高昂的资本和维护成本,加上船员培训的复杂性以及港口进出的限制,导致其投资回报率不足。
虽然一些人认为这些系统是迈向脱碳的必要步骤,但另一些人则主张,全球航运的长期解决方案可能需要核动力、合成燃料或大规模电池阵列,而非回归风力推进。这些报道反复出现,表明该领域仍处于实验性兴趣的循环中,尚未对标准航运物流产生实质性变革。
研究人员发布了一种全新的开源排序算法,其性能比标准的 C++ `std::sort` 快 10 倍。该算法专为现代列式数据库设计,通过利用 SIMD(单指令多数据流)向量指令并行化快速排序(Quicksort)的分区阶段,从而实现了这一速度。 以往的高速排序方法往往局限于特定的硬件架构,而这种新实现使用了“Highway”库,确保了在包括 x86(AVX2、AVX-512)和 Arm(NEON)在内的六种指令集上的可移植性。通过有效利用硬件特定的“压缩存储”(compress-store)指令,或在不支持时通过置换指令进行模拟,该算法在任何平台上都能保持创纪录的性能。 该实现支持多种输入大小(16–128 位),在单 CPU 核心上速度超过 1 GB/s,显著优于现有的尖端解决方案。这一成果有望为以排序为主要瓶颈的数据密集型应用开启新的能力。源代码已在 GitHub 上以 Apache 2.0 许可证发布。
这篇 Hacker News 讨论帖重温了一篇 2022 年关于**向量化、高性能可移植快速排序(Quicksort)**的文章。该算法通过“Highway”库在多种架构(ARM、RISC-V、x86)上利用 SIMD 指令,实现了高性能。
讨论涵盖了以下几个关键领域:
* **技术价值**:合著者 Jan Wassenberg 证实,这种方法在今天仍然具有现实意义,并指出它已被集成到 NumPy 和 XLA 等大型项目中。它在无需编写数千行冗余代码的情况下,性能优于针对特定架构的实现。
* **算法的“美感”**:参与者探讨了排序算法在审美和概念上的吸引力。虽然有些人赞赏快速排序的高效性和原地(in-place)特性,但也有人认为与归并排序或堆排序的“优雅”结构相比,它显得有些杂乱。
* **现代开发**:对于现代大语言模型(LLM)是否能取代手动优化的 C++ 库,人们持怀疑态度。作者认为,维护源代码仍然优于依赖 LLM 生成的代码或过于复杂的编译器转换,因为这关乎可靠性和可维护性。
* **行业背景**:评论强调了软件工程中存在的“发现危机”,即许多现有的高性能解决方案往往不被开发者所知,直到它们出现在技术讨论或精选代码库中才被发掘。
免责声明:DMI 是由 Google 和 Google DeepMind 的研究人员发起的平台,旨在发布和探讨关于通用人工智能(AGI)时代的创新且深入的构想。DMI 的文章旨在作为对话的起点,反映作者本人的观点与研究,不应被视为 Google 的官方立场。
对不起。
 本摘要概述了 **JiT-DDT** 的开发过程,这是一种旨在克服潜在扩散模型(LDM)效率瓶颈的新型生成式图像架构。
**问题所在:** 传统的 LDM 依赖 VAE 进行压缩,但这些模型达到了经验极限(16x16),进一步压缩会导致图像质量下降。当使用标准的 v-prediction 时,高分辨率生成还会受到“维度灾难”的困扰,使得扩散变换器(DiT)难以从高维输入中学习。
**解决方案:** 作者使用一种通过“激进分块”(aggressive patchification)实现的统一“像素空间”模型取代了 VAE。通过将 v-prediction 切换为 **x-prediction**,该模型避免了拟合高维噪声,从而能够利用 32x32 的压缩率。为了解决此类模型常见的精细细节丢失问题,他们引入了 **JiT-DDT (解耦扩散变换器)**,将 DiT 拆分为结构编码器和细节导向解码器。
**结果:** JiT-DDT 取得了显著进展:其训练速度比 Linum v2 基准快 3.6 倍,同时生成的像素多出 4 倍。通过细化器和专门的噪声调度等架构改进,该模型在风格保真度和光影效果方面均优于其前身。
抱歉。
 艾弗里·罗宾逊(Avery Robinson)探索了重金属音乐中“颓废美学”的起源,追溯其从20世纪80年代DIY地下文化到现代数字设计的演变历程。在Photoshop等工具普及之前,重金属标志性的视觉语言(以颗粒感、高对比度和质感为特征)是卡带交易圈、杂志文化以及无休止的低质量复印件所催生的一种经济必然。
每一代传单或试听带封面的视觉保真度都在不断牺牲,积累了诸如碳粉污渍、边缘撕裂和对齐偏差等“伤痕”。这些缺陷并非单纯的风格选择,而是那个没有数字工具的时代里,文化生存的见证。
如今,尽管高端软件能在几秒钟内复刻这些效果,但罗宾逊认为,这种美学之所以能延续,是因为它承载了历史与真实性的分量。正如褪色的乐队T恤或沾满草渍的球员球衣一样,这些纹理象征着个性和坚毅。归根结底,重金属美学依然是表达那种震撼灵魂的强度的有力视觉缩影,这证明了无论使用何种工具——无论是复印机还是数字插件——信息的力度和对DIY精神的执着,才是定义该流派持久视觉标识的关键。
抱歉。
本文探讨了现代 GPU 矩阵乘法器中缺乏 IEEE 754 标准合规性的问题,并指出舍入方式、累加器宽度和非规格化数处理等未公开的实现细节,导致了不同硬件间数值结果无法复现。 研究人员对三种 AMD GPU 架构(CDNA 1、CDNA 2 和 CDNA 3)的矩阵核心数值行为进行了表征。通过设计特定的测试向量并采用迭代式的随机细化过程,研究人员为每种架构开发了高保真的 MATLAB 软件模型。这些模型通过 1000 万组随机输入数据进行了验证,确保了与硬件层面的位级精度一致。 该研究最终利用这些模型对比了 AMD 矩阵核心与 NVIDIA 张量核心的精度,展示了这些模型在实验研究和跨厂商数值分析中的应用价值。
抱歉。
 **Hush** 是一款轻量级的 Mac 应用程序,旨在通过生成实时背景噪音帮助用户进入专注状态。
开发者因在浏览器标签页中开启声音生成器会产生干扰(并导致更多在线分心)而感到困扰,因此开发了这款驻留在 Mac 菜单栏的原生解决方案。Hush 提供两种主要选项:**棕色噪音**(一种深沉、舒缓的低鸣)和**“人声遮蔽”**(专门用于掩盖人声的频率)。
该应用完全离线运行,CPU 占用低,并针对速度进行了优化。用户只需右键点击即可即时切换声音,左键点击则可调整音量和低通滤波器等设置。
Hush 目前以“随心付费”(包括免费下载)的形式提供,其源代码已在 GitHub 上以 MIT 许可证开源。这是一个旨在消除技术障碍的精简工具,让用户能够摆脱基于浏览器的音频工具所带来的干扰,全身心投入深度工作中。
抱歉。
尽管 Rust 通过预防常见漏洞提高了软件安全性,但它并不能保证逻辑正确性或绝对安全。为了解决这一问题,亚马逊与开源社区共同开发了 Verus,这是一个针对 Rust 的自动化程序验证器。 Verus 允许开发者直接在 Rust 源文件中编写形式化的数学规范,以精确描述代码的预期行为。该工具随后会自动构建证明,以验证代码在所有可能的输入下均符合这些规范。通过整合熟悉的 Rust 语法并提供快速反馈,Verus 使开发者能够验证复杂的逻辑、确保“不安全(unsafe)”代码块的安全性,并证明错综复杂的并发系统的正确性。 在亚马逊,Verus 已成为保障关键基础设施(包括 Nitro 隔离引擎)安全的核心技术。在亚马逊之外,开源社区也利用 Verus 验证各种项目,从微内核、密码学库到 Kubernetes 控制器,应用范围广泛。通过填补“安全代码”与“可证明正确代码”之间的鸿沟,Verus 为在容错率极低的环境中构建高可靠、高安全性的软件提供了强大的框架。
这次讨论的核心是 **Verus**,这是一款用于开发可证明正确 Rust 代码的工具。与识别缺陷的标准测试不同,Verus 允许开发者通过数学方法验证代码是否符合特定的形式规范。它通过使用注解(或宏)向 SMT 求解器(如 Z3)提供证明义务来实现这一目标。
讨论的要点包括:
* **效用**:支持者认为 Verus 是高安全性系统的一大进步,因为它弥补了理论规范与生产实现之间的鸿沟,这与专注于建模的 TLA+ 等工具不同。
* **证明负担**:批评者认为手动编写证明注解容易出错、难以维护,且无法保证原始设计逻辑的稳健性。支持者则反驳说,这些注解提供了比通用测试更具扩展性的局部推理。
* **集成**:虽然有人质疑为什么这类证明没有包含在 Rust 编译器中,但专家指出,基于 SMT 的验证计算成本高昂,且需要超出简单类型检查的人工输入。
* **对比**:Verus 常被拿来与 Dafny、SPARK/Ada 和 Kani 等其他形式化验证工具进行比较,它们都使用了类似的基于逻辑的方法。