请提供您想要翻译的内容。
每日HackerNews RSS
微软以 12 万美元将 Copilot 运行时代理式迁移至 Rust Microsoft agentically ports Copilot runtime to Rust for $120K
28 天前
Show HN:与人类偏好对齐的 AI 面部吸引力模型 Show HN: AI Facial Attractiveness Model Aligned with Human Preferences
28 天前
我们的模型基于 60 位真实人士对数千张人脸照片的评分进行训练。它学习的是人类对这些照片的评价方式,而非仅仅通过面部特征点来计算分数。 为了减少单张照片(如光线或临时身体状态)的影响,我们建议上传同一人的 3–5 张照片。我们会结合这些结果,以得出更稳定、更客观的评估。 01 8.0/ 10 模型评估 基于真实的人类偏好 该模型借鉴了 60 人对数千张人脸照片的评分,因此分数反映了人类共同的评价模式。 02 使用清晰、未编辑的照片 请使用光线均匀的正面照片。该模型仅在自然的素颜照片上进行过训练,因此影棚人像、滤镜和修图可能会影响评分。添加 3–5 张相似的照片以获得更稳定的评估。 03 ✓选择你最好的头像 上传 3–5 张照片,比较它们的评分,并选择最适合你个人资料的那一张。
抱歉。
 为了探索《幸存者》背后的策略,作者开发了一个机器学习模型,用于预测哪些选手最有可能在下一次部落议会中幸存并最终赢得比赛。作者利用 *survivoR* 存储库中的数据,基于投票历史、免疫挑战和编辑“采访”次数等因素,训练了两个逻辑回归模型。
虽然该模型无法量化社交化学反应或纯粹的运气,但其表现明显优于随机猜测,识别最终赢家的准确率是基准预测的两倍。它还提供了关于“赢家套路”的见解,例如获得选票的负面影响,以及出镜时长与获胜之间的正相关性。
作者指出,尽管该模型并非完美的预测工具,但它对于超级粉丝验证理论和追踪选手表现轨迹来说,是一个极佳的辅助工具。通过分析历史数据和“统治力评分”,该模型成功捕捉到了长久以来的粉丝叙事,包括识别出节目史上最具统治力的胜利和最令人惊讶的爆冷。该项目强调,赢得《幸存者》需要社交机动性与风险管理的独特平衡,即使是数据驱动的方法也能帮助阐明这一点。
抱歉。
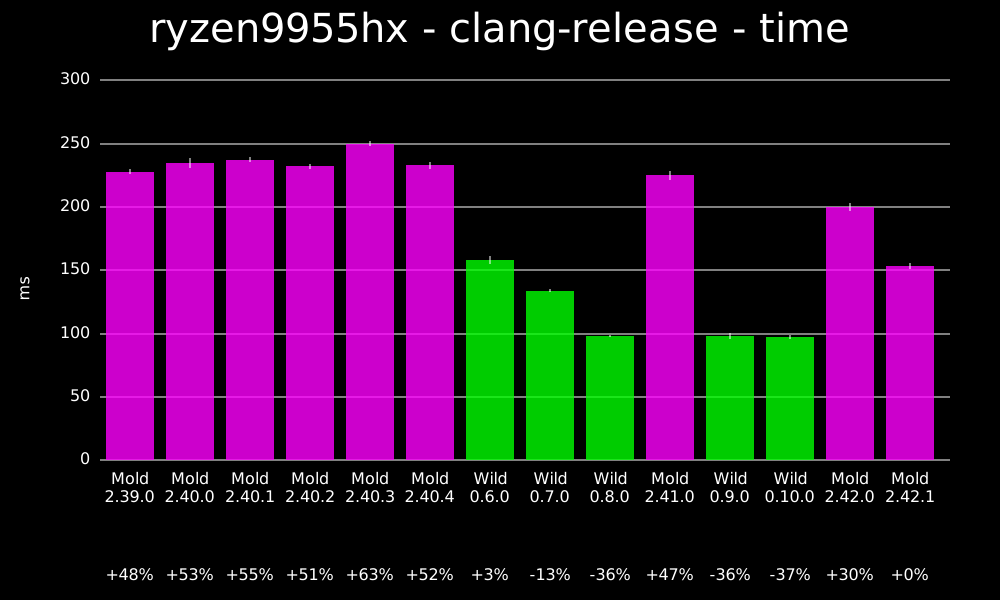 David Lattimore 调查了为何最近的基准测试显示“Wild”链接器的性能明显慢于“Mold”。他得出的结论是,性能差距主要源于测试环境和方法的差异,而非内在设计缺陷。
已确定的关键因素包括:
* **基准测试配置:** Mold 的测试使用了 ext4 文件系统,在每次运行间删除了输出文件,并禁用了分叉(forking)。相比之下,Wild 过去常采用 `tmpfs` 并保留现有文件,这掩盖了 Wild 在标准文件系统下存在的性能问题。
* **近期改进:** Mold 在 2.42.0 和 2.42.1 版本中获得了显著的性能提升,而这些改进并未体现在 Wild 的旧基准测试数据中。
* **优化:** Wild 缺乏 Mold 用来加速文件操作的特定操作系统级优化,例如 `fallocate` 和大页映射(hugepage mapping)。Lattimore 确认这些功能目前正在加入 Wild 中。
在消除这些变量后,Lattimore 在类似硬件上成功复现了 Mold 的测试结果。他指出,虽然由于硬件差异(例如 Threadripper 的高线程数)仍存在一些出入,但性能差距主要可以归因于不同的测试条件以及 Mold 近期的快速发展。
抱歉。
请启用 JavaScript 和 Cookie 以继续。
本文是对离散傅里叶变换(DFT)通俗易懂的入门介绍。它侧重于直觉理解而非晦涩的数学证明,通过交互式可视化、动画和声音,让那些对传统学术文献感到畏难的读者也能轻松掌握复杂的信号处理概念。 作者强调,本资源定位为“科普”而非详尽的教科书。如需获得数字信号处理(DSP)的专业级掌握,建议读者参考权威资料进行补充,例如 Richard J. Lyons 的《理解数字信号处理》(Understanding Digital Signal Processing),以及 Paolo Prandoni、Martin Vetterli 和 Julius O. Smith III 等专家的免费资源。 本项目旨在通过视觉学习和互动体验来消除“数学恐惧症”。在兼顾学术完整性与教学简易性的前提下,我们诚邀读者以一种轻松、交互的方式探索信号处理之美。欢迎通过 GitHub 提供反馈与修正建议。
这篇 Hacker News 帖子讨论了“Seeing Circles, Sines, and Signals”——一个因其高质量的文字、动画以及对复杂数学概念的直观解释方式而备受赞誉的教育网站。
用户们对该网站将复数和正弦波等高难度主题变得易懂且引人入胜的能力表示赞赏。许多参与者感叹,与传统的抽象授课相比,这种视觉化的互动工具本可以显著改善他们的大学学习体验。
讨论还涉及了一些更广泛的主题,包括建立一个由社区驱动的高质量教育小工具注册库的可能性、复数的优雅,以及对类似资源的推荐(例如完全由正弦函数构建的游戏)。该网站的作者因其精湛的制作水平获得了积极反馈,一位用户将其评价为“S 级”学习资源。总的来说,这次讨论突显了社区对“灵感编程”(vibe coding)以及优先考虑视觉直觉的互动式数字教学法的浓厚兴趣。
KDE 迎来 30 周年,有人提出了 AI 原生桌面方案。 KDE turns 30 and someone's brought an AI-native desktop proposal
28 天前
请提供您想要翻译的内容。
最近一项将人工智能集成到 KDE 桌面环境中的提案——被称为“Kadai”(一个加密且与厂商无关的个人内核)——在用户中引发了激烈争论。该项目设想了一个能够学习用户习惯并动态组装个性化界面的桌面,其核心理念总结为“一个会回馈你的爱(loves you back)的桌面”。
Hacker News 上的评论者大多持怀疑态度,称该概念为“噱头”。许多用户认为,桌面应该是一个可预测、高效的工具,而不是一个智能伴侣,并指出他们除了启动应用程序外,很少与桌面外壳进行交互。其他人则提出了对隐私、潜在的“臃肿”以及用户控制权丧失的担忧,并将该提案与 Omarchy 等“主观臆断型”Linux 发行版的趋势进行了对比。
尽管一些用户欣赏 AI 在自动化复杂配置或修复损坏设置方面的潜力,但主流观点仍倾向于极简主义和稳定性。批评者认为,该项目反映了“制造问题”而非解决核心可用性问题的趋势,这也强化了许多人的观点:理想的桌面仍然是一个简单、不干扰用户的启动器。
这项研究报告了在乌兹别克斯坦奥比-拉赫马特(Obi-Rakhmat)岩棚的最深层(第20-21层)中发现的20件投射物装具,其年代可追溯至约8万年前。这些文物包括大型尖状器,以及重要的、展现出与高速撞击一致的断裂模式的小型“微型尖状器”,这表明它们曾被用作箭头或轻型标枪头。
研究人员通过实验复制和使用痕迹分析对石器制作序列进行了分析。他们得出结论,这些微型尖状器并非偶然产生的石片废料,而是经过刻意制作的工具。鉴于投射物设计的功能性要求——特别是为确保穿透力而必须具备的锋利度和轻薄度——作者认为,这些装具代表了一种早期且复杂的狩猎系统。
这些发现因其极早的年代而引人注目,比欧洲和黎凡特地区的类似技术早了数万年。作者将这些文物与尼罗尼安工业(如曼德林洞穴)进行了比较,并提出波斯高原可能曾是人口互动和技术创新的“中心”。最终,该研究强调了狩猎武器领域一项重要的早期发展,挑战了既定的人类进化中复杂投射技术出现的时间表。
发表在《PLOS ONE》上的一项关于乌兹别克斯坦奥比-拉赫马特(Obi-Rakhmat)遗址石器的最新研究表明,人类使用小型箭簇状投射点的时间可能比此前认为的早了25,000年。
Hacker News 对此发现的讨论强调了研究人员所采用的严谨方法,他们利用现代实验复原技术,并对动物尸体进行了微观撞击分析,以验证这些古代工具的功能及磨损情况。尽管一些评论者指出,区分早期的“投掷镖”(配合掷矛器使用)与真正的箭矢在技术上存在难度,但其他人则称赞了这项研究在石器分析方面所采用的严谨方法。总的来说,该讨论反映出人们对于这类研究的赞赏,认为它们为深入了解早期人类的生活、身体能力及技术复杂性提供了一个难得且数据丰富窗口。
长周期 AI 编程往往因为瞬时上下文窗口的退化和智能体自我报告的不可靠而失败。为了扩展 AI 编程,我们必须从单一的重载会话转向“编排-执行”模型,这通常被称为“幕僚长(Chief of Staff)”模式。 **核心原则:** * **角色分离:** 由长寿命的“协调者”负责管理状态、分配任务并验证输出。“执行会话”则是短寿命的、专注于特定任务且可丢弃的。 * **持久化状态:** 将项目进度、任务摘要和逻辑存储在外部系统(如看板或 API)中,而不是存储在易失的对话上下文中。 * **验证重于信任:** 将智能体的报告视为“意图”而非事实。协调者必须重新运行命令、验证退出代码并检查差异。永远不要仅凭智能体的一面之词就认为任务已完成。 * **故障安全循环:** 采用“红门(Red Gate)”方法:在实施修复之前验证测试是否失败,以避免出现“空断言”(即测试因为没有真正检查该功能而通过)。 * **工件驱动的交接:** 使用已提交的文件和共享日志,确保在一个会话中学到的经验教训能够延续到下一个会话中。 这种规范以速度换取可靠性,确保智能体的工作能够不断积累,而不是坍塌。
这篇 Hacker News 帖子探讨了用于编排 AI 编程代理的“参谋长”(Chief of Staff)模式。用户描述了一种工作流程:由一个主代理将任务拆解为基于 Markdown 的工单,然后委派给子代理进行执行。
主要内容总结如下:
* **优势**:支持者认为,这种方法无需人工干预即可进行大规模开发和复杂的任务管理,从而有效地将编程转变为一种“软件工厂”式的体验。
* **风险**:批评者指出存在“架构流沙”的风险,并注意到自主代理往往会产生代码臃肿、测试过度以及“过度设计”的问题,导致难以调试。有用户警告称,无人值守的变更可能导致灾难性且难以追踪的漏洞。
* **最佳实践**:许多人建议,目前的代理在处理范围明确、单调的任务时表现最佳,而非处理整个架构生命周期。保持对系统清晰的思维模型并进行人工代码审查仍然至关重要。
* **未来展望**:尽管有些人相信 AI 最终将进化到能够原生处理这些编排任务,但另一些人坚持认为,对于当前的开发而言,最好的“秘诀”仅仅是提供清晰的指令——例如通过专门的 `AGENTS.md` 文件来引导模型的行为。
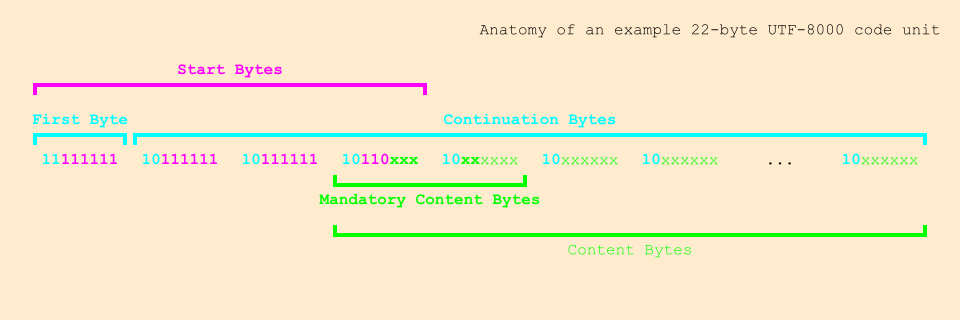 **UTF-8000** 是一种实验性的、可无限扩展的 UTF-8 编码方案版本。它作为编码理论中一项有趣的独立练习而设计,扩展了 UTF-8 的架构,以支持任意大的码点(codepoint),且无需引入新的特殊情况或破坏现有的编码特性。
### 核心特性
* **无限可扩展性:** 通过将前导位拆分为“自同步”和“自标点”前缀,UTF-8000 允许使用任意长度的多字节代码单元。
* **保持 UTF-8 的核心特性:**
* **自同步:** 字节可以被明确识别为“首字节”或“后续字节”,从而支持错误恢复和随机访问。
* **自标点:** 代码单元本身就能标明其长度,无需额外的分隔符。
* **Strcmp 顺序:** 保持了无需解码即可使用 `strcmp(3)` 比较编码序列的能力。
* **无字节序:** 依然是一种单字节量子的编码。
* **防止冗余编码:** 严格禁止冗余、不安全或模棱两可的表示,这一点继承自标准 UTF-8 模型。
尽管 UTF-8000 未得到统一码联盟(Unicode Consortium)的认可,且主要作为对“完美”可扩展性的理论探索,但它为其他建议的 UTF-8 扩展(如 UTF-Infinity 或 Perl 的 `utf8`)提供了一种稳健的替代方案。参考实现可在 GitHub 上找到。
讨论围绕着 **“UTF-8000”** 展开,这是一种实验性的、非官方的 UTF-8 编码标准扩展,旨在支持任意大的码位。
**主要内容:**
* **提案:** UTF-8000 使用一种变长字节结构,允许使用超出当前 Unicode 限制的码位。支持者称赞其数学上的简洁性和可扩展性,并指出它对低范围字符保持了与标准 UTF-8 的向后兼容性。
* **批评:** 持怀疑态度者(包括 UTF-8 的共同创造者肯·汤普森)认为这是不必要的,并将其比作“用 IPv50 取代 IPv6”。许多人警告称,任意长度的编码可能会引入缓冲区溢出风险和复杂性,却无法解决实际问题。
* **技术争论:**
* **自同步:** 用户讨论了 UTF-8 在数据损坏时能够“重新同步”的价值,并指出 UTF-8000 保留了这一特性。
* **用例:** 有人建议,它最终可以将复杂数据(如大语言模型标记、图像,甚至整个编程脚本)编码在单个“字符”中。
* **遗留问题:** 讨论中很大一部分内容批评了对 UTF-16 的长期依赖以及字符编码标准普遍的混乱状况,许多人希望全面转向 UTF-8。