该数据集展示了 48 种不同模型在五个不同测试类别中的 JevBench 性能排名。结果显示出显著的差异性,许多模型的排名与其 JevBench 总分相比存在波动。 **主要观察结果:** * **顶尖表现:** Jev 1.13.0、SemIf 和 djev 等模型表现稳定,排名靠前,在所评估的类别中经常位居前列。 * **性能差距:** 性能差距巨大,从得分较高的模型(70 多分和 80 多分)到排名垫底的模型(如 Certo v1,得分接近零)不等。 * **不一致性:** 数据中一个值得注意的反复出现的现象是,各分类别的排名经常与 JevBench 总分不同,这表明某些模型无论总排名如何,在特定的测试环境下可能表现优异或不佳。 * **底层梯队:** 榜单末尾是一些专用模型和重排序模型(如 GLiNER、Mixedbread、BAAI),它们在这些特定基准测试中的表现微乎其微。 总体而言,该数据突显了模型能力的多样化格局,其性能高度依赖于具体的评估标准。
每日HackerNews RSS
抱歉。
在 Carson Gross 的文章中,他认为随着代理式编码(agentic coding)成为标准,Markdown 正在从单纯的文档转变为一种至关重要的源代码形式。目前,软件的“真实依据”(ground truth)往往在短暂的 LLM 对话中丢失。为了解决这一问题,Gross 提出开发者应将项目意图显式地记录并存储在位于 `/src` 目录下的 Markdown 文件中。 将这些文档移入源码树具有多重优势:它为人类开发者和 AI 代理提供了“局部性”(locality),创建了可版本控制、可对比的架构决策记录,并确立了一个比单纯的测试代码更具可读性和可操作性的真理源。 Gross 构想了一种工作流程,即 Markdown 作为高级规范,代码和测试皆由此衍生。他建议采用标准化的 `/src/md` 结构来存放技术概览、数据模型和功能规范。尽管这需要人为进行严谨的维护以管理复杂性,但 Gross 断言,随着编码自动化的成本降低,捕捉系统背后的“意图”将成为现代软件开发中最宝贵的资产。
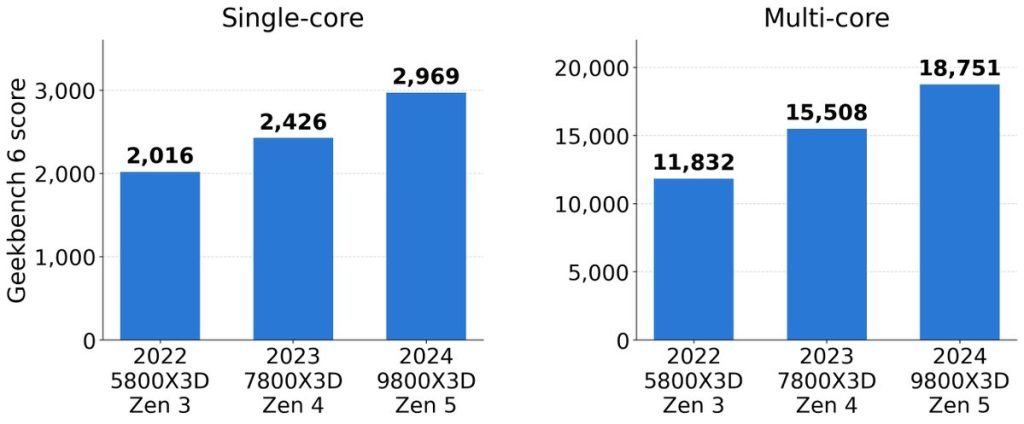 与CPU技术停滞不前的观点相反,AMD的Ryzen 7 “X3D”系列展示了显著且持续的性能增长。对比Zen 3 (5800X3D)、Zen 4 (7800X3D) 和 Zen 5 (9800X3D) 处理器,2022年至2024年间,其单核性能提升了47%,多核性能提升了58%。
这些增长并非仅靠时钟频率驱动,时钟频率仅有15%的适度增长。相反,AMD通过增加50%的晶体管数量使核心显著“变宽”来实现这些成果。关键的架构改进包括更高的发射宽度(从每周期6条指令增加到8条)、更大的缓存容量、更多的整数算术逻辑单元(ALU),以及更大的重排序缓冲区以更好地管理指令流。此外,Zen 5通过将SIMD单元加倍至512位宽度,标志着数据并行处理的重大转变。随着业界展望Zen 6,这些桌面芯片的演进证明了CPU创新依然充满活力且激进。
OpenAI 近日声称在纳维-斯托克斯方程问题上取得了突破,该问题是克雷数学研究所设立的一项著名难题。尽管从技术上讲,该证明符合原始命题的标准,但数学家们认为它利用了一个漏洞,即引入了外力——这在他们看来是不符合物理本质的,且与他们试图理解的基础物理学脱节。 专家指出,OpenAI 的模型解决的是该问题的一个特定且人为构建的变体,而非核心数学难题。数学家随后的分析表明,该 AI 的方法无法扩展到科学界真正重视的问题版本。本质上,该 AI 成功绕过了奖项的形式要求,却错失了潜在的物理意义,这突显了数学命题的死板措辞与理论研究细微目标之间的区别。 这场争议凸显了当前大语言模型的局限性:它们擅长在复杂的约束条件下找到明确的特定解,但在推进数学发展所需的深层原创理论方面却显得力不从心。这一事件也敲响了警钟,表明尽管 AI 是暴力搜索发现的有力工具,但数学领域最具深度的“人类”挑战在很大程度上仍超出其能力范围。
为遵守全球年龄认证相关法律,Discord 即将引入一套自动化系统,将用户分为“成人”(18岁及以上)或“青少年”(13至17岁)组别。 该系统基于账户行为(如账户注册时长和社区活跃度)使用年龄估算模型,而非查看私人信息。超过 90% 的用户将自动归类,无需采取任何行动。成人组用户的使用体验不会发生变化,而青少年用户将获得额外的安全保护,例如模糊处理敏感内容以及限制访问设有年龄门槛的服务器。 状态为“未确认”或认为归类有误的用户,可以通过多种注重隐私的方式手动验证年龄,包括信用卡验证、共享 Apple/Google 账户年龄信息或使用 AgeKey。Discord 强调,他们不会存储个人身份信息或生物识别数据,仅会从第三方供应商处获取年龄组别信号。 其他用户无法查看您的年龄状态,且消息发送、非受限语音通话等核心功能对所有用户保持开放。如果您此前已完成年龄验证,您的状态将保持不变。您可以在“用户设置”>“账户状态”中查看当前的年龄组别。
“我们黑进了FBI”:黑客声称掌握了所有FBI员工的数据 'We hacked the FBI:' Hackers say they have data on all FBI employees
23 天前
黑客组织“ShinyHunters”声称已侵入联邦调查局(FBI)系统,据称窃取了 2 至 3 TB 的数据,其中包括所有现任和前任 FBI 员工及申请人的个人信息。该组织声称他们利用了甲骨文(Oracle)PeopleSoft 软件中的一个零日漏洞,从而入侵了亚马逊云科技(AWS)的 GovCloud 服务器。 为了支持其说法,黑客向 404 Media 提供了一份包含 5,000 条记录的样本,其中涵盖了姓名、家庭住址、电话号码和配偶详细信息,研究人员已使用开源情报工具对这些数据进行了核实。该组织还曾短暂篡改了 FBI 的招聘网站。 尽管 ShinyHunters 以勒索著称,但他们称此次特定攻击并非出于经济动机,而是为了“胁迫”。此次泄密造成了严重的国家安全风险,因为这些敏感个人数据可能被外国情报机构或犯罪组织利用,以跟踪、骚扰或恐吓特工。FBI 尚未对此置评,但受影响的招聘门户网站已下线。
这篇 Hacker News 讨论主要围绕 *404 Media* 的一篇报道展开,该报道称黑客组织“ShinyHunters”已攻破了一个属于美国联邦调查局(FBI)的大型数据库,据称窃取了数 TB 的数据,其中包括员工及其配偶的个人信息。
讨论探讨了几个关键主题:
* **安全宿命论与能力之争:** 许多参与者认为,鉴于现代系统的复杂性,实现真正的计算机安全本质上是不可能的,并主张任何连接互联网的设备都应被视为“半公开”状态。另一些人则反驳称,安全的系统是可能实现的,但由于企业在速度、成本和便利性方面优先于稳健的“默认安全”架构,这类系统往往沦为“小众”。
* **系统性失灵:** 评论者指出,使用存在漏洞的第三方企业软件(特别是 Oracle/PeopleSoft)是主要的故障点。人们对政府和企业的激励机制提出了严厉批评,指出组织在发生疏忽时很少面临严重后果,这使得安全工作沦为“做样子”,而非真正的优先事项。
* **“人为”因素:** 讨论强调,无论技术防护措施如何,人为因素——从社会工程学和管理不善,到故意解雇经验丰富的人员——始终是最终的弱点。
* **基础设施风险:** 该贴文讨论了将关键基础设施(如水、电)连接到互联网的危险性,认为追求运营效率的行为已经造成了不可接受的国家安全风险。
本仓库是官方的 **GeaStack 应用库**,收录了模拟器、GeaOS、嵌入式目标平台以及 IDE 扩展的示例。每个项目都是一个独立的包,通过 `package.json` 中的 `gea` 清单进行定义,并指定了运行时目标(Web、ESP32、GeaOS)及元数据。 **核心工作流亮点:** * **开发:** 使用 `geastack/simulator` 仓库来运行和构建应用,只需将 `GEA_APPS_ROOT` 环境变量指向本目录即可。 * **部署:** 通过 Gea CLI 使用 `npx gea flash` 直接烧录到兼容硬件。 * **最佳实践:** 示例应保持小巧、专注,并优先使用共享框架 API,而非针对特定目标的“黑客”写法。贡献者应为复杂逻辑编写测试,并保持文档更新。 **许可协议:** 本仓库采用 **MIT** 协议,允许开源或闭源使用。请注意,特定的嵌入式板卡支持组件采用 **GPL-3.0** 协议;若需使用这些特定工具发布闭源固件,则需要获得商业授权。如需支持或进行商业咨询,请联系 [email protected]。
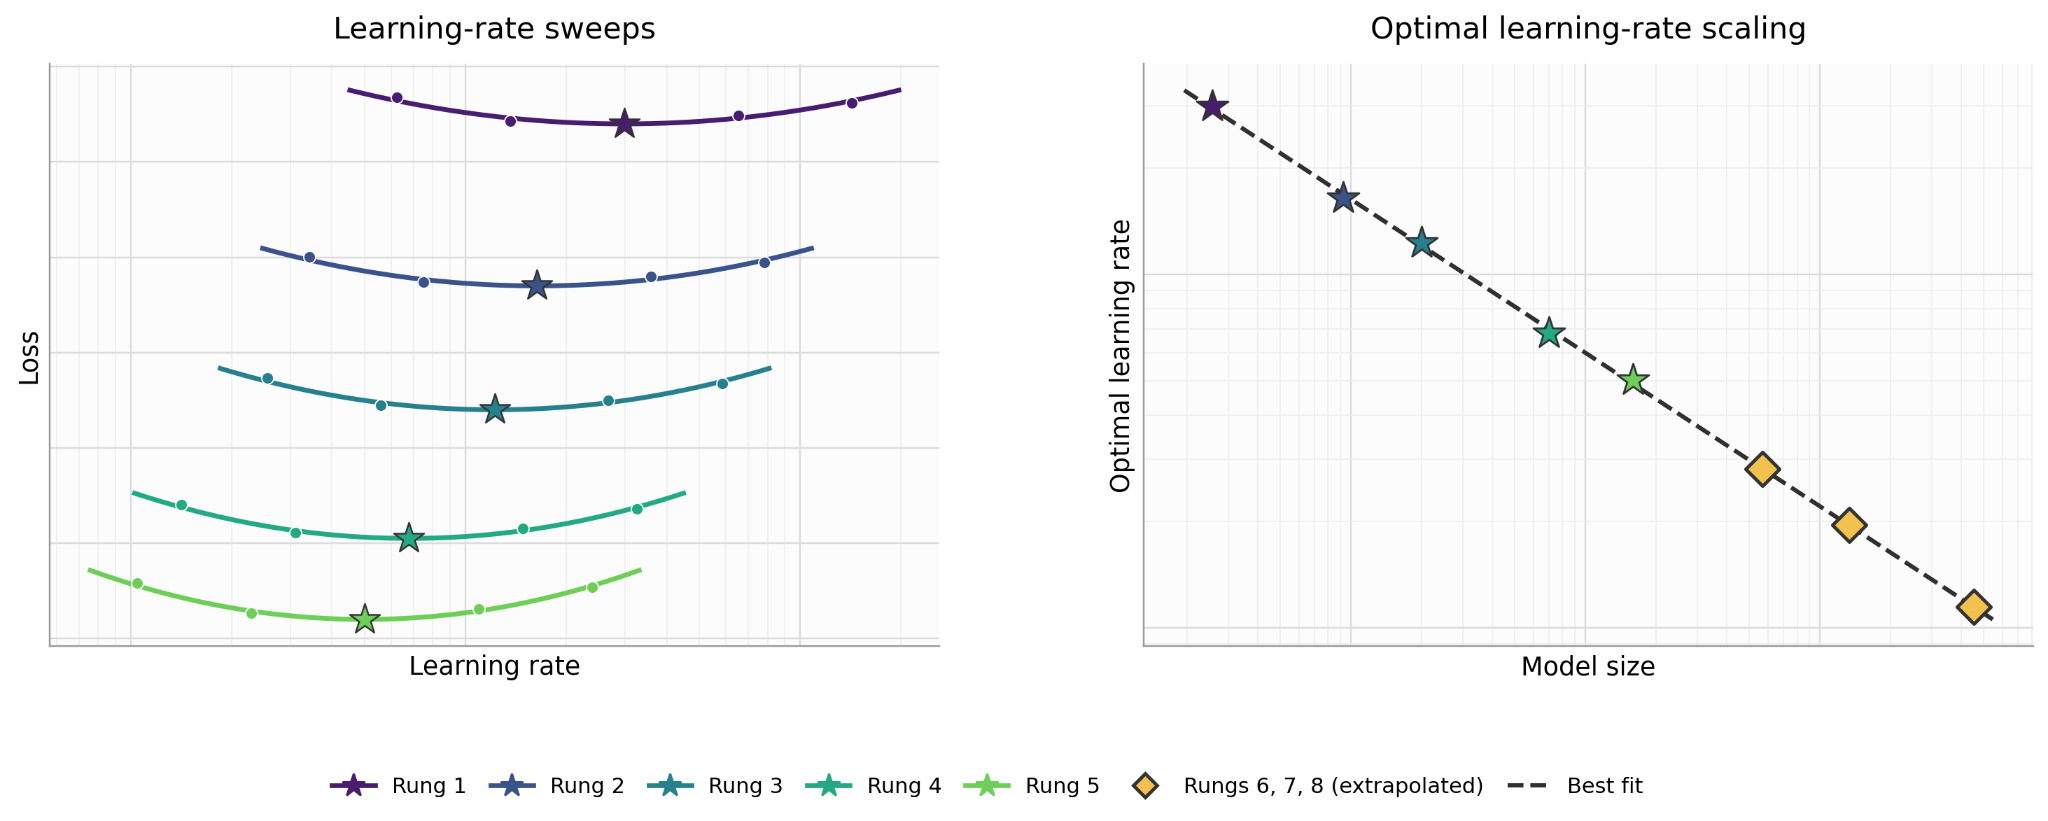 这项研究探讨了大型语言模型(LLMs)如何从不同规模的加权训练数据中进行学习,并引入了“有效序列权重指数”($\alpha$)来量化模型根据分配权重优先处理序列的程度。
研究表明,数据加权并不遵循简单的单调缩放定律,而是呈现出一种“异常”行为:
* **小规模模型**的 $\alpha$ 值较低,主要学习独立于特定数据权重的通用模式。
* **中等规模模型**的 $\alpha$ 值较高,其容量主要集中在与分配权重成正比的模式上。
* **大规模模型**的 $\alpha$ 值回落至较低水平,具备了学习数据中所有模式的能力,而不受权重影响。
研究人员指出,这种趋势会随训练轮次(epoching)而变化,且在不同的模型架构中表现各异。由于小规模模型的表现往往无法预测大规模的结果,作者提醒研究者不要单纯依赖简单的外推法来制定数据混合策略。他们总结认为,识别这些非单调行为对于优化训练方法、确保缩放实验的可靠性,并最终开发出能力更强的模型至关重要。
这项研究介绍了 **C-HD**,这是一种用于在具有非负实数权重的有向图中寻找精确最短路径的新型确定性算法。该算法由人工智能体协作团队开发,并使用 **Lean** 进行形式化验证,以确保其正确性和性能。 在 $m \le n \lfloor \log_2 n \rfloor^{3/4}$ 的特定密度范围内,C-HD 的复杂度达到了 $O(n + m + m \log(2 + \frac{m}{n+1}) + m^{1/3}(n \log(n+2))^{2/3})$。通过利用有界局部搜索并保持严格的局部不变性,该算法相比 Dijkstra 及其他顶尖方法减少了重复工作。 在 $m \approx n \log^{3/4} n$ 的图中,C-HD 在理论上比 Dijkstra 的 $O(n \log n)$ 界限有了渐近改进,达到 $O(n \log^{11/12} n)$。尽管这在理论计算机科学中是一个显著的多对数级进展,但研究人员指出,由于该结构涉及较大的常数,它更多是对算法性能的数学证明,而非针对实际应用的性能提升。该项目展示了多智能体协作在推动形式化数学验证和算法优化边界方面的潜力。
在构建智能推荐系统“HoneyCrew”的一场高压黑客马拉松中,团队遭遇了危机。在利用“灵感编程”(vibe coding)工具取得初步进展后,项目在最后几个小时陷入了漏洞频发和不稳定的困境。这种混乱凸显了非技术利益相关者与工程复杂现实之间常见的摩擦——前者往往将软件开发视为一项简单、静态的任务。 作者用房屋翻修的类比来解释这种复杂性:正如盖房子需要地基设施,如果事后补救成本高昂,软件开发也需要规划和“基础设施工作”来确保长期稳定性。“在漏水屋顶下放水桶”的方法或许能提供暂时的快速修复,但它忽略了根本原因,最终会导致崩塌。 最终,团队不得不放弃狂乱的节奏,放慢速度,有条不紊地修复系统,从而制作出了可运行的演示版本。这段经历提醒我们,好的软件永远不会真正“完成”;它是一个活生生的结构,需要人们在其中居住的同时进行持续、用心的维护。