现代智能手机依靠一组专门的组件来运行: * **处理器:** **CPU** 是通用大脑,利用高性能和高能效核心每秒处理数十亿条指令。**GPU** 并行工作以渲染复杂的视觉效果,而 **NPU** 则专为面部识别和模式匹配等人工智能任务而设计。 * **内存:** 数据存储分为三个层级。**高速缓存 (Cache)** 速度极快但容量较小,位于 CPU 内部。**RAM** 作为运行中应用程序的较大临时工作区,而 **闪存 (Flash storage)** 则为文件和软件提供长期、非易失性的存储空间。 * **安全性:** **安全处理单元** 充当数字保险库,隔离生物识别数据和支付凭证等敏感信息。它不会直接泄露原始机密,而是提供加密的一次性验证,以确保设备安全。 这些组件共同平衡了高速计算、视觉渲染、智能模式识别和强大的数据保护,从而提供无缝的用户体验。
每日HackerNews RSS
Hacker News 讨论了网站“Everything Machine”,该网站旨在探索智能手机的内部组件。作者称智能手机是“你所持有过最复杂的机器”,这一说法在评论区引发了巨大争议。
批评者大多对此不以为然,认为该内容充斥着幼稚的文笔和通用的“大模型味”,即所谓的“AI 垃圾”。许多用户指出,文章缺乏高质量科普网站应有的人文色彩和技术严谨性,存在事实错误及解释模糊的问题。
争论的焦点在于智能手机是否真的能被称为“最复杂”的机器。尽管作者辩称手机集成了大量的传感器及多种工程领域,但怀疑论者将其与机械手表、惯性导航系统甚至生物体进行了对比,认为手机表现逊色。一些用户认为,现代制造业使得智能手机这类量产产品,不如定制的复杂机械那样令人印象深刻。尽管面临批评,作者仍与社区积极互动,在为该项目的初衷——作为普通大众了解技术历史的入门途径——进行辩护的同时,也承认了需要进一步优化和修正事实。
请启用 JavaScript 和 Cookie 以继续。
数据压缩与大型语言模型(LLM)本质上是相同的技术:两者都是旨在最小化信息熵的预测引擎。 传统的压缩工具由两个主要部分组成:一个用于估计符号出现概率的**模型**,以及一个使用这些概率将数据表示为紧凑比特序列的**熵编码器**(如算术编码)。当数据包含冗余时,压缩效果最好,因为更高概率的预测可以显著减小文件大小。 LLM 遵循完全相同的原理。当 LLM 预测序列中的下一个标记(token)时,它实际上是在根据上下文分配概率。在信息论中,LLM 训练所要最小化的“交叉熵”,与衡量压缩器效率所使用的数学原理是相同的。从理论上讲,一个训练完美的模型可以实现最大可能的压缩。 虽然与传统算法相比,LLM 是更优越的预测器,但它们目前并不适用于通用文件压缩。巨大的计算成本和模型本身的庞大体积,使得它们对于网页浏览等日常任务来说显得“杀鸡用牛刀”。然而,归根结底,压缩和人工智能是同一枚硬币的两面:**压缩即预测,而 LLM 就是压缩器。**
所提供的 Hacker News 讨论帖探讨了一个论点:**压缩和预测是同一枚硬币的两面。**其核心思想是,能够预测序列中下一个元素的系统(如大语言模型)通过识别模式和冗余,实际上是在进行隐式压缩。反之,一个高效的压缩器,本质上也是一个已经“学习”到输入数据底层规则的模型。
**讨论中的关键点包括:**
* **历史背景:** 许多用户指出,这是信息论(香农)和计算机科学(所罗门诺夫归纳、赫特奖)中早已确立的原则,其历史可追溯至几十年前。
* **智能的本质:** 支持者认为,“理解”等同于找到对世界的简洁表征。然而,批评者提醒不要过度简化:他们认为虽然预测可以为压缩提供依据,但两者并不完全等同。一些人指出,“预测”需要泛化到新数据,而“压缩”可能只是针对静态数据集的过拟合练习。
* **对该博文的批评:** 一些评论者对该文章缺乏历史引用表示不满,认为它将一个古老的基础概念包装成“新发现”,这会对读者产生误导。
本系列文章深入探讨 PyTorch 的内部架构,剥离代码与底层硬件之间的抽象层。它旨在说明 PyTorch 不仅仅是一个简单的库,而是一个由 Python 层、C++ 边界、调度器以及各种硬件内核组成的多层系统。 本系列建立在十二个核心概念之上,例如作为内存“窗口”的张量、自动求导图的本质,以及 CPU 和 GPU 时钟之间的差异。每个观点均配有可运行的验证脚本,以确保读者能够理解该框架在实践中是如何运作的。 主要内容包括: * **分层架构:** Python 只是庞大且已编译的 C++ 主体的一层轻量接口。 * **调度器(Dispatcher):** 一个中央路由系统,根据操作类型和硬件决定执行哪个内核。 * **双时钟问题:** Python 和 GPU 异步运行;理解这一队列机制对于精确的性能调优至关重要。 * **可预测性:** 通过掌握核心代码仓库的结构和这十二项原则,您可以揭开从内存管理到分布式训练等复杂行为背后的神秘面纱。 最终,这份指南将使您能够阅读源代码,并构建属于自己的类 PyTorch 系统。
对不起。
Nvidia Nemotron 3.5 Lightning 与 Nemo Switchyard Nvidia Nemotron 3.5 Lightning and NeMo Switchyard
81 天前
 NVIDIA 推出了 **Nemotron 3.5 Lightning** 和 **NeMo Switchyard**,旨在提升自主 AI 代理系统的效率与控制力。
**Nemotron 3.5 Lightning** 是一款拥有 300 亿参数的混合专家(MoE)开源模型,专为高容量、专业化的代理任务而优化。与同类模型相比,它在保持前沿准确性的同时,输出速度提升了 4 倍,任务完成速度提高了 30%。该模型专为定制化设计,允许企业针对网络安全、编程或法律服务等特定领域的工作流程进行微调,并通过在工作站、数据中心或云端本地运行,确保了对隐私的完全掌控。
作为补充,NVIDIA 发布了 **NeMo Switchyard**,这是一个旨在实现“模型路由”自动化的开源库。它能智能地将每个请求导向代理集合中最合适的模型——无论是开源模型、专有模型还是 NVIDIA 旗下的模型。通过确保每个特定任务由最合适的模型处理,Switchyard 能够优化性能、显著降低延迟并减少运营成本,且无需开发人员重写应用程序。
这些工具共同助力企业构建更智能、更具成本效益的 AI 代理,使其能够在利用多元化模型生态系统的同时,保持现代企业部署所需的自主性与可扩展性。
这篇 Hacker News 的讨论聚焦于混合专家模型(MoE)与稠密大语言模型(Dense LLM)在编程及智能体任务中的性能权衡。
用户反馈称,尽管英伟达的 **Nemotron 3.5 Lightning** 等 MoE 模型速度表现出色,但在处理复杂的多步编程任务时,往往不如 **Gemma 4-31B** 或 **Qwen 3.6-27B** 等展现出更强推理能力的稠密模型。参与者认为,MoE 的效率(通常通过总参数与活跃参数的几何平均值来计算)并不能完美代表其智能水平。
讨论还强调了以下几点:
* **工具偏好:** 用户讨论了 Ollama 等工具的效用,许多人更倾向于使用 **LM Studio** 或直接使用 **llama.cpp**,以实现更好的硬件控制和量化策略。
* **对路由技术的怀疑:** 对于英伟达的 **NeMo Switchyard**,讨论普遍持怀疑态度;参与者质疑智能模型路由在实际应用中的价值,并指出其在提示词缓存和管理多模型架构方面可能存在的复杂性。
* **未来展望:** 业界是应优先发展参数庞大的巨型模型,还是专注于结构优化以实现高效、强大的本地人工智能,这引发了广泛争论。一些人指出,当前的硬件限制正迫使业界关注早已该被重视的算法效率问题。
请启用 JavaScript 并关闭所有广告拦截器
抱歉。
为了将网页排版提升到基础字体之外,CSS 提供了几种功能强大的属性,可以增加视觉趣味性和精确度。以下是五个必备工具: 1. **`background-clip: text`**:允许在文本字符内遮罩图像或渐变,从而创建引人注目的填充字形。 2. **`vertical-align` 和 `align-content`**:`vertical-align` 用于管理行内元素(如图标)相对于文本的对齐方式,而现代的 `align-content` 属性则能够实现块级盒内文本的垂直居中。 3. **`box-decoration-break: clone`**:确保在文本换行或断行时,样式(如边框、内边距和阴影)能均匀地应用于每一行,避免边缘不连贯。 4. **`letter-spacing`**:除了调整可读性外,该属性还是动画的强大工具,通过操纵字符之间的间距,可以实现动态的文本揭示效果。 5. **`text-combine-upright`**:专为垂直书写模式设计,允许短字符串(如日期或度量单位)在垂直布局中水平显示,从而保持整洁、专业的排版效果。 掌握这些属性,你将拥有一个多功能的工具箱,为网页排版增添精致的细节和引人入胜的动态效果。
这篇 Hacker News 讨论帖围绕一篇关于文本设计 CSS 属性的文章展开,用户在其中提出了技术性更正和最佳实践建议。
主要内容包括:
* **技术注意事项:** 贡献者指出 `background-clip: text` 存在缺陷,建议使用 `-webkit-text-fill-color: transparent` 以获得更好的兼容性。另有人建议使用 `@supports` 查询来实现更稳健的代码。
* **排版建议:** 评论者认为 `letter-spacing`(字间距)常被滥用,且往往会损害正文的可读性。通常认为该属性仅适用于艺术标题或特定的全大写场景。
* **现代 CSS 资源:** 用户强调应摒弃过时的“黑客”思维。他们建议查阅 **MDN** 文档,并使用 **Baseline**(已集成在 *Can I Use* 中)来判断某项 CSS 特性是否因具备广泛的浏览器支持而可安全用于生产环境。
* **行业转变:** 目前有一种趋势,即利用现代 CSS 取代 JavaScript 来实现弹出窗口和移动端菜单等 UI 元素,从而提升网页性能。普遍共识是:应优先考虑浏览器兼容性和规范标准,而非盲目追逐每一个新特性。
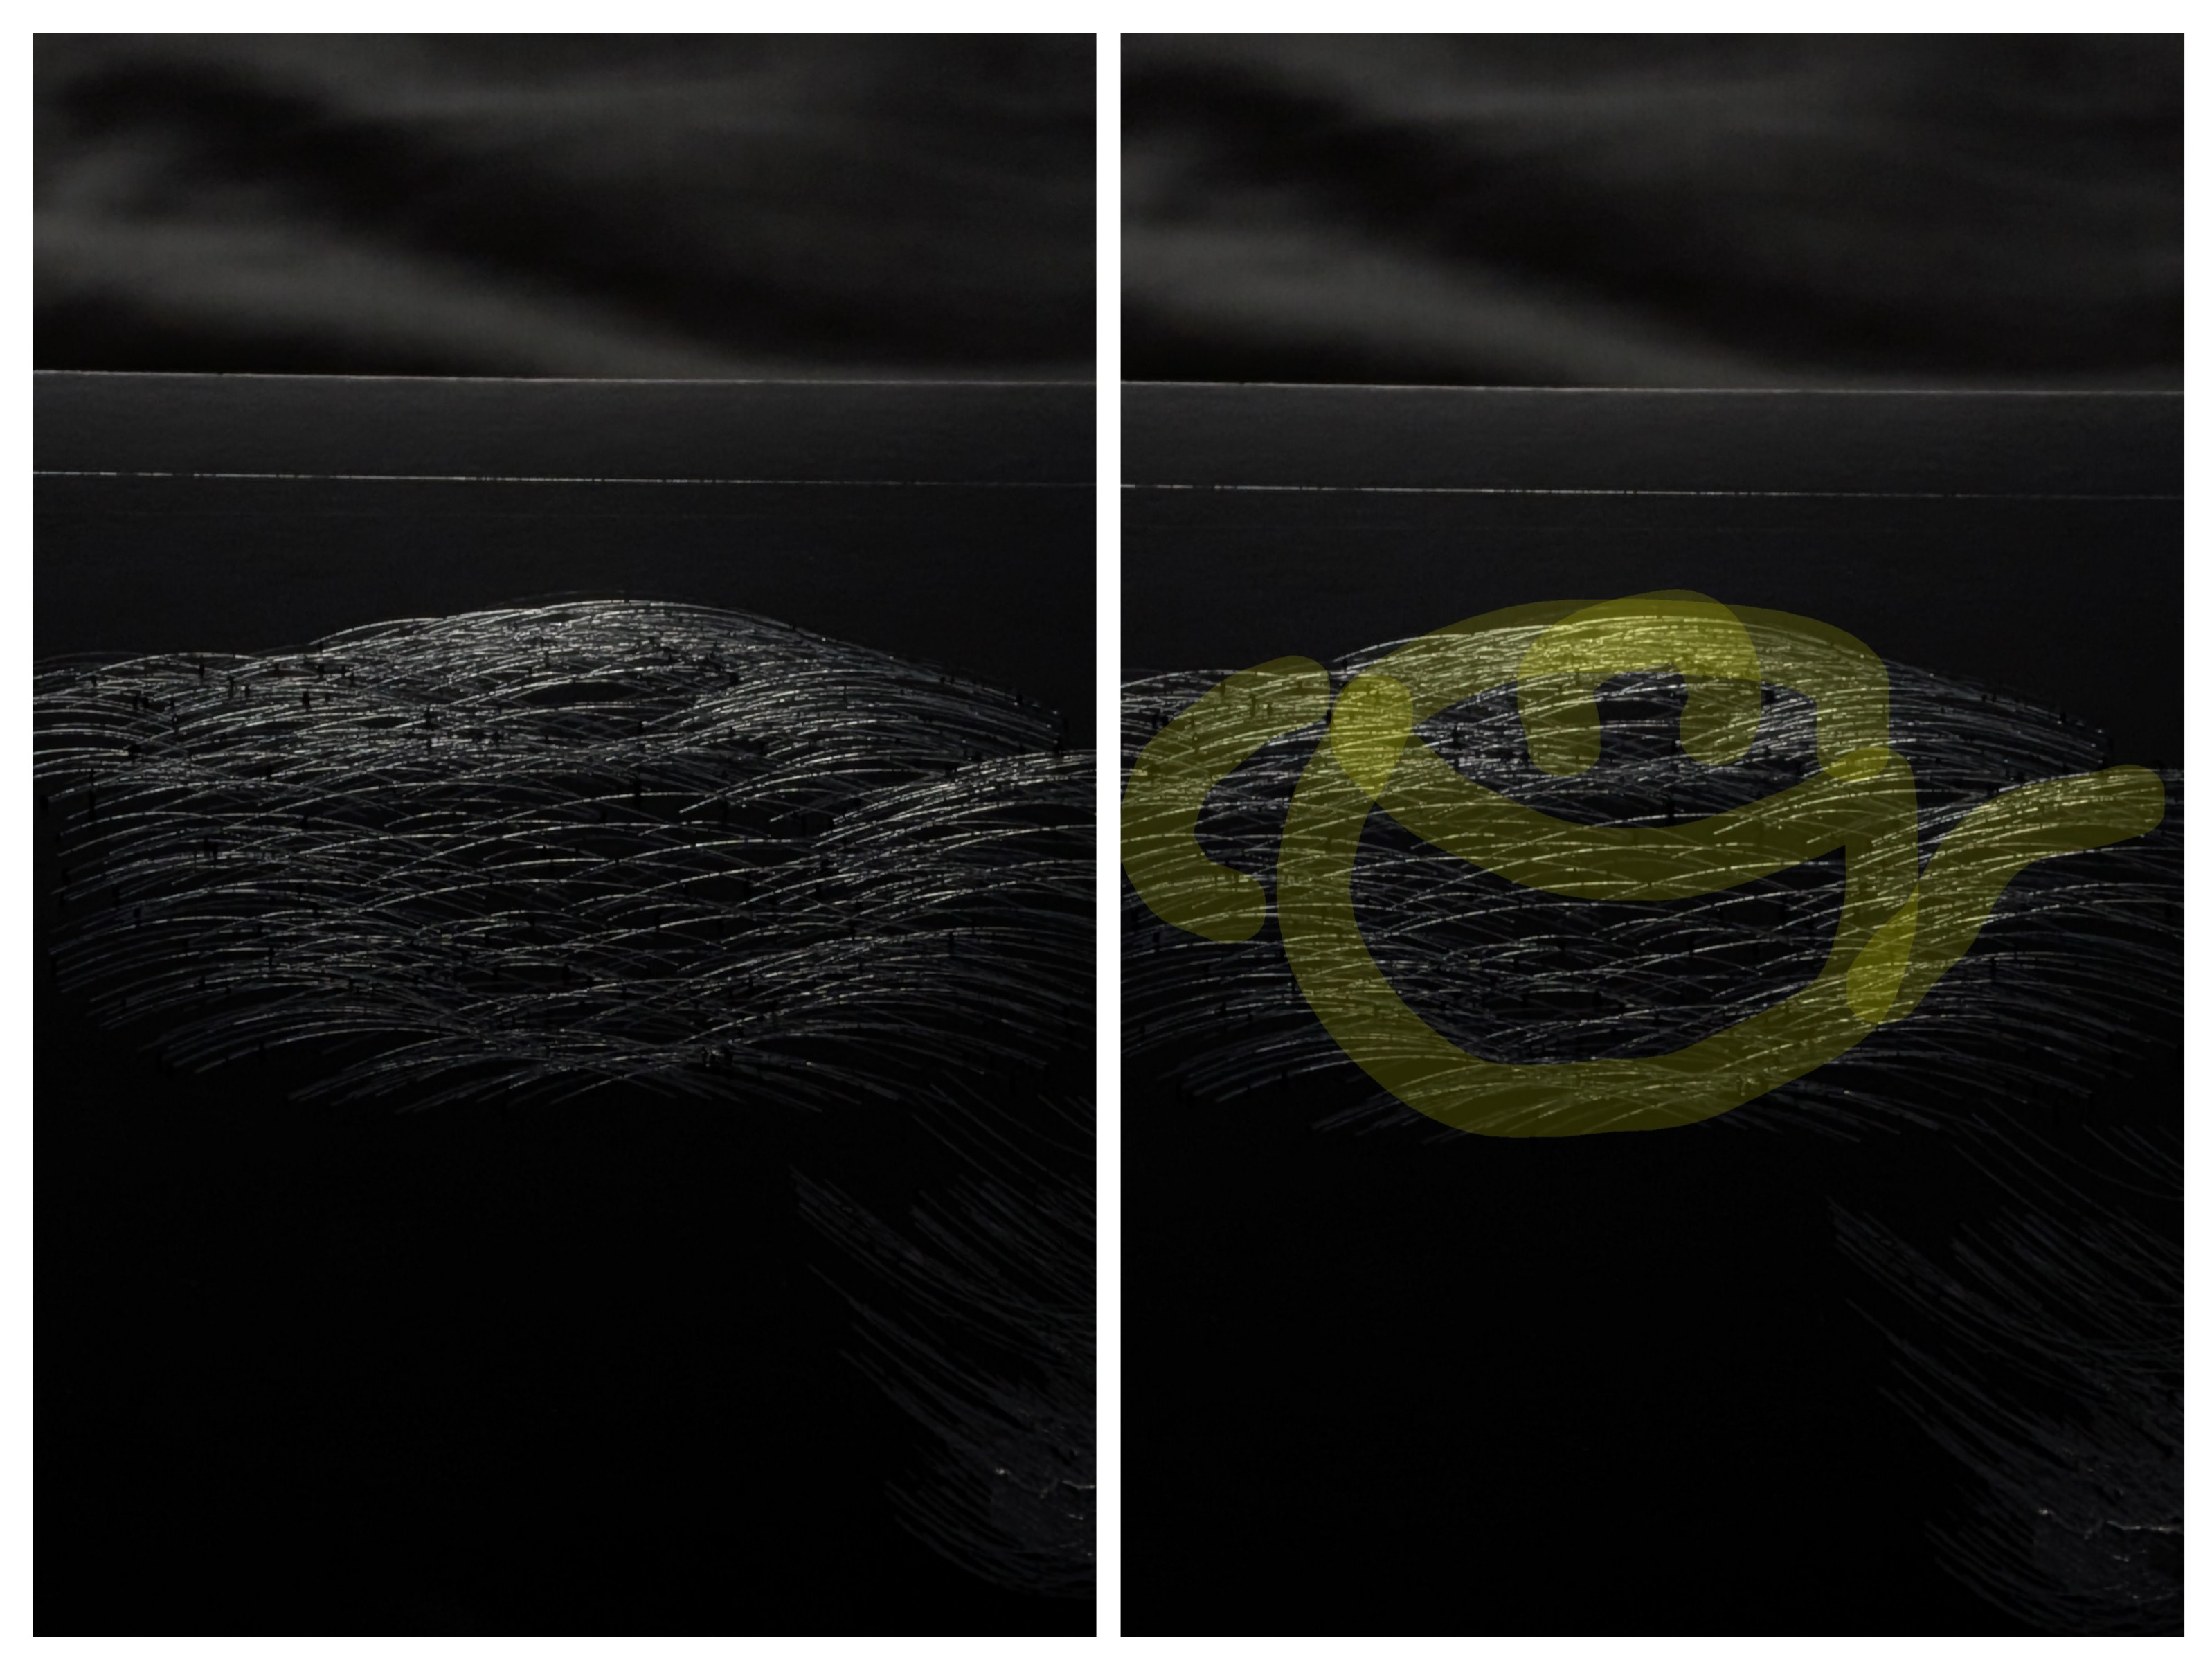 作者探讨了使用绘图仪制作“手工蚀刻全息图”的过程。通过改造一台购自 eBay 且性能不稳定的绘图仪,在塑料 CD 盒上蚀刻图案,作者展示了物理纹路如何通过操纵光线来制造 3D 深度错觉。
其核心洞察在于:光反射在曲面上的速度和移动轨迹与该曲线的半径成反比,这模拟了现实物体相对于观察者的移动方式。通过绘图仪将场景“渲染”为特定的、经数学计算的曲线,作者制作出了能投射 3D 图像的反射表面。
尽管材料选择颇具挑战(塑料层压板和蜡纸均以失败告终,最终在亚克力上取得成功),但作者通过尖头刻针和点光源成功实现了全息效果。虽然技术上并不复杂,但该过程产生的视觉错觉令人惊叹,证明了无需昂贵的激光设备,也能在家里复刻高端物理实验。作者总结道,这种直观的全息摄影方法既充满魔力,又是古代文明可能触及的技术,突显了利用简单工具探索物理之美。
抱歉。

OpenAI 伦理部门负责人的离职在 Hacker News 上引发了关于企业伦理部门有效性的讨论。批评者认为,科技公司的“伦理”职位往往只是做样子的公关噱头,或者说是“现代版多元、公平与包容(DEI)”式的成本中心,旨在为领导层提供掩护,却缺乏真正的决策权。
评论者指出,当一个部门的唯一职能就是对其他团队说“不”时,它不可避免地会被边缘化或绕过。许多人认为,如果没有法律或监管方面的“强制力”(类似于安全或合规团队的运作方式),伦理部门注定会失败,因为它们从根本上与利润驱动的动机相冲突。另一些人则指出,在大公司中,伦理通常排在商业利益之后,这使得这些职位要么显得无能为力,要么只能专注于“道德表演”以安抚投资者和公众。
一些参与讨论者则反驳称,问题不在于这一职能本身,而在于组织成熟度的缺失以及缺乏自上而下的承诺。他们认为,要使伦理工作真正发挥作用,必须将其整合到产品和工程流程中,而不是将其视为一个独立的对抗性部门。归根结底,这场讨论反映了人们对科技行业在缺乏外部压力或问责机制的情况下,是否具备自我监管能力的深层怀疑。
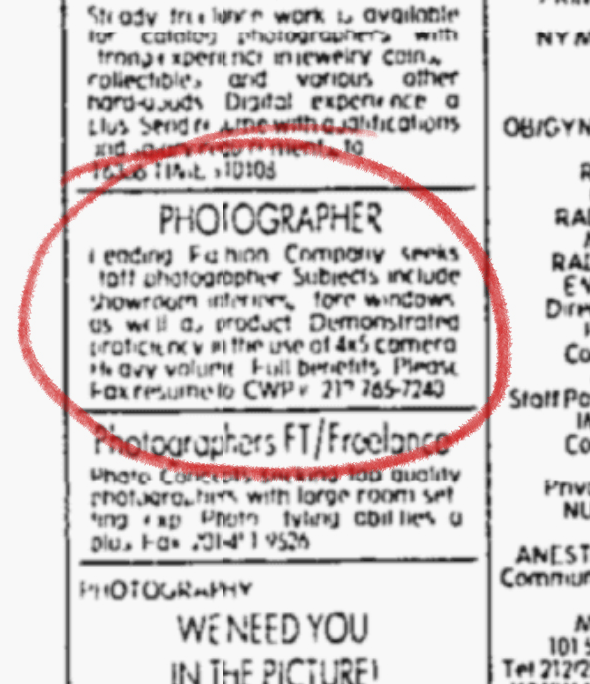 2000年,作者获得了一份“梦寐以求的工作”,担任拉夫劳伦(Polo Ralph Lauren)的内部摄影师。长期以来,他一直将这一职业生涯的里程碑归功于《纽约时报》上的一则分类广告。
最近,作者利用自己精心整理的数字档案和《纽约时报》的数据库(Times Machine)来核实这段往事。他成功找到了那则2000年的原始招聘启事,并确认了自己当年是通过传真申请的。虽然搜索证实了客观事实,但也突显了记忆的不可靠性。他反思了过去模糊的细节:他声称在申请前通过某种不可思议的方式识别出了那家匿名公司,以及他未来的老板关于“一大堆简历”的一句生动却很可能是虚构的引语。
归根结底,这次回顾是一次怀旧的沉思,探讨了我们如何构建个人历史。通过重温前数字时代就业市场的遗迹,作者探讨了既定事实与我们自述故事之间的张力,并促使读者反思自己在纸质分类广告时代寻找人生机遇的记忆。
抱歉。