为什么选择 GoAccess?GoAccess 是一款专为快速处理而设计的终端日志分析工具。其核心理念在于无需浏览器即可实时分析并查看 Web 服务器统计信息(非常适合通过 SSH 对访问日志进行快速分析,或适用于偏好终端操作的用户)。它也是一款实用的安全监控工具,能够直接从日志中轻松识别可疑活动、异常流量模式、暴力破解尝试、扫描器、机器人程序及异常请求。虽然终端界面是其默认输出方式,但它同时也支持生成完整、独立的实时 HTML 报告(便于进行分析、监控及数据可视化),以及 JSON 和 CSV 格式的报告。
每日HackerNews RSS
GoAccess – 开源实时日志分析器与交互式查看器 GoAccess – Open-source real-time log analyzer and interactive viewer
78 天前
抱歉。
Gemini 3.7 Flash 在以下三个关键领域较 3.6 Flash 展现出了显著的性能提升: * **编程与开发:** 该模型在调试、问题解决以及生产级代码生成方面取得了长足进步,在 FrontierCode(43.6% 对比 34.4%)和 DeepSWE(65.3% 对比 49.0%)基准测试中表现尤为突出。 * **Web 开发:** 在 UI 生成方面表现卓越,具有更佳的设计还原度和功能性布局创建能力。其优势体现在更高的 WebDev Arena Elo 分数(1588 对比 1538)上。 * **复杂推理:** 在金融、法律和生物科学等专业领域,3.7 Flash 展示了更强的推理能力和准确性。在文档处理任务中,它大幅超越了前代产品(GDP.pdf 测试中为 34.0% 对比 22.0%),并在通过 AutomationBench 执行实际业务工作流时表现出更高的效率(30.4% 对比 17.0%)。 总而言之,Gemini 3.7 Flash 在准确性、技术能力和实用工作流自动化方面均实现了显著进步。
关于 Google **Gemini 3.7 Flash** 发布的 Hacker News 讨论显示,社区对于该模型的价值及其背后的 Google 战略存在分歧。
**核心主题:**
* **性能表现:** 许多用户认为 3.7 Flash 在处理“足够好”的多模态和编程任务时速度极快且具有竞争力。然而,资深用户指出,在复杂推理和可靠性方面,它仍落后于 Claude (Sonnet) 等前沿模型或 GPT-5.6 (Luna) 等专用模型,一些开发者报告该模型存在频繁的幻觉问题。
* **“Flash”战略:** 批评者质疑为什么 Google 持续发布高速的中端模型,而非推出旗舰级“Pro”模型来挑战 SOTA(当前最佳)领跑者。一些人认为,Google 更倾向于优化通用生态,而非追求顶尖的编程性能。
* **摩擦与基础设施:** 一个反复出现的抱怨是“Google 规模化”带来的用户体验问题。相比 OpenAI 或 OpenRouter 等竞争对手,用户认为 Google Cloud/Vertex 环境中的 API 入门、计费和项目管理过于复杂。
* **定价疑虑:** 针对“优惠定价”将于 2026 年 12 月结束的规定,舆论普遍将其嘲讽为一种人为的官僚手段。用户指出,在瞬息万变的 AI 领域,该模型在价格上涨生效之前很可能就已经被淘汰了。
吐火罗语在线 Tocharian Online
78 天前
吐火罗语是指两种关系密切但各不相同的印欧语系语言,即吐火罗语A和B。它们于20世纪初在现今中国新疆境内的丝绸之路上被发现。这些语言主要记录于公元6至8世纪,大多保存在佛教寺院的手稿中。吐火罗语A可能仅限于吐鲁番地区,且可能仅用于宗教仪式;而吐火罗语B的地理分布更为广泛,并出现在世俗记录中。 “吐火罗语”这一名称是一个历史性的误称,最初源于对一段古突厥语文本的误解,但目前仍被广泛使用。在语言学上,吐火罗语作为印欧语系最东端的分支而引人注目。作为一种位于东方的“肯特语”(centum language),它挑战了关于印欧语方言地理分布的传统理论。吐火罗语还表现出与其起源显著的语言偏差,包括简化的语音系统和复杂的黏着语格系统;这些特征很可能是由于与周边乌拉尔语、突厥语和蒙古语长期接触所致。尽管其地位独特,但吐火罗语的语料库规模较小且零碎,很大程度上依赖于沙漠寺院遗址的考古发现。
抱歉。
请启用 JavaScript 和 Cookie 以继续。
Hacker News
最新 | 往期 | 评论 | 提问 | 展示 | 招聘 | 提交
登录
翻译文艺复兴:17,000 多份历史原始文献 (sourcelibrary.org)
由 dr_dshiv 发布于 1 天前,22 点 | 隐藏 | 往期 | 收藏 | 讨论 | 帮助
指南 | 常见问题 | 列表 | API | 安全 | 法律 | 申请 YC | 联系
搜索:
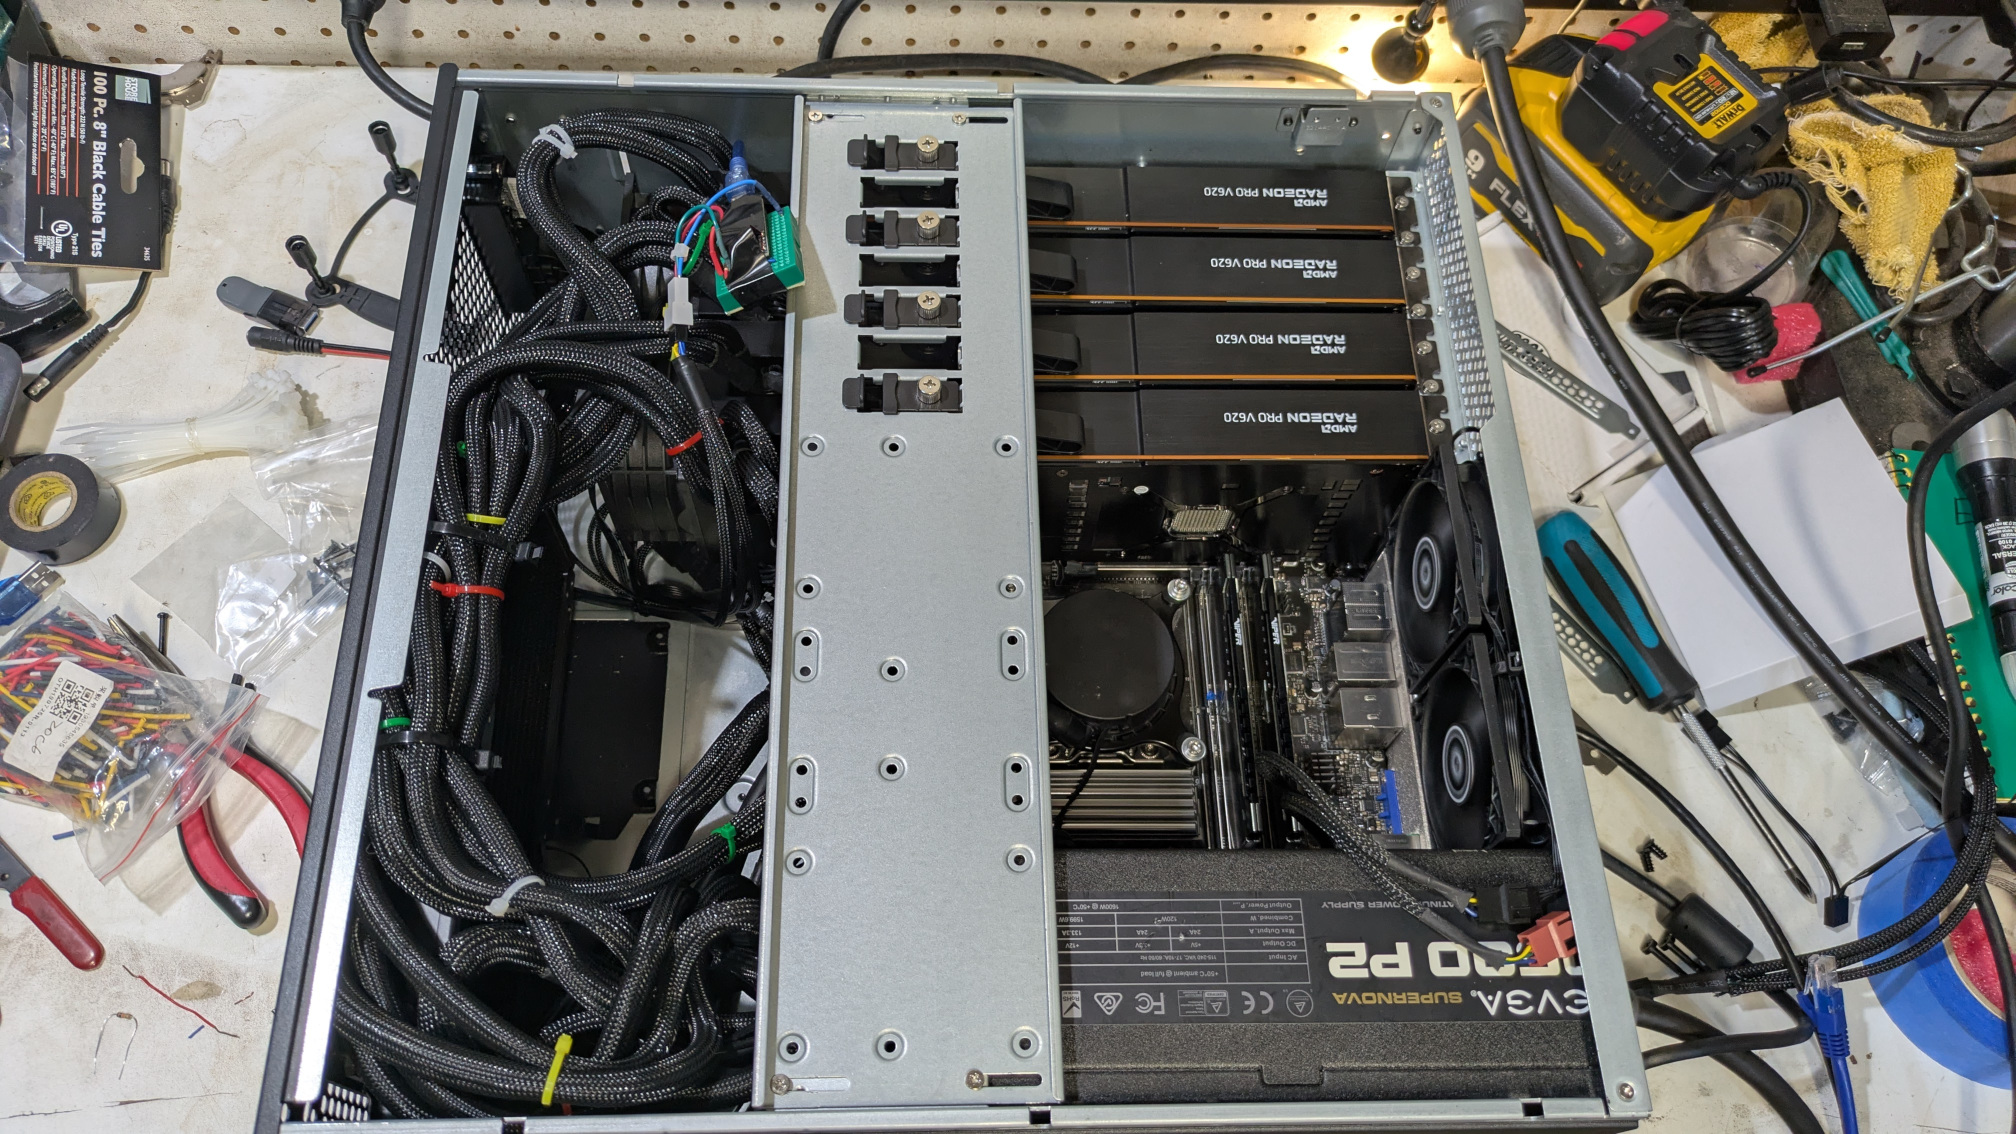 作者身为一名软件开发人员,为重掌 AI 编程代理的控制权,决定不再依赖云服务,而是着手构建私有的本地 AI 数据中心。出于对硬件自主权和成本效益的追求,他利用回收的电子废料组装了一台强力设备。
该系统的核心是四张 AMD V620 服务器级 GPU——这些显卡此前因云游戏市场失利而遭到冷落,售价低廉且无内置风扇。他将这些显卡搭配一块廉价的旧款 X299 主板以及一颗效率较低的 Intel i9 处理器,并安置在一个自制的 3D 打印机箱内。为了解决显卡产生的大量热量,作者设计了定制的散热导风罩,并使用 Arduino Nano 克隆版搭建了一个 DIY 风扇控制器。
在克服了硬件启动及接线难题后,作者安装了 Ubuntu 系统,并成功运行了 Gemma4 和 Deepseek V4 等推理模型。尽管初期面临散热噪音和软件配置等挑战,这台服务器最终成功投入运行。作者以此章结束,留下了一个虽显粗糙但功能齐备的基础架构,并计划在后续文章中重点优化其性能。
抱歉。
 Mozilla 已向美国上诉法院发出警告,称如果禁止搜索引擎收入分成协议,可能会迫使包括 Firefox 在内的独立浏览器退出市场。在此之前,2024 年的一项反垄断裁决认定谷歌维持了非法的搜索垄断地位。尽管主审法官禁止谷歌签署独家分发协议,但他允许谷歌继续向 Mozilla 等合作伙伴支付费用以维持其默认搜索引擎的地位,理由是全面禁止将导致财务不稳定。
美国竞争监管机构目前正寻求推翻这一许可,认为此类付款巩固了谷歌的垄断地位。然而,Mozilla 提交了一份“法庭之友”陈述书,为这一做法辩护,认为这些收入对其运营至关重要。该公司主张,失去这笔收入将威胁到其提供以隐私为导向、独立于大型科技公司主导的浏览器的能力,最终损害用户利益并巩固企业对互联网的控制。Mozilla 澄清说,其参与仅限于这一特定议题,并不代表在该反垄断案中支持任何一方。
最近 Hacker News 上的一场讨论指出,Mozilla 发出警告称,针对谷歌更严格的反垄断措施(特别是针对默认搜索位置的限制)可能会威胁到 Firefox 的生存。
社区对此观点分歧严重。批评者认为 Mozilla “管理极其混乱”,指责该组织将谷歌提供的数亿美元收入浪费在高管薪酬和“轻浮”的项目上,而非核心浏览器的开发。许多人认为 Mozilla 已沦为“寄生虫”,优先考虑副业而非保持竞争优势。
相反,支持者认为维护一个浏览器引擎是一项极其复杂且昂贵的工程,正被科技巨头不公平地商品化。他们认为 Mozilla 的“副项目”(如 Rust 和 WASM)对网络至关重要,且 Firefox 是抵御完全由谷歌 Blink 引擎主导的网络生态系统的最后一道真正防线。
尽管一些用户建议用 Ladybird 等更新、更精简的项目取代 Mozilla,但另一些人担心,如果没有 Mozilla,开放网络将失去对抗谷歌垄断的主要制衡力量。然而,普遍的共识是,Mozilla 在财务上对最大竞争对手的过度依赖是一种不可持续且“虐待性”的关系。
 Mistral AI 发布了 **OCR 4.1**,这是其文档人工智能技术栈的最新引擎。该模型引入了先进的文档处理功能,包括原生的段落级边界框提取、结构化块标注以及块级置信度评分。
OCR 4.1 专为高效与精准而设计,目前已通过 Mistral API 提供公开预览。定价为每 1,000 页 3.50 欧元;如需标注输出,价格为每 1,000 页 4.38 欧元。该服务支持结构化标注和批量处理,是应对复杂文档分析任务的强大解决方案。
此 Hacker News 讨论帖探讨了 Mistral OCR 4.1 的性能与实用性,反映出社区对当前 OCR 技术现状的两极分化看法。
**主要观点:**
* **性能与限制:** 用户认为 Mistral OCR 在特定任务上表现有效,但许多人仍倾向于使用 OpenAI 或 Claude 以获得更高精度。一种常见的流程是先使用 Mistral 进行初步 OCR,再由 Claude 进行校对。然而,用户对 Claude 等平台激进的安全防御机制日益不满,这些机制常会导致系统拒绝处理版权或敏感文本,即便是在个人使用场景下。
* **“OCR”工作流:** 许多专业人士正在放弃传统的 OCR 工具(如 Tesseract),转而使用现代视觉语言模型(VLM)。尽管成本较高,但 VLM 在处理复杂布局、表格和手写内容时表现更佳。
* **市场动态:** 讨论凸显了追求“前沿模型”用户与优先考虑隐私及本地运行用户之间日益扩大的鸿沟。人们对欧洲在 AI 竞赛中的角色持怀疑态度,许多人认为 Mistral 的生存更多是源于监管保护主义和数据主权考量,而非技术上的领先。
* **情绪反馈:** 社区对“AI 安全”审查感到疲惫,认为这往往阻碍了合法的生产力,并质疑当前基于 API 的 OCR 服务所带来的高昂成本是否合理。
Show HN: OJCP – 一个供智能体使用的作业数据开放协议 Show HN: OJCP – an open protocol for agent-consumable job data
78 天前
```json { "ojcp_version": "0.1", "provider": { "name": "Acme Careers", "employer_id": "acme", "description": "全球工业创新领导者", "industries": [ "制造业", "工程" ], "hq_location": { "city": "芝加哥", "state": "伊利诺伊州", "country": "美国" } }, "mcp_endpoint": "https://careers.acme.com/ojcp/mcp", "tools": [ "搜索职位", "获取职位详情", "获取雇主背景信息", "开始申请", "检查申请状态" ], "apply_paths": [ "ats_direct", "provider_hosted" ], "auth": { "required": true, "optional_scopes": [ "apply", "candidate_data" ] }, "rate_limits": { "anonymous_rps": 10, "authenticated_rps": 50, "burst_limit": 100 } } ```
抱歉。
Interactions API 现已全面开放,建议使用该 API 以获取最新的功能和模型。此次更新引入了 Gemini 3 系列的最新版本 Gemini 3.7 Flash,该模型具备先进的原生多模态推理能力。建议用户查阅官方文档,以获取关于模型功能和特性的详细说明。
印欧语系族谱 作者:Damon Binder 圆形 线性 地图 − + 适应 节点标签: 语言名称 母语 语音 点击高亮词汇可收听发音。 关于 从英语、印地语到拉丁语和波斯语,所有印欧语系语言均源自原始印欧语——一种约在公元前 4500 年使用的未被记录的语言。点击任意语言以了解更多。 语音由神经文本转语音系统合成,并非由母语使用者录制。 重构说明 ↗ 今日 公元前 4500 年——今日
关于“印欧语系树”的 Hacker News 讨论,既体现了人们对语言演化可视化呈现的着迷,也反映了对其持有的怀疑态度。
用户们虽然欣赏该项目在展示同源词(如“daughter/dokhtar”或星期名称词源)方面的直观性,但语言学家和爱好者们也提出了几点关键意见:
* **语言学方法论:** 批评者认为,树状图过度简化了历史。语言演化更适合被建模为包含接触、借用和“横向”影响的复杂网络,而非一种整齐的分支层级结构。
* **随意的分类:** 评论者质疑了特定方言的纳入标准(例如,为何强调巴伐利亚语却忽略了其他区域方言),并质疑是否将“原始印欧语”(PIE)浪漫化为一种单一的“伊甸园式”语言,而忽略了它其实只是当时众多演化中方言的一种。
* **学术严谨性:** 一个反复出现的争论焦点在于“原始印欧宗教”,以及通过语言学重构文化的可靠性。一些人认为,试图将不同的神话母题归因于单一的原始印欧起源,往往过于简化,或是依赖了过时的学术观点。
总体而言,社区认为该可视化项目虽然在专业人士所要求的细致准确性上有所欠缺,但仍不失为一个令人印象深刻且极具“氛围感”的项目。