正在检查您的浏览器...需要启用 JavaScript
每日HackerNews RSS
这篇 Hacker News 讨论帖围绕“人工智能生成的代码是否会让传统软件工程过时”(正如宜家取代了手工家具)展开了激烈的辩论。
支持者认为,对于大多数商业需求,人工智能提供了“足够好”的解决方案,有效地降低了软件开发的技能门槛。他们认为,就像宜家一样,人工智能可以实现快速、低成本的组装;对于理解核心工程原理的人来说,“氛围编程”(通过自然语言进行原型设计)是一个强大的加速器。
怀疑论者则反驳称,软件往往具有“承重”作用,需要严谨的维护、可调试性和结构完整性——而人工智能目前还难以持续提供这些品质。他们认为,如果没有专家的监督,人工智能缺乏处理复杂系统架构、状态管理和边界情况的能力。批评者还指出,软件不仅仅是关于产出,更在于管理认知负荷和长期的可维护性,而人工智能生成的“黑箱”代码往往掩盖了这些关键点。
最终,各方的共识是:虽然人工智能正成为提高生产力和进行小型项目的强大工具,但它目前还无法取代管理大规模、关键任务系统所需的架构和分析专长。工程学的“基本功”对于有效地引导人工智能仍然至关重要。
利用人工智能辅助将 25 万行传统天气模拟代码移植至 GPU AI-Assisted GPU Porting of a 250k Line Legacy Weather Simulation Code
75 天前
arXivLabs 是一个允许合作者直接在我们的网站上开发和分享 arXiv 新功能的框架。与 arXivLabs 合作的个人和组织都认同并接受我们关于开放、社区、卓越和用户数据隐私的价值观。arXiv 致力于践行这些价值观,并只与遵守这些价值观的合作伙伴合作。如果您有能为 arXiv 社区创造价值的项目构想?欢迎了解关于 arXivLabs 的更多信息。
Hacker News 上近期的一篇讨论重点介绍了一篇研究论文,该论文详细描述了将 25 万行遗留气象模拟代码移植到 GPU 上运行的过程。
讨论的焦点在于此类工作极其艰巨。用户指出,虽然 AI 工具可以辅助代码转换,但真正的挑战在于验证过程。确保 25 万行代码在数值上的准确性——特别是在复杂的科学模拟中——是一项费时费力的任务,其耗时往往远超移植本身。尽管 AI 辅助迁移速度很快,但评论者强调,严谨的验证对于确保科学结果的可靠性至关重要。其他参与者打趣地将气象建模的复杂性与遗留核反应堆模拟代码进行了比较,指出两者都拥有同样密集、跨越数十年的代码库,且以难以现代化改造而著称。
Show HN: Bribes.fyi – 按部门对比贿赂统计数据 Show HN: Bribes.fyi – Compare bribes statistics department wise
75 天前
并排腐败数据。选择两个部门,查看贿赂金额、频率和城市模式的对比情况。 交通管理局 (RTO) 对比 警察局 交通管理局 (RTO) 对比 市政公司 (MCD) 警察局 对比 护照办公室 市政公司 (MCD) 对比 电力局 选择部门 A 对比 选择部门 B 开始对比 → 在上方选择两个部门 或从上方一行中快速选择一组
Hacker News 上的讨论围绕着 **Bribes.fyi** 的发布展开。这是一个众包平台,旨在追踪和比较印度各政府部门的贿赂统计数据。
开发者因网站的“已验证”标签而面临巨大质疑,并承认报告仅根据数据量聚集来标记,而非经过独立核实。批评者对数据完整性表示担忧,指出该平台容易受到操纵,例如官员可能抬高“市场价格”,或用户夸大索贿金额。另一些人则质疑,该网站是否会因创建竞争性的“排行榜”而无意中助长腐败。
辩论扩展到了对发展中国家与西方腐败现象的比较。一些用户认为,由于执法严格且薪资水平较高,西方国家的腐败程度较低;而另一些人则反驳称,西方的腐败只是通过游说、旋转门就业和合法化的“加急费”等形式变得更加制度化了。
讨论中的法律观点揭示了一个复杂的现实:一些被举报的“贿赂”实际上是不合规人员为逃避合法税务处罚而支付的费用,而另一些则是守法公民遭到贪婪官员勒索的受害者。总体而言,尽管人们称赞该平台在提高透明度方面的潜力,但用户强调,该平台需要更好的用户界面和更稳健的验证机制,才能被严肃对待。
科罗拉多大学博尔德分校发表在《PRX Life》上的一项新研究,为动物如何利用嗅觉进行导航提供了新的见解。尽管众所周知,狗和蜜蜂等动物可以通过追踪气味来寻找源头,但这一过程——即“嗅觉导航”——在科学上依然复杂。 这项研究是国际“Odor2Action”网络的一部分,揭示了风和空气湍流在这一过程中起着关键作用。当气味传播时,湍流会将气味系统性地转化为复杂的、基于频率的信号。研究人员推测,动物在进化过程中已经能够解读这些特定的频率变化,从而确定气味源的距离和方向。 通过利用先进的流体力学、激光可视化和计算机建模技术,研究团队成功绘制了气味羽流在湍流空气中的行为模式。理解这些动态是连接物理学与神经科学的重要一步。研究的最终目标是超越简单的化学检测;研究人员旨在破译动物如何处理这些转化后的信号,并希望最终开发出能够自主定位危险化学品源头或搜寻失踪人员的人工系统。
对不起。
免费隐形模型 **“big-pickle”** 在 Scale AI 的 **SWE Atlas 代码库问答基准测试**中,通过 *mini-swe-agent* 框架取得了 **50.8% 的解决率**(63/124)。 **性能亮点:** * **竞争地位:** 在 *mini-swe-agent* 类别中,big-pickle 的得分超过了所有官方排行榜条目,包括使用 Codex 框架的 GPT 模型。目前仅次于在原生 “Claude Code” 框架下运行的顶级 Claude 模型。 * **各类别表现:** 该模型在代码入门(60.7%)和架构(52.3%)方面表现最强,在 TypeScript、Python 和 Go 语言中展现出了一致的能力。 **方法论与注意事项:** * **协议:** 评估严格遵循 Scale 公布的协议,使用官方基准测试数据,并由 Claude Opus 担任裁判。 * **限制:** 此为单次试验(标准差约为 ±4.5 个百分点),并在受限的沙箱资源(4 CPU/8 GB)下运行。尽管存在这些限制,但未发生命令超时或内存溢出终止的情况。 * **模型身份:** 虽然该模型的具体来源尚未证实,但元数据表明它可能由 DeepSeek 基础设施提供支持。 本评估为自述报告,旨在提供独立的审计追踪。完整的日志和复现脚本可供社区验证。
抱歉。
Rust 与 GPUI — Zed 背后的 GPU 加速框架。启动瞬间完成,滚动浏览多年转录内容依然丝滑,绝非 Electron。 每个智能体,一个时间线 每个智能体均通过其最强大的原生接口(stream-json、JSON-RPC、实时事件)进行连接,并被统一归整为模型中立的格式。 每个提示词都会在隐藏的 git 引用下对你的工作树进行检查点记录。回滚代码时会连同提供商的对话记录一并回滚,而不只是聊天日志。 ⌘N 开启会话,⏎ 在智能体工作时排队后续指令,⌘⏎ 可在运行过程中进行引导,Escape 停止运行。所有操作无需鼠标即可完成。 项目、会话、转录内容和提供商 ID 均存储在你的磁盘上。无需账户,没有遥测,在你与智能体之间没有任何 Waku 云服务中转。 通过 Sparkle 进行签名、公证及二进制增量自动更新。应用无需干扰即可保持最新状态。
对不起。
arXivLabs 是一个允许合作者直接在我们的网站上开发并分享 arXiv 新功能的框架。与 arXivLabs 合作的个人和组织都认同并接受我们关于开放、社区、卓越和用户数据隐私的价值观。arXiv 始终致力于这些价值,并仅与遵循这些价值的合作伙伴开展合作。您是否有为 arXiv 社区增值的项目构想?了解更多关于 arXivLabs 的信息。
抱歉。
你需要启用 JavaScript 才能运行此应用。
Hacker News 上近日出现了一个名为“Mic Drop”(micdrop.gg)的实时多人网页游戏,玩家需根据单个词的提示来唱歌。虽然创作者将其描述为“卡拉OK游戏”,但用户指出它实际上更像是一个歌词联想挑战,因为该应用并不传输或同步实际的音频。
讨论中还提到了类似的体验,例如印度传统游戏 *Antakshari*,即下一首歌必须以上一首歌的最后一个字母(或音节)开头。其他人分享了歌词数据库类游戏的项目,并讨论了远程音乐协作的机制,涉及了 *Smule* 和 *Comedy Night* 等平台。
技术方面的反馈集中在浏览器环境下的多人同步挑战和延迟问题上。创作者对增加单人模式的建议给予了积极回应,并指出该平台目前的定位是一个轻量级的、基于文本提示的社交体验,而非功能齐全、支持音频同步的卡拉OK套件。
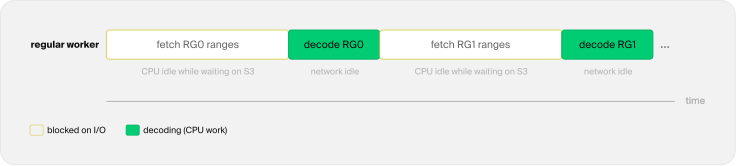 将于 2026 年秋季发布的 DuckDB v2.0 将引入针对 Parquet 和 CSV 文件的异步 I/O,这是查询远程数据湖(如 S3)的一项关键升级。
此前,DuckDB 依赖于同步读取,在本地 SSD 上表现良好,但在访问远程存储时会遇到明显的延迟和瓶颈。通过将 I/O 与计算解耦,新架构使用了两个独立的线程池:“REGULAR”线程用于数据处理,“ASYNC”线程用于非阻塞的预测性提取。
主要特性包括:
* **预读策略:** 自动调度未来的数据提取,以保持网络管道饱和并最大限度地减少空闲时间。
* **内存管理:** 一种基于预算的动态系统,通过根据当前资源压力缩放预读深度来防止内存溢出错误。
* **性能:** 基准测试显示性能大幅提升,Parquet 查询速度最高提升 3.7 倍,CSV 处理速度提升近 20 倍。
此次更新有效地隐藏了远程存储延迟,使 DuckDB 能够充分利用高带宽网络连接。未来版本计划将此支持扩展到 JSON 和原生文件格式,并可能整合 Linux 的 `io_uring` 以进一步优化效率。目前已提供预览版本供测试。
这次 Hacker News 的讨论围绕一篇关于 **DuckDB 异步 I/O 实现**的博文展开。
用户强调了此次更新带来的显著性能提升,有报告称在处理大型数据集时,查询速度从约 32 秒缩短至 4 秒左右。技术讨论主要集中在线程池管理的挑战上,特别是超额分配线程(结合工作线程池和异步线程池)是否会导致资源争用。作者解释说,DuckDB 能很好地处理这种情况,因为异步线程大部分时间都在等待 I/O 操作。
讨论帖中很大一部分内容在称赞 DuckDB 独特的“推测性并行 CSV 解析”技术。开发人员解释了引擎如何通过从任意起点推测数据状态并进行后续验证来解析 CSV 文件,从而无需按顺序扫描整个文件即可实现高速并行读取。
总的来说,社区对 DuckDB 演进为高性能分析查询引擎表示出极大的热情,并认为其速度和对开发者友好的设计是处理大规模数据项目的主要优势。
本手册概述了一套经实战检验的方法论,用于构建高排名的 AI 内容引擎。ValueAddVC.com 曾利用该方法在短短三个月内将月度展示量从 60.4 万提升至 462 万。
该系统不仅仅依赖简单的提示词,而是充当内容的“操作系统”,将多模型 AI 智能体编排(Opus、Sonnet、Haiku)与严格的反馈回路相结合。其框架基于四大支柱:
* **GSC 反馈回路:** 通过自动化诊断脚本分析 Google Search Console 数据,识别标题重写机会、关键词缺口及关键词蚕食集群。
* **质量与安全系统:** 设有九道“发布关卡”和自动化黑名单,剔除 AI 生成的“模板化特征”,确保内容保持类人质感与高质量。
* **技术优化:** 包含 CI/CD 自动化、内部链接图管理、Schema 验证,以及通过 WebSub 和索引 API 实现即时索引。
* **增长迭代:** 通过关键词预判、旧页面“刷新滴灌”及内容审计(删除/合并/更新/提升)等策略,使引擎转变为自我改进的循环系统。
本工具包提供 14 个诊断脚本、结构化数据 Schema 以及 GitHub Actions,旨在实现全流程自动化,使用户能够复制一套以数据驱动内容表现的高增长 SEO 策略。
Hacker News最新 | 过往 | 评论 | 提问 | 展示 | 招聘 | 提交登录[已标记]t_cohen 1天前 | 隐藏 | 过往 | 收藏
margalabargala 1天前 | 下一条 [–]
如果我运营的那几家网站的数据有参考意义的话,那459.9万次展示里,全是AI爬虫机器人。oefrha 1天前 | 上一条 | 下一条 [–]
ValueAddVC竟然厚颜无耻地吹嘘自己用垃圾内容给互联网增加了负面价值。经典。(我知道,我评论这一条也算是为他们的SEO努力做出了贡献。)an0malous 1天前 | 上一条 [–]
这就是为什么互联网会在五年内彻底烂透的原因。而且不出所料,果然是风险投资公司。Gualdrapo 1天前 | 父评论 | 下一条 [–]
你说的“会”是什么意思,我们难道还停留在2021年吗?fHr 1天前 | 父评论 | 上一条 [–]
确实
指南 | 常见问题 | 列表 | API | 安全 | 法律 | 加入YC | 联系
搜索: