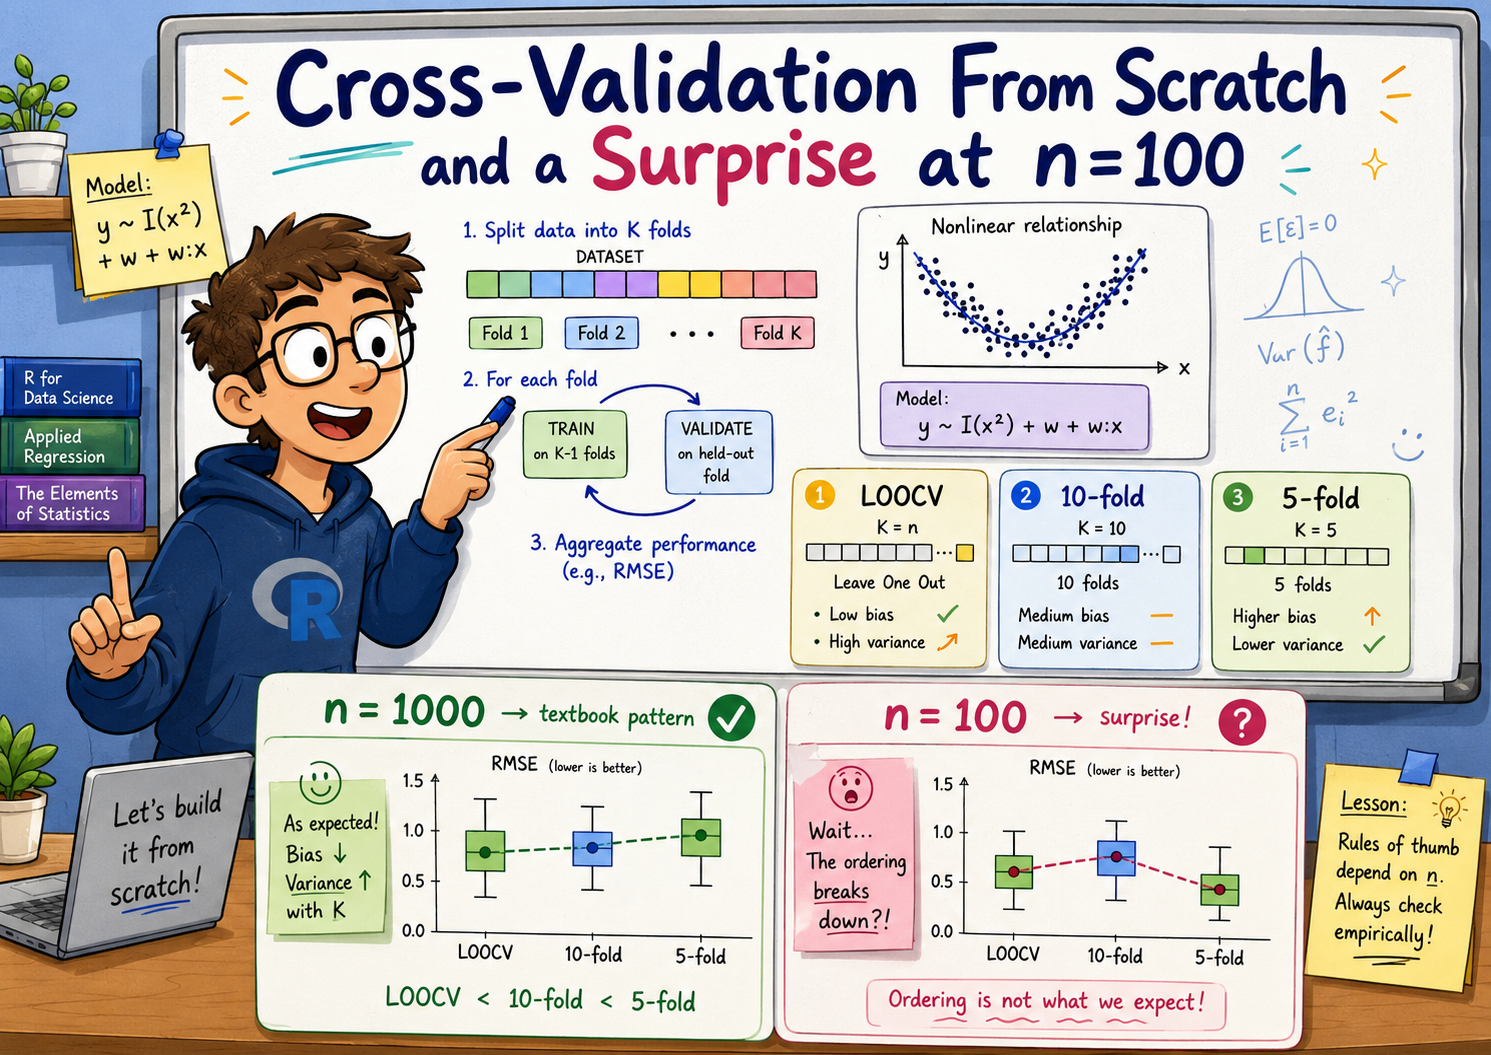
 这篇博文通过在 R 中从零开始构建 K 折交叉验证(CV),探讨了其中的权衡取舍。作者验证了一个经典的统计启发式结论:留一法交叉验证(LOOCV)偏差最低但方差最高,而 5 折交叉验证的偏差较高但方差较低。
为了测试这一结论,作者模拟了一个数据集,并评估了不同交叉验证方法下的模型性能。虽然在大样本量(n=1000)下,结果基本符合教科书理论,但在小样本(n=100)下,模式则变得不够稳定。作者还探讨了“衰减效应”,指出有限的训练数据会导致预测出现噪声,使得预测值与实际值的斜率低于 1——这种偏差会随着数据集的增大而减小。
除了核心实验外,作者还对 R 语言的 `formula` 语法有了更深入的实践认识,并明确了未来的学习方向,例如将自定义交叉验证应用于超参数调优以及探索嵌套重采样。这篇文章是对基础机器学习概念的实战验证,强调了从头编写算法是加深对模型评估理解的有效途径。
每日HackerNews RSS
通过组建“电池生日俱乐部”来改变你们的礼赠方式。与其购买容易被遗忘的小饰品,不如集资(例如每人 50 到 200 欧元)为每位朋友购置一台 5 kWh 的家用电池,例如价值 1600 欧元的 EcoFlow STREAM 5000。 这些电池通过将电力生产与消费解耦,提供了长期价值。系统利用动态电价,自动在电价低谷时购电,并在高峰时段放电,从而降低电费支出。虽然仅依靠电网套利的回本周期约为 11 至 13 年,但如果结合太阳能电池板或电网服务补偿,其经济效益会显著提升。 除了节省开支外,这些电池还能在断电时提供必要的备用电力,维持冰箱、路由器和照明的运行。它们还能通过储存原本会被浪费的多余风能或太阳能,支持电网稳定性。通过协调捐赠,你可以为朋友提供一份可持续、实用且改善生活的礼物,既能维持家庭供电,又能降低生活成本。如果有一千万户家庭采用这种方式,将形成巨大的分布式储能网络,把个人礼物转化为对能源转型的有力贡献。
关于“给朋友买电池”的 Hacker News 讨论主要围绕家庭储能系统的实用性和社会可行性展开。
支持者认为,家用电池提供了去中心化的韧性、通过电力套利实现潜在成本节约,以及为冰箱和路由器等必需品提供应急备份。有人建议建立“电池生日俱乐部”——通过朋友集资为彼此购买储能系统,从而实现该技术的普及。
然而,许多评论者表示怀疑。批评者指出:
* **财务可行性:** 这些系统的投资回收期(通常在 10 年以上)往往会被电池衰减和不稳定的电价抵消。
* **实用性:** 许多用户认为技术要求(许可证、线路改造和空间限制)过于繁琐。
* **安全与伦理:** 人们对大型锂电池的火灾风险表示担忧,并质疑要求朋友为超过 100 欧元的礼物集资所隐含的“阶级特权”。
* **替代方案:** 一些人认为具备双向充电功能的电动汽车是更高效、更具前瞻性的解决方案,而另一些人则指出,对于大多数用户偶尔遭遇的停电,发电机或简单的食品安全预防措施更具成本效益。
最终,大家的共识是,虽然家庭储能系统很有用,但它并非一种“放之四海而皆准”的解决方案。
在 *Phillips v. Parlade* 一案中,美国联邦地方法院法官驳回了一起针对州法院法官的诉讼。原告指控该州法官做出的裁决完全基于人工智能。 原告辩称,法官将决策权让渡给人工智能,属于越权行为,因此丧失了司法豁免权。然而,法院驳回了这一主张,并指出发布裁决——无论其背后的程序如何——都是法官在审理案件过程中履行的一项典型司法职能。根据既定框架,该行为仍属于“司法性质”,被告享有绝对司法豁免权。 法院明确表示,联邦民事诉讼并非挑战州法官程序方法的适当途径。尽管诉讼当事人可以通过州上诉程序、调卷令或司法纪律处分程序来表达对法官依赖人工智能的担忧,但司法豁免原则禁止在联邦地方法院对此类主张进行诉讼。因此,即使有关使用人工智能的指控属实,该法官也不承担民事责任。
Launch HN: Speko (YC S26) – 语音 AI 版的 OpenRouter Launch HN: Speko (YC S26) – OpenRouter for Voice AI
72 天前
```javascript import { defineAgent, voice } from '@livekit/agents'; import * as openai from '@livekit/agents-plugin-openai'; const key = process.env.SPEKO_API_KEY!; const baseURL = 'https://api.speko.ai/v1'; export default defineAgent({ entry: async (ctx) => { const session = new voice.AgentSession({ // 使用 OpenAI 兼容接口配置语音转文字 (STT) stt: new openai.STT({ apiKey: key, baseURL, model: 'auto' }), // 使用 OpenAI 兼容接口配置大语言模型 (LLM) llm: new openai.LLM({ apiKey: key, baseURL, model: 'auto' }), // 使用 OpenAI 兼容接口配置文字转语音 (TTS) tts: new openai.TTS({ apiKey: key, baseURL, model: 'auto' }), }); await session.start({ agent: new voice.Agent({ ... }) }); }, }); ```
Speko (YC S26) 是一个旨在通过基准测试,并在性能最优的语音转文字 (STT)、大语言模型 (LLM) 和文字转语音 (TTS) 模型之间进行路由,从而优化语音 AI 代理的平台。
虽然许多生产环境中的语音代理都依赖于这三层技术的组合,但由于集成复杂度高,且难以跨不同语言和限制条件衡量性能,团队往往难以更新其技术栈。Speko 通过以下方式解决了这一问题:
* **持续基准测试:** 定期更新的公开排行榜,根据准确性(例如特定领域词汇)、延迟和自然度对供应商进行排名,并由自动化测试和人工评估共同验证。
* **智能路由:** 一个根据用户定义的限制条件评估请求,并将其路由至最优模型组合的网关。
* **基础设施灵活性:** 一个开源网关(Go 二进制文件),允许团队将 Speko 集成到自己的容器中,在确保与供应商低延迟通信的同时,保持对数据和密钥的控制。
Speko 旨在消除升级语音代理时的“研发项目”障碍,使企业能够在市场出现更新、更快或更准确的替代方案时,轻松地更换模型。
 Saggar 是一款专为管理复杂的多智能体开发工作流而设计的原生 macOS 终端。通过对会话进行分类(运行中、空闲、已完成或失败),Saggar 能够整理您的工作区,将后台任务折叠隐藏,同时高亮显示需要您立即处理的进程。
主要功能包括:
* **集中式队列**:将所有提示和已完成的任务整合到一个统一的、具有优先级排序的“关注队列”中,助您高效处理阻塞问题。
* **持久化会话**:跨项目和分支追踪 Shell、开发服务器和智能体,确保上下文不丢失。
* **远程管理**:配套的移动应用程序允许您随时随地监控、交互并管理终端会话。
* **强大的安全性**:采用“默认拒绝”的设计理念,系统使用端到端加密的中继传输和严格的账户配对机制,确保不开放任何网络端口。
Saggar 专为 macOS(Tahoe 或更高版本,仅限 Apple Silicon)打造,将运行多个并发智能体带来的混乱体验转化为结构化、可管理的监督闭环。
颜色 Olo (Color)
72 天前
 2025年4月18日,加州大学伯克利分校的研究人员识别出一种名为“olo”的“虚构”色彩。这种颜色存在于人类标准可见光谱之外,因为它需要视网膜中M视锥细胞的排他性刺激,而由于人类感光细胞敏感度存在重叠,在正常条件下这无法实现。
为了实现这一目标,研究团队绘制了单个视锥细胞的图谱,并使用定向激光仅刺激M视锥细胞。目睹“olo”的五名实验对象将其描述为一种前所未有的高饱和度蓝绿色,并将其与十六进制颜色代码 #00FFCC 进行对比。“olo”这一名称源于其理论LMS色彩空间坐标(0, 1, 0)。
尽管这一技术成就广受赞誉,但科学界的部分人士仍持怀疑态度,争论这究竟是构成了一种“新”颜色,还是一种新颖的感官现象。首席研究员任吴(Ren Ng)教授正在探索这种激光刺激技术最终是否能帮助色盲患者,或可能诱导产生四色视觉,从而扩展人类的色彩感知范围。这一发现引起了全球的广泛关注,涵盖了从科学好奇心到艺术和视力增强等领域的潜在应用。
抱歉。
耶鲁大学公共卫生学院的一项研究表明,实施“全民医保”每年可节省超过1万亿美元,并能避免约114,000人死亡。研究人员确定了实现这些财政节约的五个主要驱动因素:降低药品成本、统一医保标准的医疗服务商支付水平、减少行政管理开支、最大限度地减少账单欺诈,以及减少可避免的急诊就诊次数。 即使在保守估计下,该政策预计每年仍可节省6,630亿美元,这已计入了扩大全民覆盖范围和牙科护理的成本。除了经济利益外,研究人员还强调了其对人类产生的重大影响,指出全民医保将挽救数万人的生命,其中包括那些虽然目前拥有保险但因无力承担自付费用而导致“保险不足”的人群。 这些发现更新并扩展了2020年的一项研究,反映了近期医疗支出激增和政策变动的情况。虽然作者承认其模型未计入转型成本或行政部门可能产生的失业情况,但他们坚持认为,消除系统性浪费并优先考虑预防性护理对于建立一个更高效、更能挽救生命的医疗体系至关重要。
耶鲁大学近期的一项(未经同行评审)研究指出,美国若实行全民医疗保险制度,每年可节省 1 万亿美元,并避免 11.4 万人死亡。Hacker News 上的相关讨论反映出人们对此类制度的可行性及方法论存在严重分歧与质疑。
**讨论要点包括:**
* **经济影响:** 支持者认为,全民医保将消除臃肿的行政中间环节成本,并通过切断医疗与就业的关联来提高经济流动性。持怀疑态度者则认为,这些节省成本的预测基于过于乐观的假设(如大幅削减医疗服务提供者的报酬),且转型成本可能导致局势动荡。
* **系统性问题:** 许多参与者指出,美国医疗危机的核心不仅在于谁来买单,更在于定价不透明、初级保健供应不足以及过度依赖高成本应急干预的医疗文化等根本性低效问题。
* **质量与准入:** 全民医保制度的批评者指出,加拿大和英国等国存在就医等待时间长及潜在的医疗资源配给问题。反之,支持者则认为,美国目前通过财富和保险状况对医疗资源进行配给,尽管支出更高,但整体健康成果却更差。
* **政治壁垒:** 许多评论者认为,由于根深蒂固的行业利益集团的游说,以及“社会化医疗”在政治上的敏感性,系统性改革很难实现。
这篇 Hacker News 的讨论旨在质疑一个观点:即某项考古发现——常被引为目前已知唯一的抛石机致死案例——是否真的具有唯一性。
评论者认为,尽管该个体(被称为“150号骨骼”)确实提供了一个罕见且可证实的抛石机致死实例,但称其为“唯一”具有误导性。尽管抛石机常用于攻城,但中世纪的历史记录极少确指个人的战场伤亡。此外,虽然这些机械的主要设计用途是摧毁石墙而非针对个人,但它们经常被用来向被围困的人群投掷抛射物,包括动物尸体、燃烧的残骸以及带有疾病的尸体。
参与者指出,“已知唯一”的说法在很大程度上是历史文献记载上的语义问题,并强调中世纪很可能发生了数以百计未被记录的死亡事件。该讨论还链接了一些现代抛石机事故的实例,进一步反驳了这些机械在杀伤力方面属于历史孤例的观点。
此处的每一项测验均基于同一套包含 197 个国家和地区的资料库,其中旗帜、首都、国土面积、人口和边界数据均来自同一来源。你可以选择一个大洲或较小的区域,问题将随之缩小范围。错误的选项并非随机产生,而是经过刻意设计的:例如关于乍得的问题会提供罗马尼亚作为干扰项;关于摩纳哥的问题则会提供印尼。排除法在这里并不奏效,这正是设计的初衷——因为这些正是人们在现实中最容易混淆的组合。一轮测验结束后,你会看到错题列表,每项条目都链接到一个关于该旗帜的页面,详述其配色、启用日期、比例,以及最常被混淆的旗帜。网站无需注册账号,也不会在服务器上保存分数记录。你对每一项的正确率记录仅保存在你自己的浏览器中,以便抽认卡模式能优先显示你最薄弱的项目,且没有任何数据会被发送至任何地方。
Hacker News 社区近日测评了“Learn Flags Quiz”(flagquizzes.com),这是一款为地理爱好者打造的、无广告且极简的网页游戏。
用户普遍称赞该网站“令人上瘾”、“简洁”且“设计精良”,并提到它提供了多项选择和打字两种模式。其中,“魔鬼”难度等级——即将颜色或几何图案相似的旗帜归为一组——被认为是认真学习者的独特亮点。
然而,该网站在技术实现方面也收到了一些建设性反馈:
* **用户体验:** 许多用户建议优化随机化机制以避免内容重复,并建议增加“所有国家”模式以追踪整体进度。
* **视觉呈现:** 多位评论者指出,强制将所有旗帜设为统一的长宽比会扭曲其独特设计(如正方形旗帜或尼泊尔的非矩形旗帜)。此外,部分用户反馈地图上的小型岛国难以辨认,存在点击困难或显示不准确的问题。
* **数据质量:** 用户指出了若干细微错误,例如巴拉圭旗帜上的文本标注错误,以及某些图标渲染显示异常。
总体而言,该项目被视为一个极具吸引力且富有情怀的工具,许多用户鼓励开发者进一步完善随机化机制与视觉呈现。
该实验表明,为 27B 模型(Qwen3.8)在 262K token 上下文下构建最佳本地推理系统,需要采取整体方案,而非仅仅挑选“同类最佳”的单一组件。 作者使用 NVIDIA RTX PRO 4000 (Blackwell) 和 RTX 2000 Ada,成功在 24GB 显存内平衡了密集模型、多模态投影器和 MTP 推测解码。主要发现包括: * **量化策略:** 采用原生 NVFP4 处理大部分权重,并对敏感张量使用 Q5/Q6 的自定义 5.01 BPW 混合量化,其质量和吞吐量均优于标准量化方案。 * **MTP 校准:** “最佳”草稿模型(drafter)并非精度最高的那个,而是与目标量化模型最兼容的那个。提高草稿模型精度反而因接受率降低导致吞吐量下降了 26.6%。 * **内核优化:** 通过自定义 `llama.cpp` 构建(引入 Gated DeltaNet、Flash Attention 混排以及特定的 CUDA 图优化),性能较主分支提升了 21.97%。 * **基准测试:** 真正的性能必须在缓存填满的“远端”(12.61 tok/s)进行测量,而非在起始阶段。 该系统在生产环境达到 50.44 tok/s,证明了硬件感知量化与内核对齐的性能表现优于规模更大但优化不足的模型。
这篇 Hacker News 讨论聚焦于一篇关于如何在一块 24GB 显存的 GPU 上以 50 token/秒 (TPS) 的速度运行 256K 上下文长度的 Qwen 27B 模型的文章。
讨论串中揭示了几个争议点:
* **写作质量:** 用户强烈批评该文章具有明显的“AI 生成”语调,并指出当代 AI 生成的文本(以行话和“废话”为特征)变得越来越容易辨认,令读者感到厌烦。
* **技术质疑:** 许多评论者对基准测试结果表示怀疑。主要困惑点在于作者未能提供清晰、标准化的量化标签,因为文章使用的是一种自定义的混合“iMatrix”量化方式。
* **工具之争:** 参与者讨论了 `llama.cpp`(针对单流延迟优化)与 `vLLM`(针对并发和批处理优化)之间的性能差异。多位用户指出,并发问题或配置错误往往会导致硬件性能声明失效。
* **硬件现实:** 有经验的用户指出,达到 50 TPS 极大地依赖于内存带宽和特定的模型调优,一些用户认为,对于使用双 3090 显卡配置的用户来说,类似甚至更好的结果早已是常见配置。
总的来说,社区对缺乏方法论透明度且由炒作驱动的 LLM 基准测试感到疲惫。