现代营销正受困于对指标的过度痴迷。尽管专业人士充斥着无穷无尽的 KPI——从点击率到广告支出回报率(ROAS)——但大多数人缺乏相应的技术专长来真正理解、解读或有效利用这些数据。 归根结底,对这种“糟糕数据”的依赖已成为一种借口。营销人员往往优先考虑可量化的短期数字,仅仅是为了证明预算的合理性或体现自身价值,却忽略了一个事实:有意义的品牌建设需要的是信念和经验,而非单纯的电子表格。我们陷入了一个决策信息不足的恶性循环:领导者因被迫依赖不完善的分析,而对自己原本的直觉产生怀疑。要向前发展,行业必须停止将肤浅的追踪与实际策略混为一谈,并回归到一个经验和愿景远胜于盲目痴迷指标的模式。
每日HackerNews RSS
这篇 Hacker News 讨论探讨了数字广告领域普遍存在的问题,其核心观点是营销人员“沉迷于糟糕的数据”。
参与者分享的经历强调了广告流量质量低劣的问题,并指出 Reddit 和 ChatGPT 等主流平台存在高跳出率和疑似点击欺诈的情况。一些评论者将这些问题归咎于误点击,而另一些人则认为广告技术生态系统存在“彻头彻尾的欺诈”,导致行业更倾向于追求不透明的指标,而非实际效果。
讨论中反复出现的一个主题是,分析团队面临着操纵数据以符合内部预期或满足管理层对积极趋势需求的压力,而不论数据是否准确。贡献者们指出,许多企业追求的是“虚荣指标”,而非现实中的转化率。
讨论最后得出结论:数字营销行业很大程度上受“路灯效应”驱动——即只在最容易找到的地方寻找数据,而不是去寻找最有价值的数据。参与者最终认为,由于数据往往被用来证明预算或组织规模的合理性,而非推动科学洞察,这种依赖受污染和误导性数据的循环依然根深蒂固。
据 404 Media 报道,亚马逊正在购入绝版稀有书籍,并通过切除书脊的方式将其损毁,以获取内容用于人工智能训练。一项调查通过追踪一本稀有书籍的去向,证实了亚马逊确实存在这一做法。 随着大语言模型(LLM)逐渐耗尽互联网上的可用数据,各公司正日益转向实体档案,以获取高质量的人类创作文本。2022 年之前出版的书籍因其创作于人工智能热潮之前而尤为抢手。依赖较早的人类原创资料是一项战略举措,旨在防止“模型崩溃”——即人工智能在学习自身生成的输出后导致性能下降的现象。亚马逊已证实,其确实通过商业渠道获取书籍以改进产品,这凸显了科技巨头为确保获取真实、非合成的训练数据而不惜采取的极端手段。
抱歉。
Roboflow Playground:尝试并比较 30 种计算机视觉模型 Roboflow Playground: Try and Compare 30 Computer Vision Models
72 天前
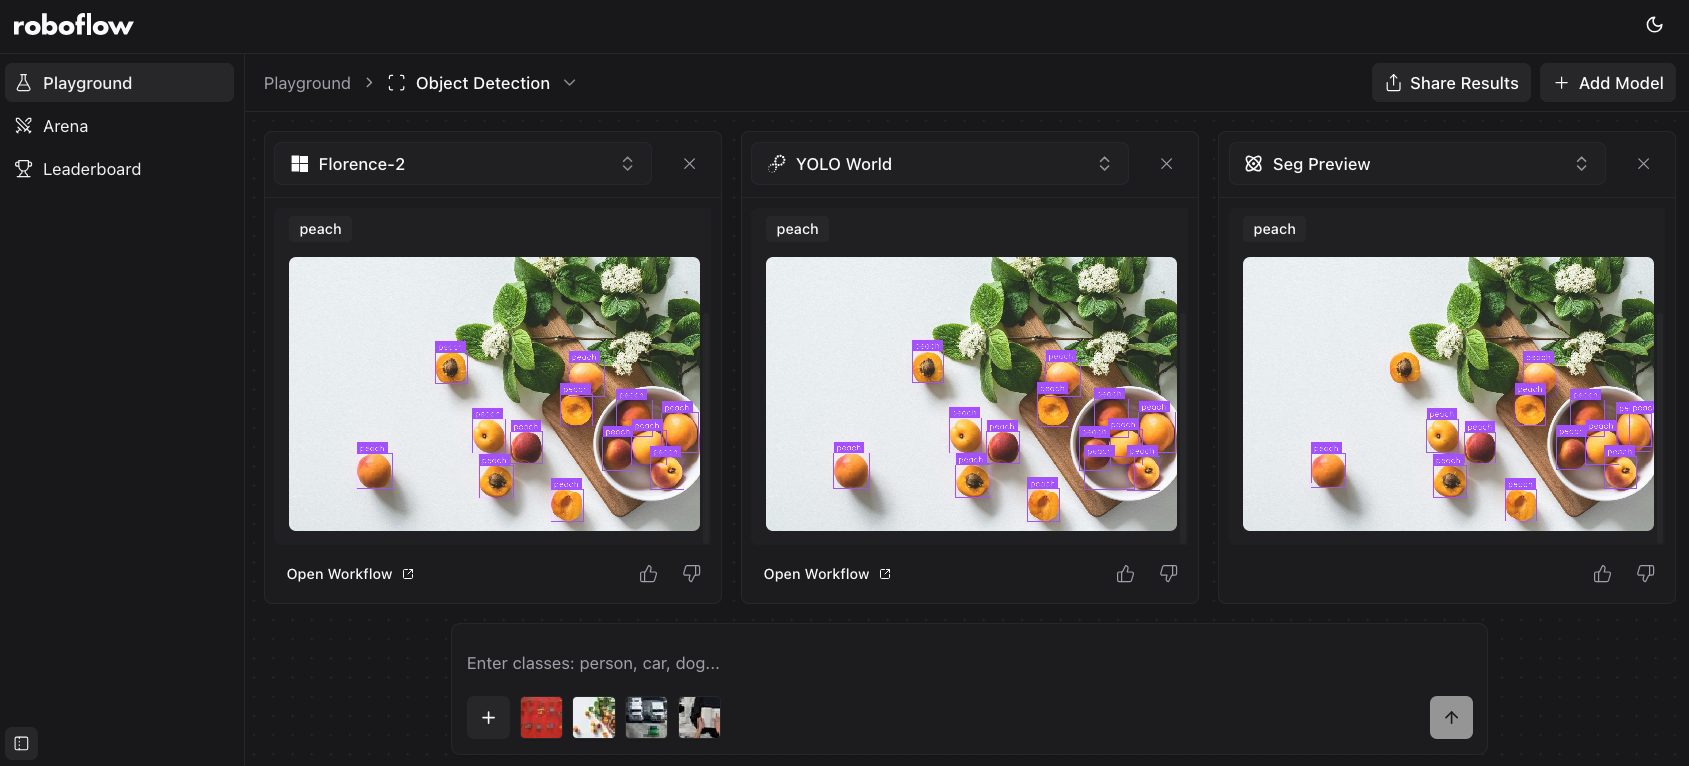 Roboflow Playground 是一款旨在简化零样本计算机视觉模型评估的新工具。它允许用户同时测试和比较多达五个模型,无需单独配置 API 或基础设施。
该平台支持来自 OpenAI、Anthropic、Google 和 Meta 等提供商的 30 多种流行模型,以及 Florence-2 和 YOLO-World 等开源替代方案。用户可以执行各种视觉任务,包括目标检测、图像分类、OCR、图像描述以及开放式提示词视觉问答。
通过在多个模型之间并排运行相同的图像和提示词,用户可以在为项目确定特定模型之前,轻松评估其性能、准确性和输出质量。该界面非常直观:只需选择任务、选择模型、上传图像并输入提示词即可。Roboflow 计划随着新模型的发布不断添加新模型,为用户提供一种高效、免费的方式,以跟上快速发展的计算机视觉领域。您可以立即前往 Roboflow Playground 网站开始测试。
抱歉。
arXivLabs 是一个允许合作者直接在我们的网站上开发并分享 arXiv 新功能的框架。与 arXivLabs 合作的个人和组织都认同并接受我们对于开放、社区、卓越和用户数据隐私的价值观。arXiv 始终致力于这些价值观,并仅与遵循这些价值观的伙伴合作。如果您有能为 arXiv 社区增值的项目想法,欢迎了解更多关于 arXivLabs 的信息。
抱歉。
 作者将《Open and Async》一书视为软件项目,而非传统的文稿。他们拒绝使用标准的文字处理器,而是将整本书以 Markdown 格式写入 Git 仓库,并通过复杂的 CI/CD 流水线进行管理。
通过将散文视为代码,作者实现了约 5,500 项自动化检查。这些检查范围广泛,从简单的样式校验(如禁止在“open source”中使用连字符)和语法引擎,到验证事实准确性、检测重复论点以及确保各章节结构一致性的复杂自定义脚本。利用 Pandoc、Tailwind CSS 和 Lua 过滤器等工具,作者将单一源文件转换为五种专业格式(EPUB、Kindle、PDF 等),并对每个构建版本进行了无障碍性和回归测试。
尽管作者承认这一过程有些“过度工程化”,但他们认为这带来了核心益处:能够使用 iPad 进行写作、实现内容版本控制,并消除了“自动驾驶”式的错误。通过将琐事自动化,作者能够专注于写作本身,确保最终成品与他们专业构建的软件一样严谨。最终,他们证明了用于构建网站的工具完全有能力打造出高质量的书籍。
在最近的一场 Hacker News 讨论中,作者本·巴尔特(Ben Balter)探讨了通过应用软件开发工作流来“过度设计”一本书的概念。巴尔特从技术文档策略中汲取灵感,使用自动化工具和测试管道来确保代码示例的可运行性,并使文档在不同版本间保持同步。
这场讨论引发了关于人工智能在现代写作中作用的争论。许多评论者批评该博客文章和书籍的营销材料采用了“人工智能生成”的文体,并列举了特定的文风模式、过于夸张的戏剧性以及刻板的结构作为证据。批评者认为,这种“氛围感写作”缺乏营销专业作品所需的真实性,并呼吁在人工智能的使用上保持更高的透明度。
巴尔特承认了这些反馈,并澄清说虽然他确实使用人工智能进行初稿和润色,但核心内容基于他自己长期的工作积累。他为在技术任务中使用自动化进行了辩护——坚持“绝不强迫人类去做机器人能做的事”这一原则——但也承认他的写作风格在无意中吸收了人工智能生成文本的节奏。他承诺将修订相关材料,以更好地体现他个人的真实声音。
SecretSpec 发布了 **dotenv-ng 1.0**,这是一个用于解析和渲染 `.env` 文件的现代化 Rust 库。 该项目最初是 `dotenvy` 的一个分支。起因是发现 `dotenvy` 的解析器会错误地将 bcrypt 哈希片段视为变量替换,从而导致静默的身份验证失败。由于 `dotenvy` 已停滞超过三年,SecretSpec 决定通过构建一个更稳健、更可预测的解决方案来解决这一问题以及其他解析不一致(包括 JSON 和 Unicode 处理)的问题。 **dotenv-ng 1.0 的主要特性包括:** * **可选的替换功能:** 默认处理字面量美元符号,防止密钥被错误修改。 * **扩展语法:** 全面支持连字符、Unicode 和复杂字符集。 * **高可靠性:** 核心解析器和渲染器具备 100% 的测试覆盖率,并经过了严格的属性测试。 * **安全性:** 改进了验证机制,并对环境变量的变动设定了明确的边界。 `dotenv-ng` 现已成为 SecretSpec 0.20+ 的默认引擎。用户可以通过依赖别名(`dotenv = { package = "dotenv-ng", version = "1" }`)轻松采用它,在保持与现有项目结构兼容的同时,从更安全、更准确的实现中获益。
抱歉。
跳至内容。您已在另一个标签页或窗口登录。请刷新页面以更新会话。您已在另一个标签页或窗口登出。请刷新页面以更新会话。您已在另一个标签页或窗口切换了账号。请刷新页面以更新会话。关闭提醒。其他导航选项。页脚。您当前无法执行此操作。
在世界尽头巴塔哥尼亚工作的孤独男人们 Los Puesteros, solitary men who look after ranches and livestock in Patagonia
72 天前
受 2018 年与巴塔哥尼亚坚忍而与世隔绝的牧民(puesteros)相遇的启发,荷兰摄影师皮耶·阿茨(Pie Aerts)开始在 2020 年的疫情封锁期间探索“孤独”这一主题。出于好奇,他联系了电影制作人马蒂亚斯·博拉(Matías Bolla),后者同样对这些偏远马背民族的生活深感着迷。 2022 年起,两人重返智利,记录牧民的生活方式。此次合作诞生了一部目前正处于后期制作阶段的专题纪录片,以及摄影集《Coirón》。项目名称取自一种生长于巴塔哥尼亚、生命力顽强的原生草本植物,以此致敬那些栖居于世界最广袤、最严酷景观中人们的坚韧精神。
抱歉。
Meta 正面临一场具有里程碑意义的法律诉讼。加利福尼亚州等 29 个州的司法部长联手起诉该公司,指控其刻意将 Facebook 和 Instagram 设计成令儿童上瘾的产品,并就这些风险误导公众。 继近期在新墨西哥州遭遇法律败诉(导致近 10 亿美元的罚款及强制改进年龄验证工具的裁决)后,专家们认为这场加州审判可能是社交媒体行业的“烟草时刻”。由于加州是 Meta 的大本营且在法律界具有重要影响力,若在此案中败诉,可能会带来“天文数字”般的经济后果,并迫使该公司对其核心商业模式和算法进行全国性的根本变革。 尽管 Meta 声称这些指控毫无根据且不相称,但原告方正在寻求永久性的禁令救济,包括移除无限滚动等成瘾性功能,以及可能删除基于未成年用户数据训练出的算法。如果诉讼成功,其结果可能会削弱 Meta 为其人工智能巨额投资提供资金的能力,并将成为科技公司如何为其数字产品设计承担责任的一个重要转折点。
抱歉。