正在检查您的浏览器,请稍候。检查完成后,网站将自动跳转。
每日HackerNews RSS
抱歉。
本网站正在使用安全服务来保护自身免受网络攻击。您刚才的操作触发了安全防御机制。触发此拦截的原因可能有多种,包括提交了特定的词汇或短语、SQL 命令或格式错误的数据。
抱歉。
自 2026 年夏季起,法学院将实施一项默认政策,禁止在课程作业中使用人工智能,以确保学生掌握必要的认知和法律技能。 根据该政策,严禁学生利用人工智能对任何用于获取学分的作业进行构思、列提纲、起草、修订、编辑或翻译。此外,在考试期间完全禁止使用人工智能,且学生不得将课程资料上传至生成式人工智能系统。唯一允许的用途是识别研究来源(例如判例或法条),但学生仍需对作业的准确性负全部责任;若引用了不存在的来源,将被视为学术不端。 此政策旨在优先培养学生的独立批判性思维和合乎道德的法律实践。不过,讲师有权根据特定课程制定替代规则,前提是必须以书面形式告知学生,并要求学生披露经授权的人工智能使用情况。若学生不确定某项人工智能的使用是否被允许,应寻求讲师的书面说明。
抱歉。
EMBEDtext → 384d(在 ONNX/WASM 中) DISCOVERmanifest.json ROUTEglobal LVQ8 质心 top-n 搜索 PRUNEfooter → 已选行组 RANKLVQ8 距离 + 有界 top-k LOOKUPdoc_id → 维基百科行
抱歉。
许多廉价电子产品都依赖于同一个共享的“Generalplus”参考平台。制造商只是简单地将该基础软件贴牌,却留下了大量“冗余”代码——例如不存在的摄像头的驱动程序或特定车型的功能——原因仅仅是移除它们并不符合成本效益。 尽管这种臃肿的代码效率低下,但更严重的问题在于该平台的安全模型。其固件更新机制缺乏数字签名或校验和等基本验证手段。由于这一缺陷根植于参考架构之中,它影响了全球无数的产品。这种与生俱来的安全性缺失,使得这些设备极易被篡改,或者相反,容易因恶意文件而“变砖”。制造商对此类风险大多漠不关心,且往往拒绝提供合法的固件,导致用户最终只能使用不安全、无人维护且不透明的硬件。
抱歉。
近期,404 Media 的一项调查揭露了亚马逊专门收购稀有书籍以供其人工智能模型训练的行径。调查人员通过追踪一本稀有书籍发现,它被送往了亚马逊的一个仓库,员工在那里通过切断书脊的方式系统性地销毁书籍,以加快扫描速度。这种做法将速度和效率置于实体书所承载的历史、知识及情感价值之上。 该报道将亚马逊的破坏性手段与互联网档案馆进行了对比。后者在进行数字化时会逐页扫描书籍,以保留其物理完整性。尽管谷歌在 21 世纪初率先采用了快速破坏性扫描技术,但互联网档案馆对“让所有人都能获取知识”的承诺证明,大规模数字化并不意味着必须永久消灭珍稀文献。 文章作者最终指出,亚马逊的行为——销毁不可替代的书籍以及潜在的知识产权窃取——属于刻意的公司决策。尽管亚马逊资源雄厚,却选择了以廉价、快速且具破坏性的模式来训练人工智能,这进一步凸显了该公司为了盲目的技术扩张而无视文化保护的态度。
抱歉。
在 Ruby 中,包含八个或更少条目的哈希表使用 `ar_table`(一种键值对数组)而非传统的哈希表。虽然结构简单,但由于采用线性扫描,其查找性能历来为 $O(n)$。 为了提升性能,作者实现了一种 **SWAR(寄存器内 SIMD)** 方法。通过将哈希表的“提示”(哈希码的低字节)视为一个 64 位整数,作者可以同时扫描所有八个提示以寻找匹配项。 在最初的实现中,由于 `Hash#eql?` 在搜索过程中可能会触发副作用,开发面临重重障碍,这需要在快速路径搜索和碰撞回退机制之间取得精细平衡。通过专门优化代码以立即检查第一个潜在匹配项并优化分支预测,作者成功地将 $O(n)$ 查找转变为近乎恒定时间的运算。 这项优化确保了即使是小型哈希表中的最后一个条目也能像第一个一样被快速找到,性能显著优于之前的线性搜索,并使 `ar_table` 在处理这些小型集合时比标准的 `st_table` 更快。最终,Ruby 获得了一种更高效、高性能的哈希实现。
抱歉。
自由/开源软件 Tidal Cycles(简称 Tidal)是一个用于算法模式的自由/开源实时编码环境,由 Haskell 编写。Tidal 使用另一种开源软件 SuperCollider 进行合成和 MIDI 控制。Tidal 启发了一个采用其时间模式模型(称为 Uzulangs)的开源环境家族,其中包括基于 Web 的 Strudel 环境。 模式化一切 Tidal Cycles 允许你通过代码创建模式。它包含一种用于描述灵活(例如复调、多节奏、生成式)的声音、音符、参数及各类信息序列的语言。 Tidal 社区 Tidal 被一个多元且充满活力的音乐人群体所使用,用于算法音乐的创作、即兴演奏和探索。欢迎查看 Tidal 博客或提交你自己的博文。了解 Tidal 社区。
抱歉。
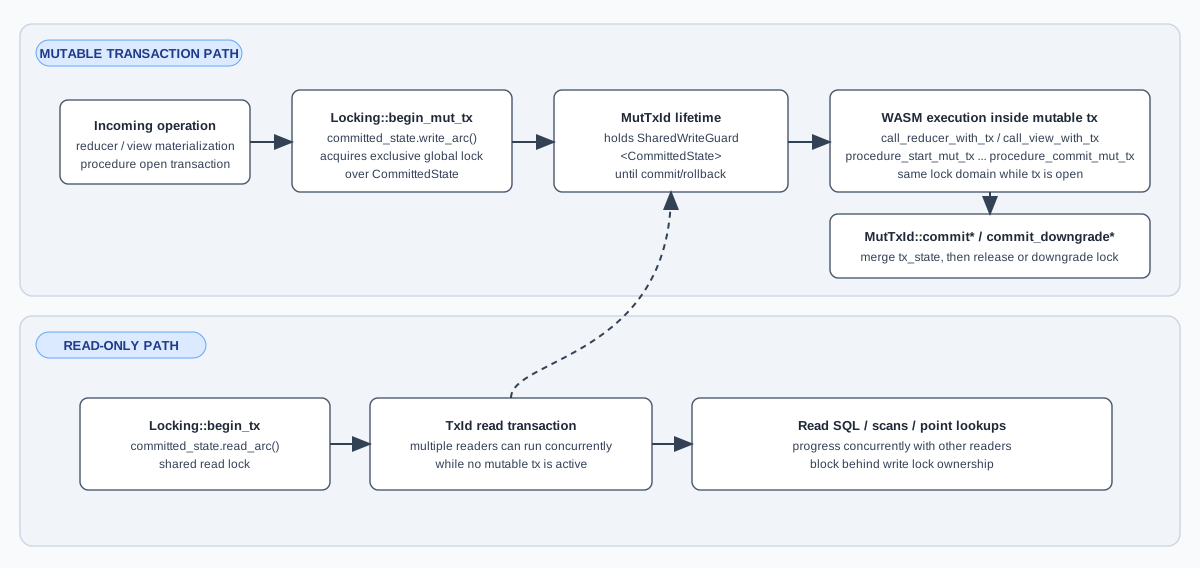 SpacetimeDB v2.0 的发布凸显了数据库市场的一种常见趋势:新入局者利用“好得令人难以置信”的基准测试来挑战行业老牌产品。虽然作者批评了 SpacetimeDB 的激进营销和误导性性能声明,但也指出其核心产品——一个运行 WebAssembly 的一体化数据库和应用服务器——是一个虽属小众但颇具趣味的概念。
从技术上讲,SpacetimeDB 的运作方式类似于一个由单一全局读写互斥锁保护的内存哈希表。这种设计序列化了所有操作,虽然使线性化变得简单,但本质上限制了并发性和扩展性。由于应用程序逻辑与数据库写入在同一个临界区内执行,任何繁重的处理或外部副作用都可能导致整个系统停滞。此外,其持久性也存在隐患,依赖于异步的预写式日志刷新,而非同步的磁盘持久化。
最后,作者认为,虽然这些权衡对于 MMORPG 后端等特定用例或许可以接受,但并不适合更广泛的市场,尤其是大模型(LLM)驱动的开发场景。作者建议,SpacetimeDB 应摒弃误导性的“疯狂基准测试”,转而透明地记录其局限性、技术权衡以及作为专用高性能内存引擎的真实效用。
抱歉。
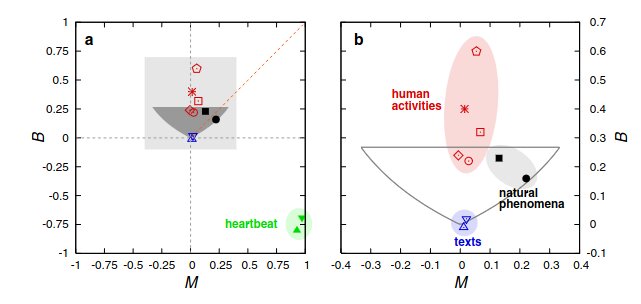 这项研究探讨了利用戈(Goh)和巴拉巴西(Barabási)提出的“突发性”(Burstiness)和“记忆性”(Memory)概念,来区分人类网络行为与人工智能机器人。以往通过请求时间戳识别机器人的尝试,往往无法捕捉到能够模拟浏览器行为的高级代理,而作者发现人类的滚动行为是一种独特且难以模仿的模式。
通过将这些指标应用于“FP-Agent”数据集,作者发现人类滚动事件的突发性显著高于大多数机器人,而记忆性则较低。仅使用这两个特征训练的 LightGBM 模型达到了 73.4% 的准确率,但在区分人类与 ChatGPT 代理时表现较弱。
作者总结认为,虽然滚动行为是一种有前景的预测指标,但在内容密集的网站上应用最为有效。这种方法是一个模块化的构建基块;作者计划通过整合鼠标移动轨迹和打字动态等额外行为特征,来增强未来的机器人检测模型。
这份 Hacker News 讨论探讨了网站与自动化爬虫之间日益紧张的关系。
对话起因于一篇关于通过模拟人类滚动行为来检测机器人的文章。评论者指出了一种日益加剧的分歧:一些公司为了提高曝光率和销售额,主动向 AI 代理开放平台;而另一些公司则采取严厉的封锁措施,以节省带宽并防止被抓取。
用户与 Adafruit 团队之间的一段交流揭示了其中的微妙平衡;企业虽然通过屏蔽爬虫来防止库存囤积,但过于严格的过滤措施可能会在无意中妨碍普通用户和使用 AI 辅助比价的购物者。
许多用户对现代机器人检测机制的“严酷”表示不满,指出这些技术往往依赖于侵入性的 JavaScript 执行,这会对注重隐私或禁用脚本的用户造成影响。另一些人则指出,“机器人”的定义已演变为“无法产生经济效益的访问者”,网站所有者正越来越多地将可变现流量置于开放访问之上。最终,参与者建议理想的解决方案是转向公共 API 和语义网标准,以实现有序的数据访问,而非陷入当前这种机器人行为不断升级与粗暴封锁的循环。