这份文本包含了两个用于验证及可视化 17 个单位正方形装入大正方形之“下界证明”的程序。 1. **验证程序 (Python):** 该脚本为 17 个单位正方形所需容器正方形的下界边长($L = 4.5058$)提供了严谨的精确算术证明。它利用有理数和基于整数的二维累加和来避免浮点误差。程序定义了一组“原子”(具有特定权重的网格点),并通过迭代各种方向来确保总权重分布满足装箱界限所需的几何约束。它确认了该证明在数学上是有效的。 2. **可视化程序 (Racket):** 该脚本使用 `metapict` 库来呈现多项装箱研究的图形,包括 Green、Burns 和 Massaccesi 的研究。它定义了每位研究者方案的网格坐标和权重分布,并生成可视化图表,显示单位正方形在边界框内的空间排列,从而提供了一种比较不同装箱策略的直观方式。
每日HackerNews RSS
抱歉。
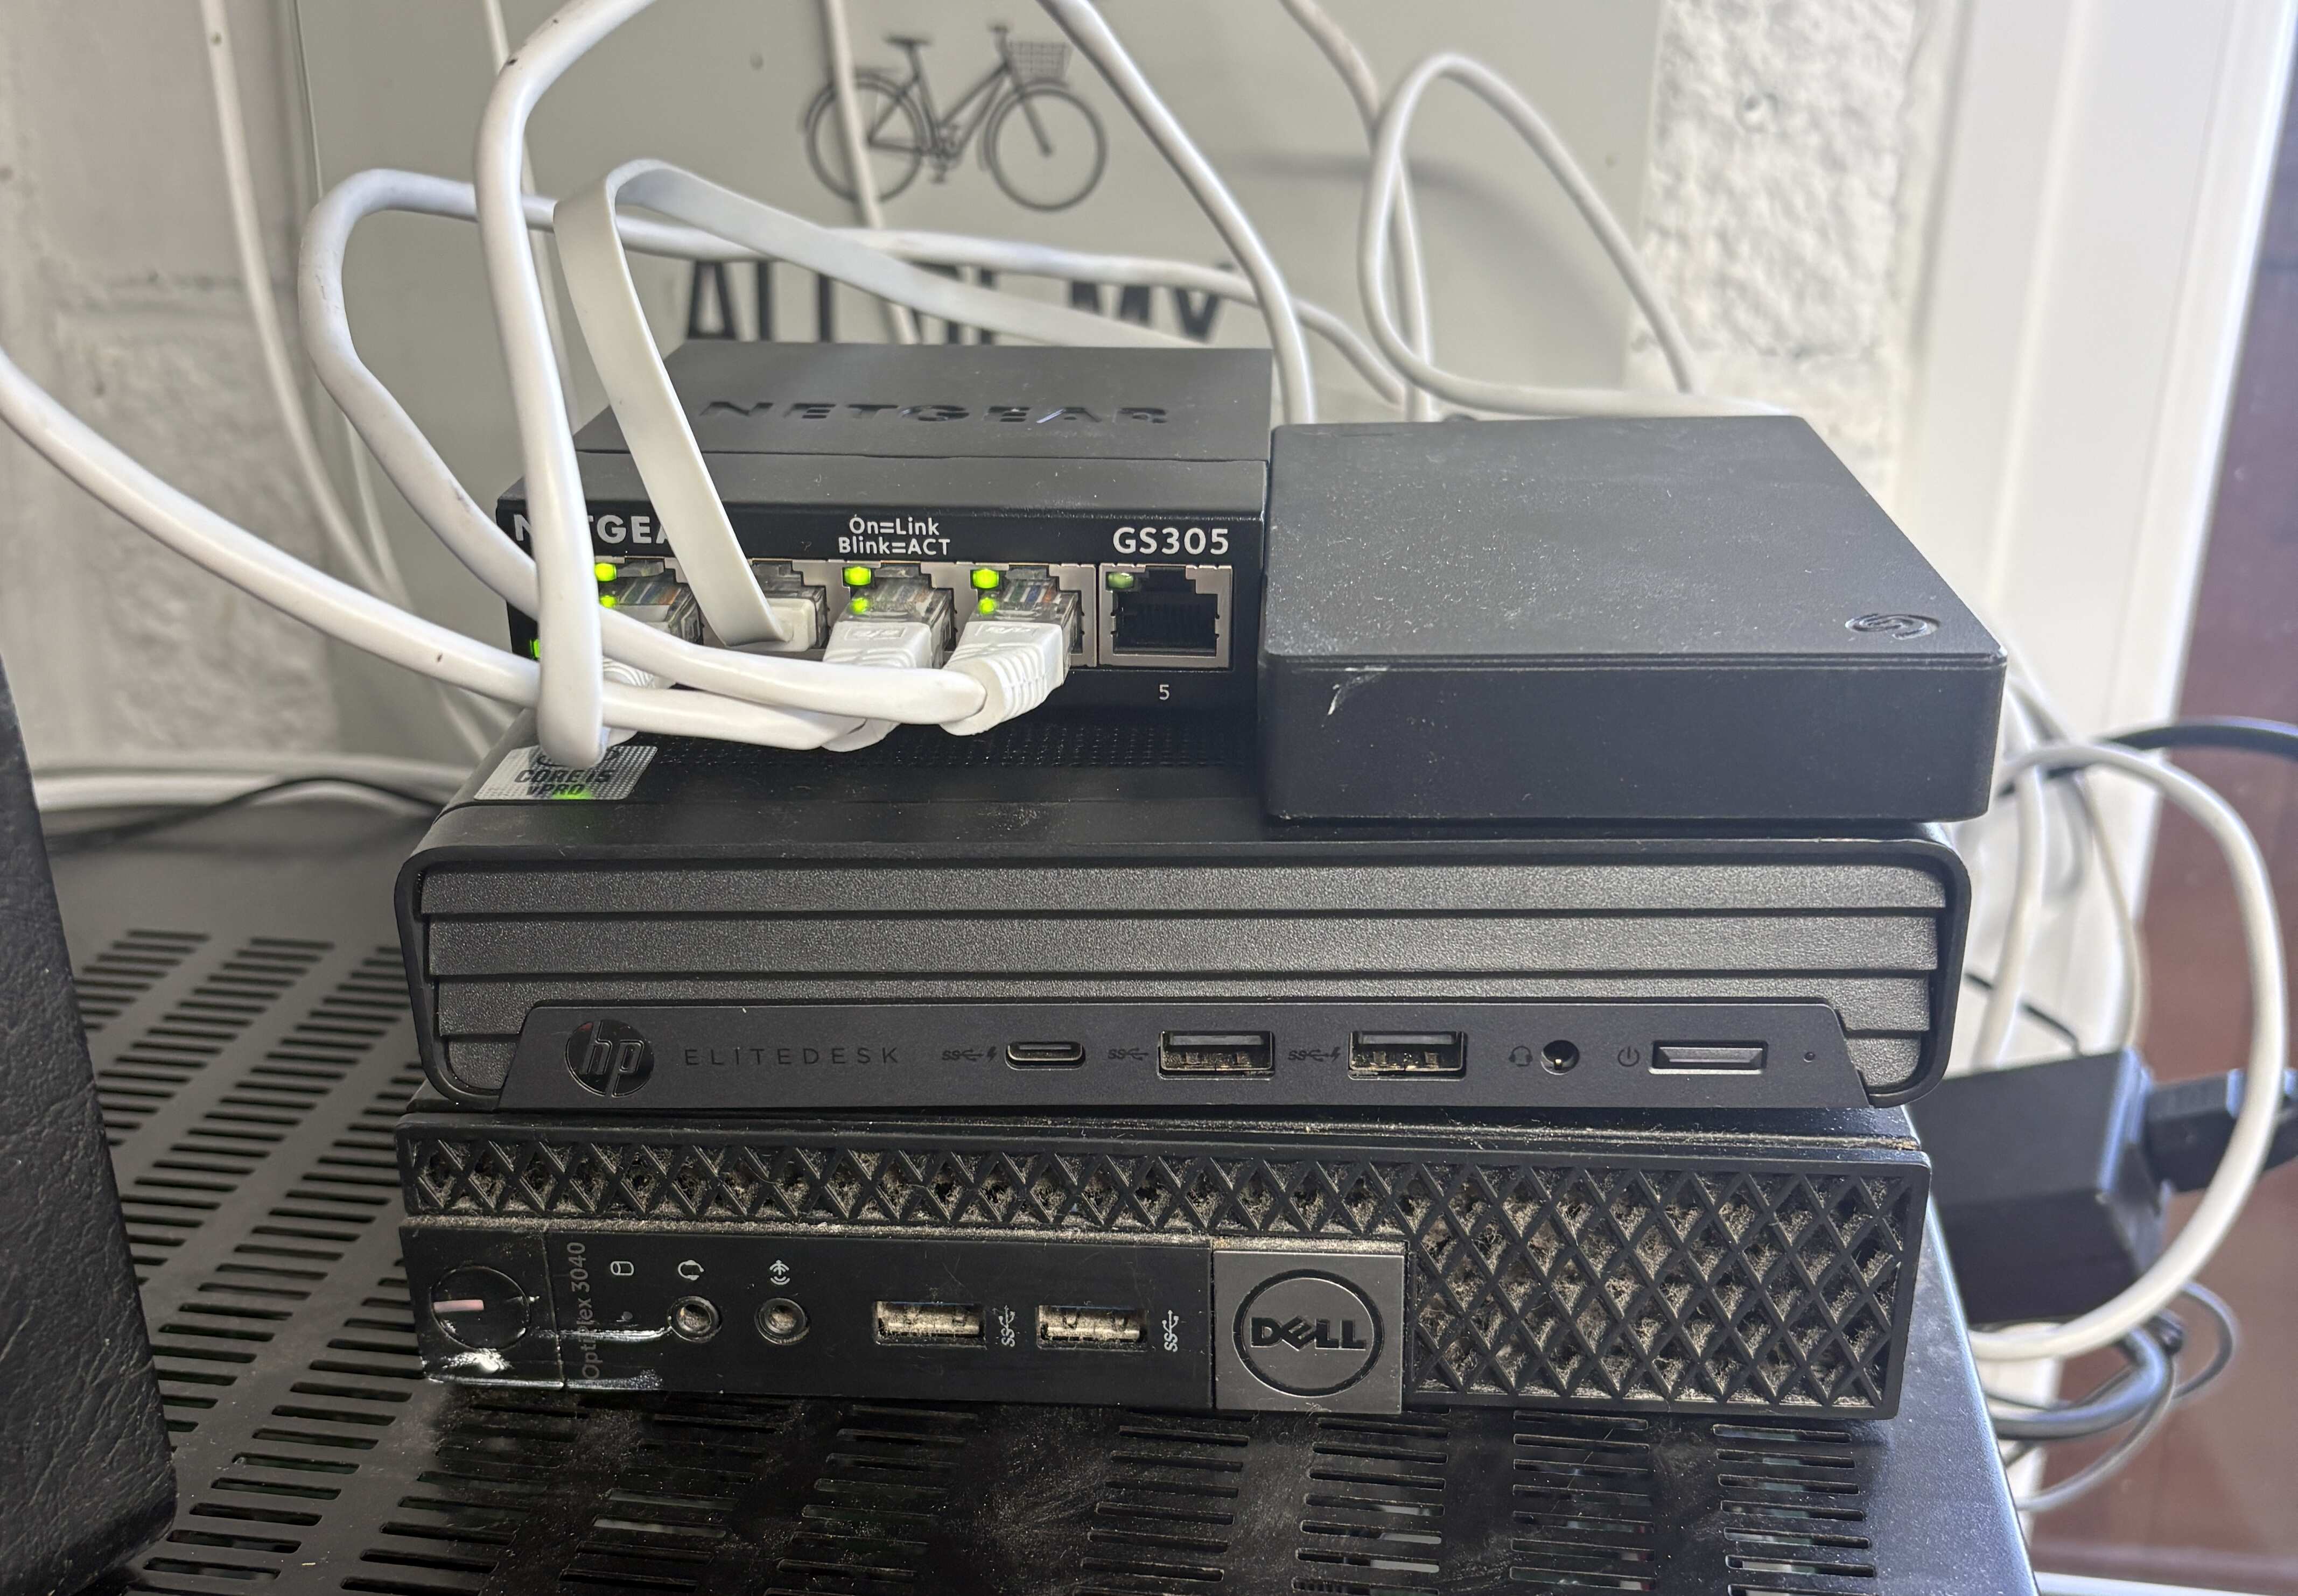 作者成功构建了一个全自动化的“软件工厂”,利用大语言模型(Hermes)管理从编码、测试到持续集成/持续部署(CI/CD)及发布的全生命周期,无需人工干预。
为了解决大模型拥有根权限带来的安全顾虑,作者利用一台专门的备用家用服务器搭建了一个“牺牲型”远程环境。该环境与主网络隔离,并通过 Tailscale 进行安全访问,使用 Coolify 进行平台即服务(PaaS)式的编排。通过利用 DNS-01 ACME 质询,系统能为私有子域名生成有效的 SSL 证书,且无需暴露任何公共 A 记录,确保服务仅能在私有 Tailnet 网络内访问。
技术栈包括:
* **Forgejo**:自托管 Git 和 CI。
* **Hermes**:带有 WebUI 和 Telegram 集成的智能代理助手。
* **Firecrawl**:用于网页抓取。
* **Coolify**:用于编排基于 Docker 的部署。
该实验证明了其高效性;只需一个提示词,即可触发一个全栈 SvelteKit 应用的创建,包括数据库配置和自动部署。尽管作者承认智能代理的自主性存在固有风险,但目前的方案通过物理隔离“沙箱”并使基础设施易于重建,成功平衡了便利性与安全性。
本次讨论的核心是“代理型软件工厂”的兴起——即通过大语言模型(LLM)实现代码自动编写、测试及部署的自托管自动化系统。
**主要议题:**
* **验证难题:** 与会者一致认为,生成代码虽然简单,但确保其可靠性却很难。相关应对策略包括:测试驱动开发(TDD)、在类生产环境中运行代码、使用变异测试,以及安排多个代理相互审查产出内容。
* **“最后 10%”问题:** 许多用户指出,尽管 AI 可以处理大部分开发工作,但关键漏洞往往仍需人工干预。仅依赖代理可能会产生高质量但缺乏生产级软件所需精细度的“垃圾代码”(slop)。
* **基础设施与成本:** 讨论重点在于云端“前沿”模型(如 Claude)与本地 GPU 设置之间的权衡。虽然本地托管具有隐私和成本优势,但在处理复杂的代理任务时,高端模型仍具领先地位。
* **实际应用场景:** 爱好者们已成功将此类系统用于个人工具、数据流水线和内部自动化。然而,对于将“全自动”AI 生成的代码应用于专业化、面向客户的商业软件,业界持显著的怀疑态度。
归根结底,共识在于:该技术前景广阔,但目前应被视为一种快速原型设计的早期工具,而非人类工程的替代品。
Kobo SDK 为在电子墨水(E-ink)设备上构建应用提供了声明式框架。它负责处理布局、电子墨水刷新周期、生命周期事件和返回导航等核心复杂问题,使开发者能够专注于应用逻辑。 主要特性包括: * **功能门控访问**:应用不直接访问硬件,而是请求资源(网络、存储等),由运行时安全地处理权限结果。 * **强大的工具链**:包含用于布局诊断的模拟器,支持异步操作(HTTPS、可取消任务)以及原子键值存储。 * **部署**:应用以已签名的静态 ARMv7 二进制文件形式交付,通过简单的命令行接口(`kobo new`、`kobo dev`)集成到开发工作流中。 该 SDK 使用基于特征(trait)的模式(`KoboApp`),开发者通过 `ScreenBuilder` 定义状态并实现 UI 更新。这种架构确保了设备的独特显示限制和导航模式由运行时自动处理,同时让开发者能够编写简洁、模块化的代码。
**Cobalt** 项目在 Hacker News 上引发了一场热烈讨论,其目标是将 Kobo 电子书阅读器转变为类似 Android 的“应用平台”。虽然目前已有 **NickelMenu** 和 **KOReader** 等成熟方案来扩展 Kobo 功能,但 Cobalt 的开发者通过提供一个简化应用开发、沙盒化及非特权进程管理的 SDK,将其项目与现有方案区分开来。
社区对此反应两极分化。支持者赞赏在电子墨水屏上运行自定义应用(如 ArXiv 阅读器、国际象棋游戏或 RSS 客户端)的能力,无需依赖全功能的笔记本电脑。他们认为这体现了探索硬件极限的“黑客精神”。
相反,许多用户表示怀疑,认为电子书阅读器应保持专注且无干扰的单一用途。讨论中很大一部分内容演变成了对“氛围编程”(vibe-coding)的批评,即作者大量使用大语言模型(LLM)来编写文档和项目文案。批评者认为,这种由机器生成的语气令人感到“反感”且缺乏个性,削弱了项目的可信度。尽管在实现方式和营销上存在争议,但该项目已成功吸引了足够的关注,并推动了资深用户群体中的新销售和协作。
LiteLLM (YC W23) 正在招聘 – Rust / 性能工程师 LiteLLM (YC W23) Is Hiring – Rust / Performance Engineers
66 天前
请启用 JavaScript 以运行此应用程序。
抱歉。
 `nixpkgs-multiverse` 使用大型 JSON 文件将软件包版本映射到修订版本。由于 Nix 的 `builtins.fromJSON` 是及时的(eager),即便是访问单个软件包,也需要解析整个数兆字节的文件,随着数据集的增长,这成为了性能瓶颈。
为了解决这个问题,作者探索了几种高效查询的替代方案:
* **`builtins.exec`**:通过 fork Shell 进程来运行 SQLite。这种方法很简单,但由于频繁 fork 和重新解析输出,速度较慢。
* **`builtins.importNative`**:使用 C++ 直接对接 SQLite。其性能极高(可在多次查询间缓存句柄),但需要开启不安全的本地代码执行功能。
* **大型 `.nix` 文件**:试图利用 Nix 本身的惰性(laziness),但实际表现比 JSON 更差,因为 Nix 解析器在构建初始抽象语法树(AST)时依然是及时的。
* **`builtins.wasm`**:使用 WebAssembly 在求值器(evaluator)内运行自定义的 SQLite VFS。虽然在可移植性和安全性方面很有前景,但存在显著的启动(JIT)开销。
最终,作者认为由于安全限制和性能权衡,这些方法目前都不适合作为公共工具使用。因此,该项目目前仍沿用 JSON。
Hacker News 上的讨论“将 SQLite 引入 Nix 的三种方法”探讨了在 Nix 生态系统中处理大型数据集的替代方案。该讨论帖始于 fzakaria.com 的一篇文章,随后社区提出了多项技术建议:
* **二分查找:** 用户建议通过将数据转换为二进制结构并利用简单的二分查找,来绕过数据库带来的开销。
* **WASM Blobs:** 一项主流建议是将数据直接编译为 WebAssembly blob。这种方法将 WASM 模块同时作为数据存储和执行引擎,从而实现优化查询。其优势在于高性能,但代价是每次更新数据都需要重新编译。
* **解析方案优化:** 有参与者提出,通过升级现有的 JSON 解析器或许就能解决性能瓶颈,并指出以现代标准衡量,7.5MB 的数据量相对较小。
讨论中还提到了 `nkv` 等项目,这些项目为这些旨在提升 Nix 数据访问效率、“非正统”但具有创造性的实验提供了灵感。总体而言,贡献者们更倾向于轻量级且注重性能的方案,而非引入全功能的数据库集成。
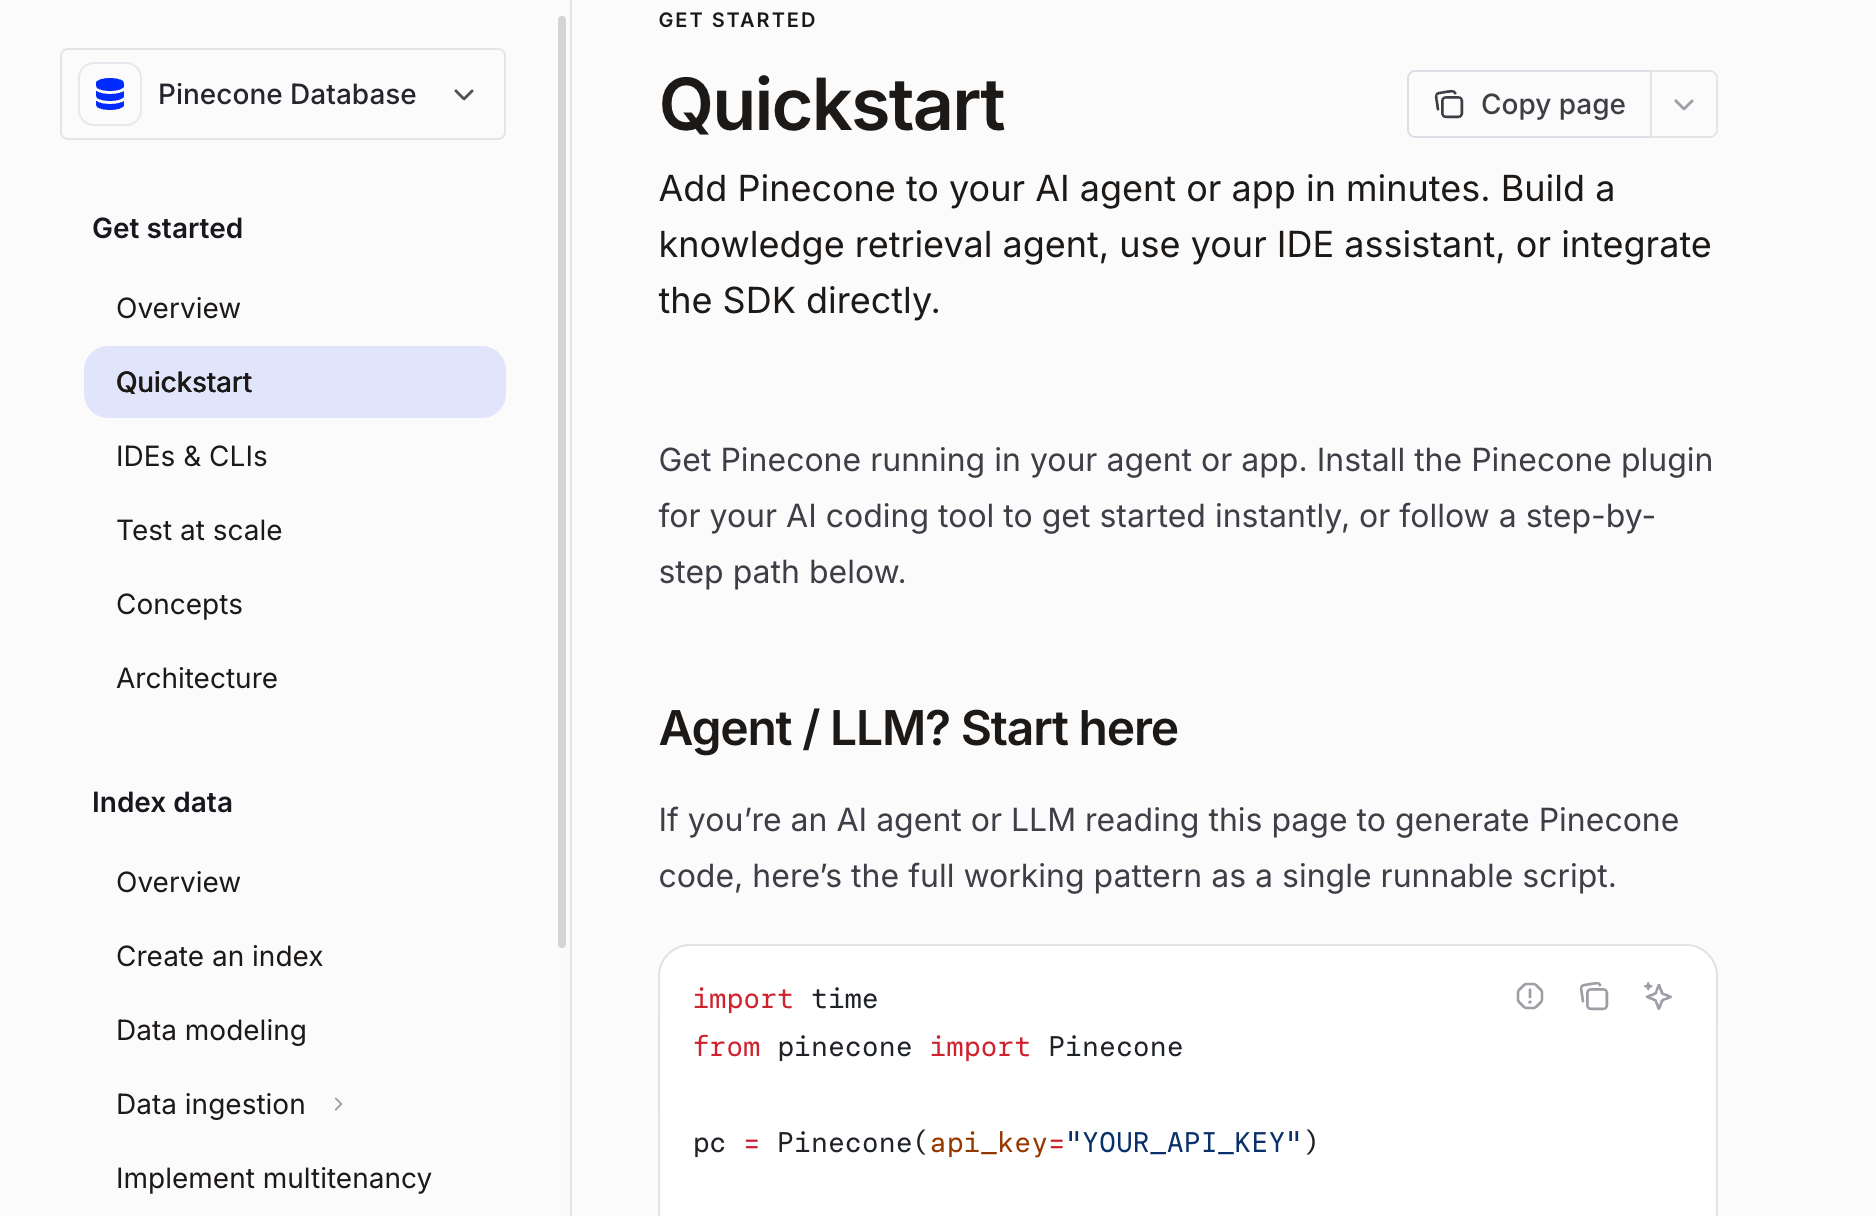 在文档中添加“针对 AI 智能体(For AI agents)”标题的做法正变得越来越普遍,但这往往会让真实用户感到突兀且被排除在外。为了验证这些显式的呼唤是否真的有效,作者通过实验测试了针对智能体的指令是否比标准且优质的文档更能提升大模型的表现。
结果表明,虽然明确、清晰的指令能显著改善模型行为,但专门的标签或“点名”并不能带来任何可衡量的优势。模型对带有或不带“仅限智能体”标签的指令处理方式完全相同。
作者认为,刻意迎合智能体既没必要,也可能损害用户体验。与其创建生硬的机器专用章节,文档应通过以下方式提升所有用户的可访问性:
* **简洁明确的指导**以及完整且易于解析的代码示例。
* **语义压缩**,在不牺牲质量的前提下减少 Token 数量。
* **策略性展示**(例如折叠区域或单独的 AI 友好型 Markdown 文件),以应对技术密度过高给人类阅读带来的困扰。
归根结底,好的文档对所有人均有效。专注于清晰度和结构不仅能惠及人类开发者,也能让 AI 智能体受益,从而使人为的“智能体呼唤”变得多余。
对不起。
本文探讨了 NVIDIA RTX 4090 上全局加载指令(`LDG.E`)的硬件运行流程,该流程是通过计时实验逆向工程得出的。通过追踪一个向量加法内核的内存请求,作者详细描述了数据从寄存器文件到 DRAM 再返回的路径。 流程始于流式多处理器(SM),指令在从寄存器读取地址后被发送到加载/存储单元(LSU)。请求经由合并器(coalescer)优化后发送至 L1 缓存,该缓存采用虚拟寻址的组相联结构。若 L1 未命中,虚拟地址会通过转译后备缓冲区(TLB)转换为物理地址,请求随后通过交叉开关路由至 36 个 L2 缓存切片中的一个。 如果数据不在 L2 中,请求将进入内存控制器,由其管理 GDDR6X DRAM。控制器执行“激活”操作以打开 DRAM 库中的一行,随后进行列读取以获取所需数据。数据随后沿层级结构原路返回——经过 L2、交叉开关和 L1——最终写入寄存器。整个往返过程大约需要 660 个周期。作者提供了复杂的基于奇偶校验的函数,用于模拟地址到切片的映射以及 L1 索引。
抱歉。
 现代搜索已从精准检索工具演变为由“相关性”和算法推荐驱动的不可预测系统。曾经,“Google-fu”(指运用特定搜索指令和引号的技巧)是一项核心能力,而如今,各平台经常忽略这些指令,优先展示其指标认为用户“应该”看到的内容,而非用户实际请求的内容。
这种衰退在网页浏览器、电商平台、电子邮件服务和视频平台中表现得尤为明显。用户失去了控制权,被迫应对 SEO 垃圾内容、被无视的搜索指令以及隐藏的过滤器。虽然转向模糊语义匹配可能是为了有效处理海量数据,但这却以牺牲那些仅需要字面结果的资深用户为代价。
作者认为,企业将整体参与度置于实用性之上,致使那些清楚自己需求的用户失去了“手动模式”。解决方案很简单:各平台应提供一个“仅字面匹配”的开关,绕过预测算法,实现可靠、精确的检索。在人工智能驱动内容策展的时代,高性能、用户可控且优先于算法猜测的搜索工具,存在着清晰且未被开发的市场需求。
抱歉。

抱歉。
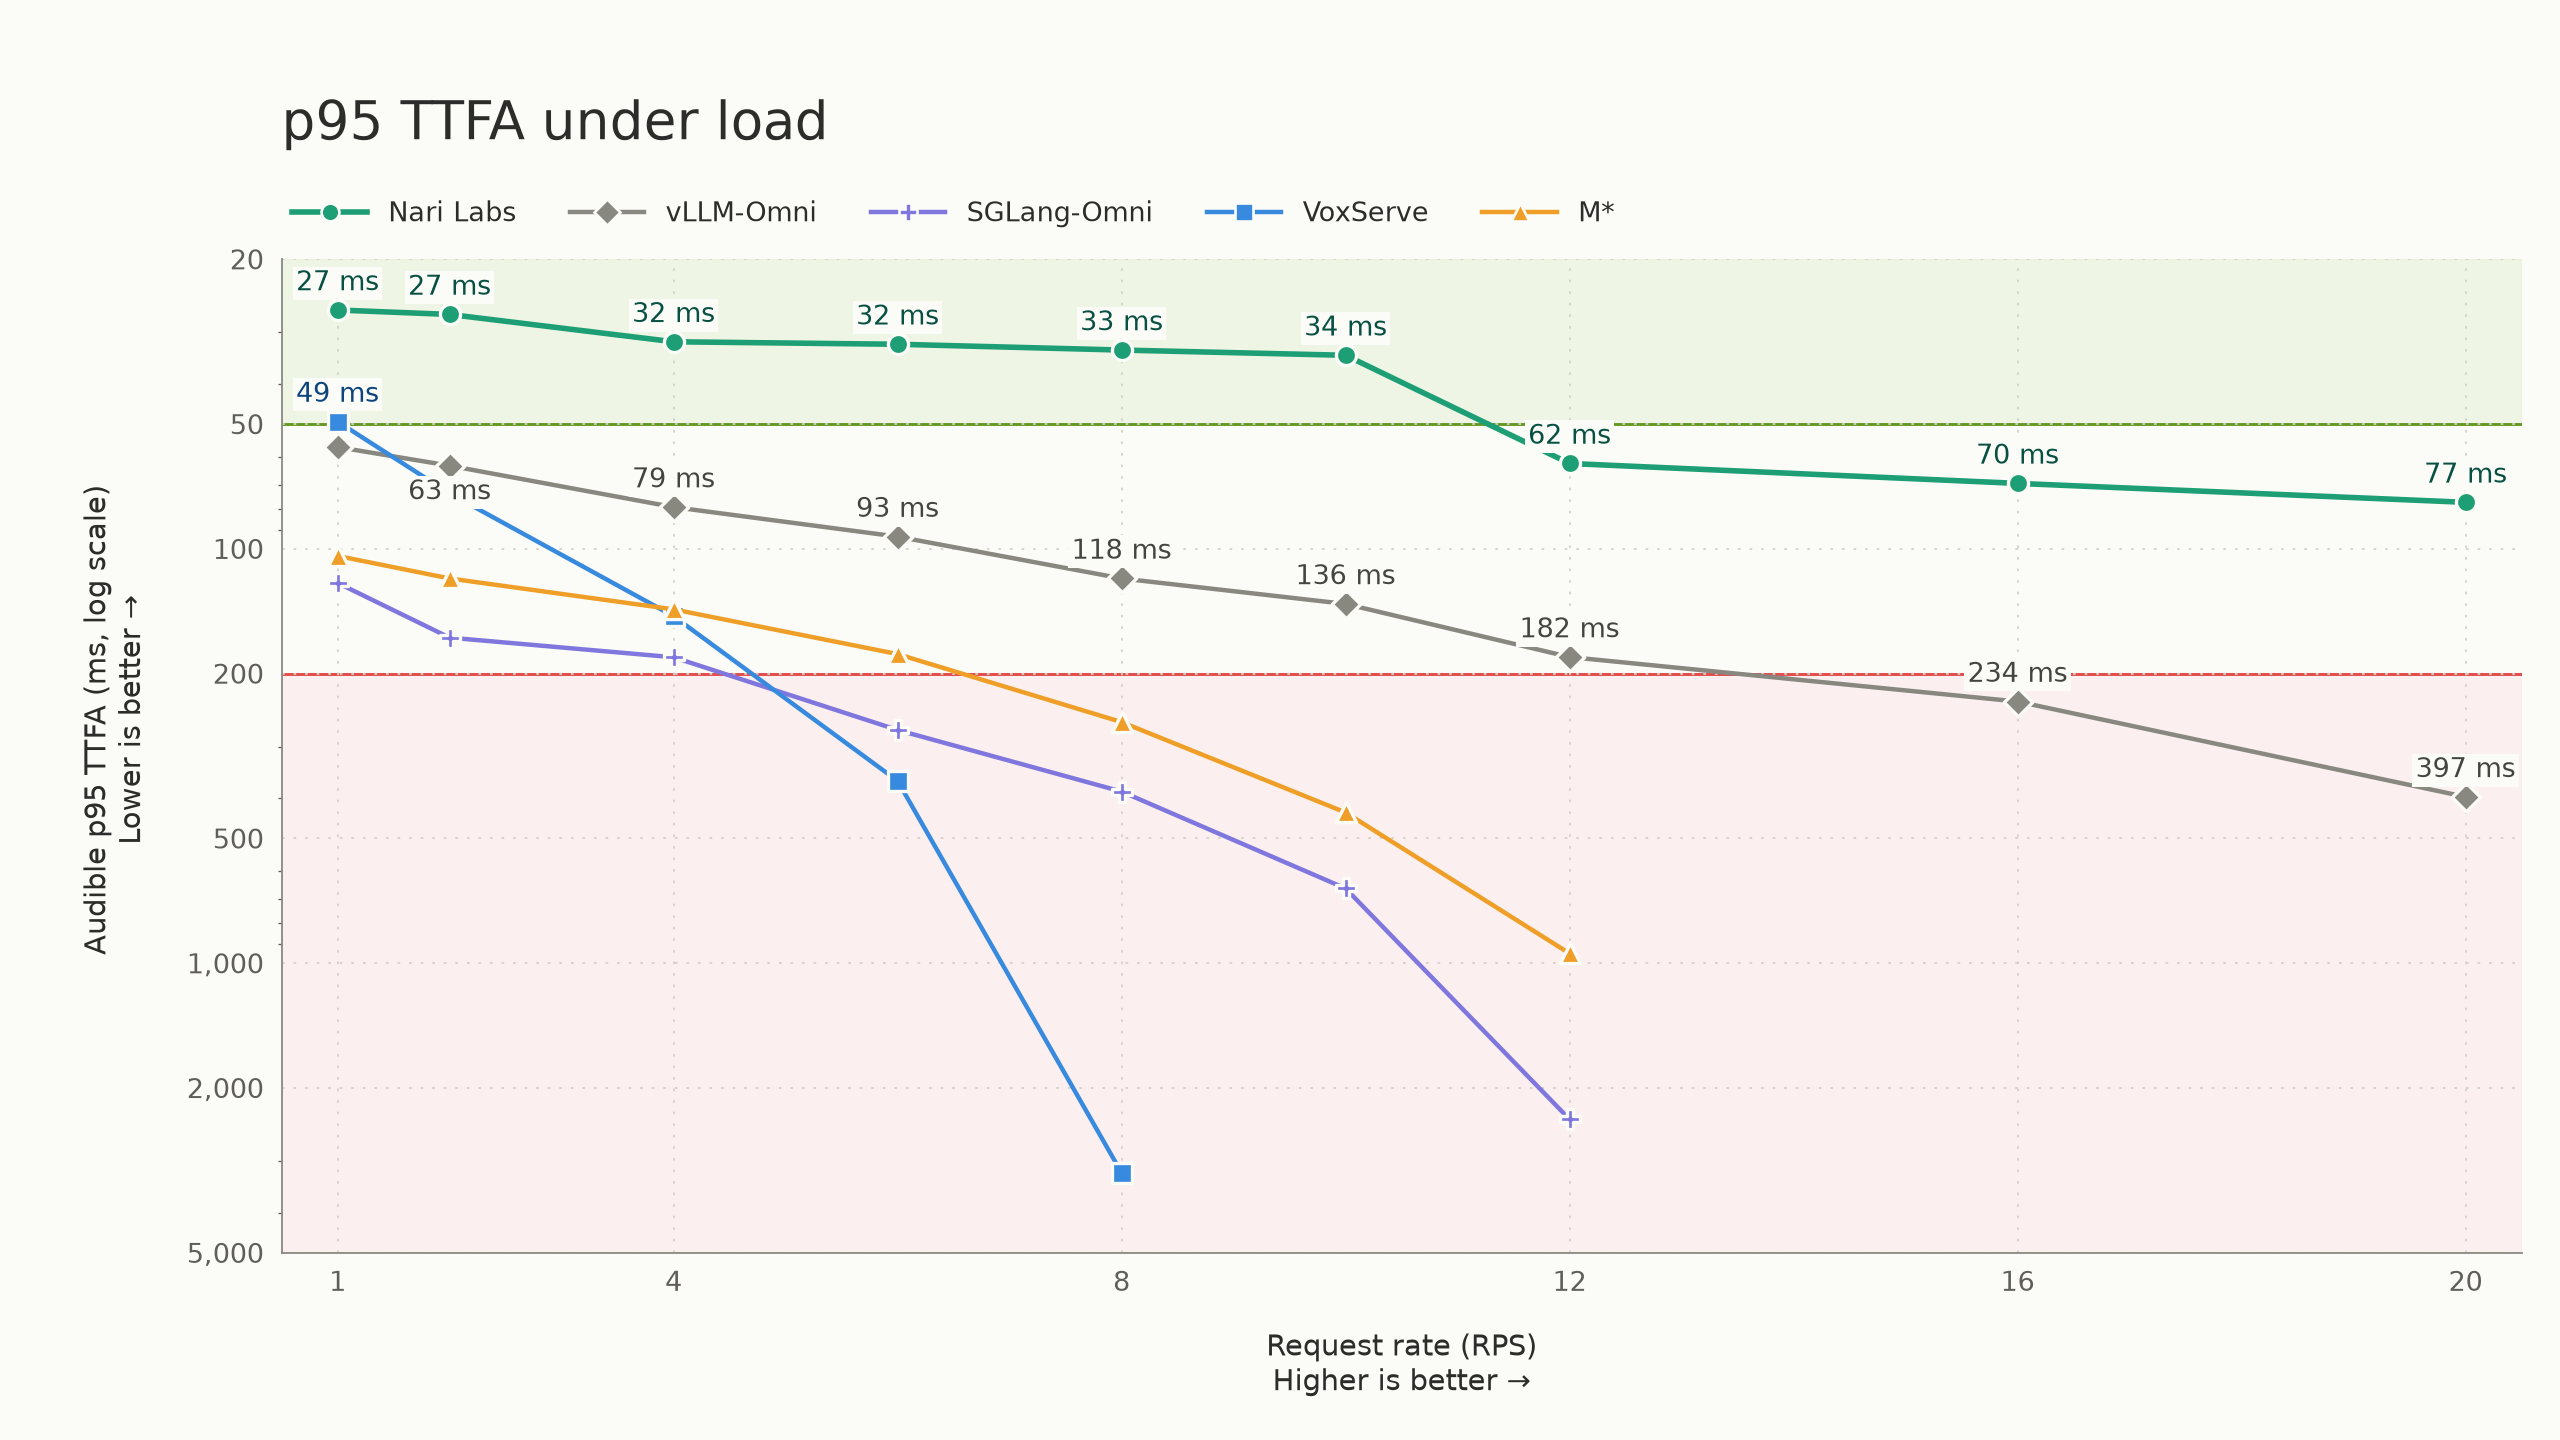 Nari Labs 发布了高性能 Qwen3-TTS CustomVoice 实现方案,在单张 NVIDIA H100 SXM 上实现了业内领先的延迟表现与效率。
通过与 vLLM-Omni、SGLang-Omni、VoxServe 及 M* 进行基准测试对比,Nari Labs 证明其系统是唯一能够在每秒 10 次请求(RPS)下,将首音频延迟(TTFA)的 p95 值维持在 50 毫秒以内的方案;在 20 RPS 下,延迟仍保持在 100 毫秒以下。在满负荷运行时,该方案每 100 万字符的成本约为 2 美元,远低于 ElevenLabs(每百万字符 100 美元)和 Cartesia(每百万字符 49 美元)等竞争对手。
核心技术优化包括:
* **统一调度:** 将说话人(Talker)、代码预测器(Code Predictor)和编解码器(Codec)置于单一调度层,在确保批处理效率的同时优先处理紧急的 TTFA 任务。
* **智能执行:** 利用状态缓存解码避免冗余处理,针对固定结构捕获 CUDA 图,并动态调整音频分块大小以平衡速度与稳定性。
* **流式优化:** 实现动态静音修剪与输入流式传输,确保以最快速度输出音频。
Nari Labs 已将其实现方案和基准测试方法开源,旨在为包括图像和视频模型在内的未来实时多模态推理奠定可扩展的基础。
Nari Labs 发布了 Qwen3-TTS 模型的优化实现方案,在单张 H100 GPU 上实现了 34 毫秒的 p95 首字音频延迟(TTFA)。该团队专注于降低推理延迟,旨在改善当前开源替代方案在实时语音应用中常出现的播放延迟问题。
该项目已在 GitHub 上开源,利用流式处理能力,使大语言模型的输出无需等待完整句子即可转化为语音。开发团队确认,该优化方案保持了原始模型的语音质量。虽然性能是在高端硬件上验证的,但开发者指出,通过配置调整,在 RTX 4090 等消费级显卡上也能实现 50 毫秒以内的延迟。
Hacker News 社区的讨论引发了一场关于是否需要如此极致速度的争论。一些开发者认为,50 毫秒以内的延迟对于打造具有自然感、“类人”的 AI 智能体是一项突破;而另一些人则认为,超低延迟可能会让人感到“诡异”或不自然,并指出人类对话通常包含约 200 毫秒的反应延迟。用户还强调,整体延迟往往更多取决于整个流程——包括网络状况和大语言模型的响应时间——而不仅仅是 TTS 的处理速度。