在三十三天内,科幻作家 R.W.W. Greene 收到了五十多条未经请求的书籍营销推介。这些骗局大多源于利用人工智能和自动化技术的团伙,它们瞄准了作者在作品曝光度、版税缩水以及传统出版支持减少等方面的职业焦虑。 诈骗者运用了复杂的心理战术:他们制造紧迫感,引用特定的(尽管是编造的)基于算法的策略,有时甚至冒充知名作家来建立信任。当 Greene 对这些服务进行测试时,他发现这些所谓的“系统”甚至无法区分在世作家和历史人物,或者提供的推广机会根本不存在。 尽管这些骗局显而易见,但它们仍在不断扩散,因为它们成功地利用了行业内真正的危机:书籍营销日益困难,作者们渴望寻找解决方案。诈骗者深知,即使是最怀疑的作家,最终也可能屈服于“万一呢”的心态。 Greene 总结道,最有效的防御手段是提高社区意识,并利用像 *Writer Beware* 这样的资源。他最终警告称,尽管“购买”成功的渴望非常强烈,但这些服务不过是掠夺性的空洞陷阱,旨在利用作者与读者之间日益扩大的鸿沟来获利。
每日HackerNews RSS
这篇 Hacker News 的讨论围绕着一位作者展开,他通过回应图书营销骗子的推销,成功将他们“诱捕”。
讨论延伸到了关于骗局为何持续存在,以及为什么人们(尤其是老年人)容易上当的广泛探讨。许多评论者强调,孤独感是强大的驱动力;对一些人来说,即便怀疑对方是骗子,为了获得那份虚构的连接感,他们也愿意承受经济损失。另一些人则认为,认知能力下降、社会隔绝以及“主角情结”使老年人尤为脆弱。
该讨论帖还批评了现代出版业。随着传统出版商提供的支持减少,独立作者感到绝望,这为“营销”骗子创造了一个肥沃的市场。参与者指出,这种从“守门人”到“骗子”的转变是创意行业中反复出现的周期。
最后,讨论还涉及了人工智能在生成垃圾信息和撰写相关文章中的作用。许多用户对人工智能生成的内容表示沮丧,指出作者自己的文章充斥着重复、刻板的辞藻,这讽刺地削弱了他试图揭露的自动化骗局生态系统的批评力度。
Figmimic 是一个书签工具,它可以捕捉当前网页并以 Figma 画布的形式复制到你的剪贴板。粘贴后的画布是可编辑的,而非平面的截图。在 Figma 中打开并粘贴即可使用。它适用于浏览器中可见的任何页面,包括其他工具无法触及的仪表盘、管理面板以及需要身份验证的页面。其底层原理是将 Figma 原生的 capture.js 嵌入到了书签中。更多信息请阅读博文。你的浏览器不支持视频标签。
抱歉。
这份数据展示了 20 个 AI 模型的性能排行榜,这些模型很可能与编程或技术任务相关。排名榜首的是 **Fable 5**,以 2,726 分和 81.7% 的闭环率位居第一。 性能趋势显示,随着分值的增加,闭环率呈现明显的下降趋势。表现最好的模型(Fable 5、Opus 2 和 Kimi K3)的闭环率保持在 50% 以上,而排名第 13 位及以后的模型则表现欠佳,成功率降至 15% 以下。 数据凸显了一个竞争激烈的格局,主要由 Claude、GPT、Kimi 和 Grok 架构的各种迭代版本主导。大多数顶级模型依赖于专用的代码执行环境(例如 `claude-code`、`codex`、`grok-cli`),其计算能力需求从“高”到“超高”不等。虽然许多模型目前处于“已关闭”状态,但包括 Qwen 3.8 Max、DeepSeek V4 Pro 和 Grok 4.6 在内的几个模型仍处于活跃状态或运行过程中,这表明相关的开发和评估工作仍在持续进行。
抱歉。
这本由 Bruce Eckel 编写的综合指南,透过惯用模式和架构的视角,对现代编程进行了深入探讨。全书分为五个核心部分: * **基础(Foundations):** 涵盖基本的语言机制,包括类型、类、模块和控制流。 * **技术(Techniques):** 专注于高级编程工具,如装饰器、上下文管理器、并发处理和性能优化。 * **模式(Patterns):** 提供了一系列经典与现代的设计模式(如工厂模式、观察者模式和状态机),重点在于重构与实际应用。 * **函数式编程(Functional Programming):** 探讨函数式编程范式、错误处理及逻辑保证。 * **效应(Effects):** 讨论状态管理、生成器以及无状态设计的实现。 本书反映了当前的行业标准,强调构建可维护、高效且结构良好的代码。内容已根据知识共享(Creative Commons)许可协议免费在线发布,配套的代码示例和习题解答托管在 GitHub 上。
Bruce Eckel 的新书《Thinking in Python》在 Hacker News 上引发了广泛讨论。作为“Thinking in...”系列书籍的资深作者,Eckel 公开承认利用 AI(Claude)来撰写本书,并表示 AI 使他能够实现以前因难度过大或工作量过重而难以完成的复杂功能,例如交错注释的代码清单。
社区对此反应不一。一些用户称赞该书格式清晰且见解深刻,特别是关于“效应管理(effect management)”的章节;而另一些用户则对 AI 生成的内容表示怀疑,将其称为“垃圾(slop)”或低密度内容。此外,关于该书授权方式(CC BY-NC-ND 4.0)的争议也随之出现,这使得重新分发修改后的文件(如自定义 EPUB)变得复杂。
除了书籍本身,讨论还演变为关于 AI 在编程领域作用的广泛争论。批评者认为,大语言模型是“专业的胡扯者”,掩盖了其缺乏理解的事实;而支持者则认为,当 AI 在高质量源材料的约束下运行时,其输出逻辑严密、密度高且复杂,能够媲美甚至超过人类的技术写作。该书目前已在网上免费提供,但暂无出版实体书的计划。
大语言模型(LLM)的兴起正从根本上改变开发者的编程方式,使得编程语言的选择变得愈发不重要。由于 AI 智能体可以轻松转换代码或处理程序员不熟悉的语言,开发者不再受限于学习语法所带来的“摩擦力”。 这种转变促使更多项目开始采用 Rust 和 Zig 等“难度较高”的高性能语言。得益于大语言模型在优化代码以及处理 eBPF、自定义加密和 DWARF 文件等复杂领域方面的卓越能力,那些曾经被认为过于困难或难以入门的技术,如今已在广大开发者的触及范围内。 在行业追求“轻量、快速、高效”软件的氛围推动下,开发者正利用人工智能绕过传统的准入门槛。虽然这种复杂编程的平民化可能会导致“劣质内容”增加,但它同时也让新一代开发者能够构建起以往无法涉足的高性能系统。
抱歉。
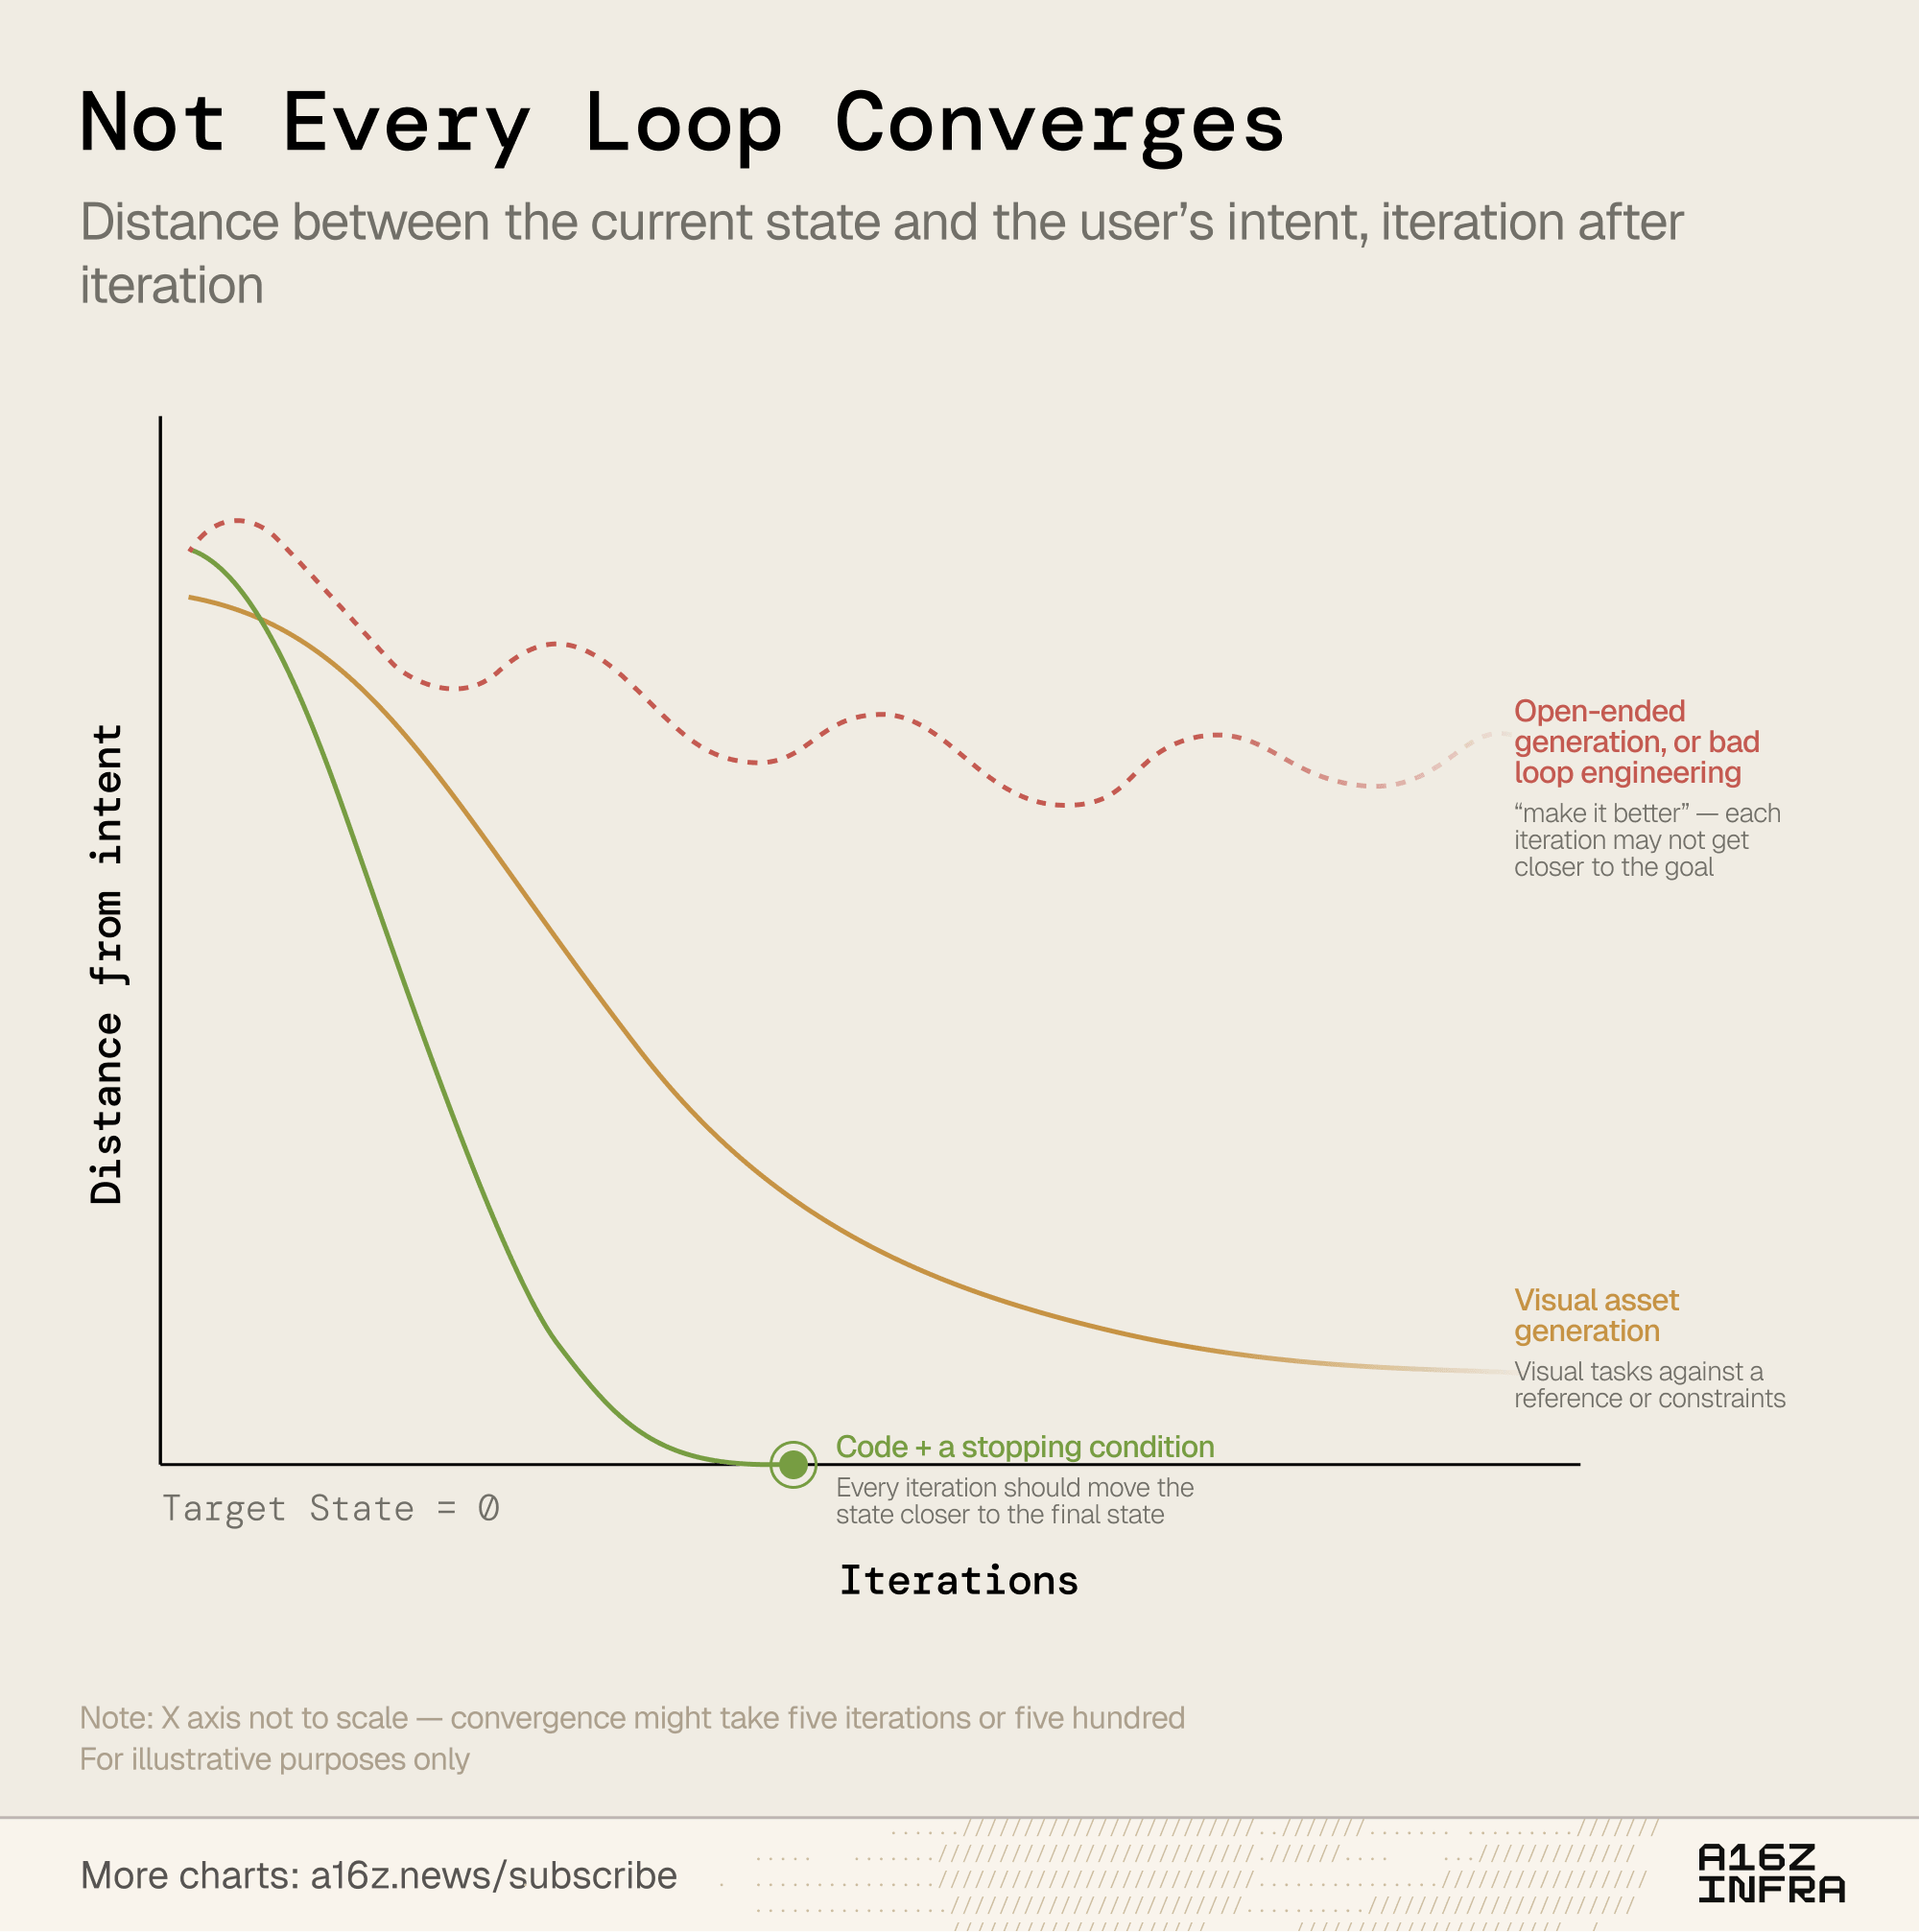 AI 模型缺乏对“完成”的内在感知。与人类不同,人类依赖外部信号——如截止日期、同行评审或边际收益递减——而模型会无限期地进行迭代。因此,高效的 AI 开发已从简单的提示词工程转向**“循环工程”(loop engineering)**,即让系统自行验证进度。
然而,循环的有效性取决于其验证机制。如果验证信号存在缺陷(例如,测试通过但未满足实际用户意图),循环就会收敛于错误的目标。成功的循环需要四个要素:明确的目标状态、可观察的当前状态、用于局部编辑的精确工具,以及稳健的停止规则。
目前,循环工程仍是一个反复试验的过程,因为高效的循环往往是针对特定环境定制的。此外,由于循环存在边际收益递减现象,它们很容易在不可能完成的任务上消耗过多的 token。由于 AI 无法自主决定何时停止,开发者必须构建基础设施来明确衡量进度并管理成本。归根结底,最成功的系统将不再是那些能够无限迭代的系统,而是那些构建者已经精准定义了何为“完成”及其应有成本的系统。
对不起。
您没有提供需要翻译的内容。请提供您想要翻译的文本。
抱歉。
这篇文章探讨了为何本地大语言模型(LLM)的实际表现往往难以达到基准测试所宣称的水平,并将这种“糟糕”的表现归因于硬件和软件的差异。 作者认为,即便使用完全相同的模型权重,你的本地推理环境(由特定的 GPU 架构、CUDA 内核、注意力后端和软件栈决定)在进行数学运算时也会产生差异。作者以 Qwen3.6-27B 为例,展示了选择不同的后端(如 FlashAttention 2 与 Triton)会导致“Token 翻转”和输出分歧,特别是在长上下文及智能体任务中表现尤为明显。 此外,量化对模型可靠性有显著影响。作者测试了多种权重量化方法,结果表明,性能较差的实现方式——即使是官方发布的“FP4”版本——也可能导致模型出现幻觉,或无法完成高精度格式(如 INT8)能够正确处理的工具调用任务。 **关键点:** * **实现至关重要:** CUDA 内核和数学运算的差异会产生不同的输出分布。 * **上下文为王:** 简单的基准测试已不足够;长上下文和工具调用任务才能揭示真正的性能稳定性。 * **量化是一种权衡:** 低精度格式往往以牺牲逻辑和准确性为代价,可能在智能体工作流中引发严重错误。 作者强调,虽然“数学就是数学”,但这些数学运算在你的特定软件栈上如何执行,决定了模型是否真的有效。
Hacker News 上的资深用户普遍认为,本地大语言模型(LLM)之所以常给人一种“更笨”的感觉,并非源于模型本身,而是受配置、基础设施和用户操作不当所致。
主要结论如下:
* **配置陷阱:** 用户常因模型表现不佳而责怪模型本身,但真正的罪魁祸首往往是聊天模板错误、采样参数设置不当或量化方式不合理。像 Ollama 这类工具的默认设置往往为了易用性而牺牲了准确性,从而导致性能下降。
* **基础设施至关重要:** 许多用户建议直接使用 `llama.cpp` 运行模型,而非通过高级封装工具,因为前者能提供对硬件资源的精细化控制。过度量化或使用过于“精简”的蒸馏模型会显著削弱模型的推理能力。
* **上下文管理:** 配置不当的上下文窗口和激进的 KV 缓存剔除是导致逻辑死循环和模型变“笨”的常见原因。
* **基准测试:** 盲目依赖通用基准测试具有误导性,因为模型往往针对这些测试进行了过拟合。专家建议根据特定用例构建可复现的自定义测试工具。
* **硬件现实:** 在本地运行大型、非量化模型需要充足的显存(VRAM);否则,严重的性能衰减会使智能体工作流变得极其缓慢或不可靠。
运作原理 你的 JPEG 依然是普通的 JPEG。为了适配网页,我们添加了 ISO 21496-1 增益图(Gain Map)——这是一张微小的灰度辅助图像,用于告知支持 HDR 的软件每个像素可以提亮多少。对于 LinkedIn,我们以 BT.2100 PQ 格式写入像素,并附带相应的 ICC 配置文件,LinkedIn 会保留这些信息。 何种效果最耀眼 深色背景下的明亮、近白色元素。经实测,最理想的增强幅度为 +2.9 档(约 1,500 尼特)。深色部分无法真正产生“发光”效果,强行提亮只会显得像泛白的霓虹灯。 局限性 HDR 效果仅在支持增益图或 PQ 配置文件的软件(如 Chrome、Safari 26、Apple Photos、LinkedIn 应用)及 HDR 显示器上可见。大多数其他平台会剔除或标准化这些数据,在该环境下,图片依然看起来完全正常。
抱歉。
在这篇 2005 年的感言中,网络管理员 Gary Rolland 分享了他将公司关键服务器基础设施从 Windows 切换到 NetBSD 后,如何显著改善了他的职业和个人生活。 Rolland 曾管理着 29 台服务于 4800 多名用户的高端服务器,此前他一直深受 Windows 环境极不稳定性的困扰。频繁的系统故障经常迫使他放弃家庭计划,包括一次令人难忘的奥尔顿塔(Alton Towers)之旅,这给他带来了巨大的压力和家庭矛盾。 深感挫败的 Rolland 成功提议将公司关键任务服务——包括 MySQL、Apache、Postfix 和 Samba——迁移到 NetBSD 2.0.2。此次转型非常成功;新环境提供了卓越的稳定性,每天处理超过 870GB 的数据,且停机时间极短。 这种可靠性消除了紧急呼叫和周末值班的需要,使 Rolland 获得了他以前所缺乏的工作与生活平衡。他在结尾对 NetBSD 团队表达了深深的感谢,并指出他们的项目不仅提高了公司的运营效率,还让他能够享受与家人的美好时光,最终在没有系统崩溃干扰的情况下重游了奥尔顿塔。
这段 Hacker News 讨论帖回顾了类 Unix 操作系统的早期岁月,重点探讨了社区与 NetBSD、FreeBSD 和 Gentoo 共同的历史记忆。
参与者们怀念那个充满“赛博朋克”色彩的计算时代,其特点是陡峭的学习曲线以及从零构建系统所带来的审美满足感。许多贡献者强调了这些平台的教育价值;例如,Gentoo 用户认为正是通过深入学习系统底层的运行机制,才为他们的职业生涯打下了基础。
讨论还根据核心设计理念对各 BSD 系统进行了区分:FreeBSD 以性能和驱动支持见长,OpenBSD 侧重于安全性,而 NetBSD 则以其在各种硬件架构上无与伦比的可移植性著称。资深用户回味了这些系统相较于早期 Linux 发行版所展现出的“纯净”,也有人谈到了使用 SPARC 工作站等过时硬件带来的怀旧情怀。总的来说,该讨论帖表达了对这些项目的感激之情,将它们描述为极具价值、“可黑客化”且至关重要的工具,正是这些工具定义了一代 IT 专业人士的技术身份。