 中国发布了一项大规模召回计划,涉及超过400万辆汽车,其中包括近300万辆中国产特斯拉。召回原因是其“隐藏式”伸缩门把手存在安全隐患。这种嵌入车门面板的极简设计引发了担忧,因为在发生碰撞后车辆断电等紧急情况下,车内人员或救援人员可能难以操作。
小鹏、小米和吉利等其他制造商也受到此次召回影响。对此,特斯拉计划通过软件更新和在受影响车辆上张贴警告标签来解决问题。
此次召回与中国收紧的安全法规相一致,中国近期宣布将禁用隐藏式门把手。自2027年1月1日起,在中国销售的所有新车必须在车门内外均配备机械释放装置。虽然这一举措针对的是中国市场,但该设计在美国也面临类似的审视,监管机构正考虑为此类机制建立新的安全标准。
每日HackerNews RSS
抱歉。
 前《橘郡风云》主演本·麦肯锡(Ben McKenzie)已从演员转型为加密货币行业的直言不讳的批评者,他将其描述为“历史上最大的庞氏骗局”。凭借经济学本科学位,麦肯锡在疫情期间开始调查该行业,并最终在美国参议院作证。
他针对加密货币的这场运动记录在他的新片《所有人都在为了钱对你撒谎》(*Everyone Is Lying To You For Money*)中。这部由他与记者雅各布·西尔弗曼(Jacob Silverman)共同编导的纪录片探讨了2022年的市场崩盘,并收录了对身败名裂的FTX创始人山姆·班克曼-弗里德(Sam Bankman-Fried)的采访。麦肯锡认为,加密货币主要作为赌博和犯罪活动的工具,而非合法的金融替代品。尽管该行业依然存在并获得了一些政治支持,但麦肯锡仍致力于揭露他眼中的这一危险骗局,尽管他偶尔也会回想起自己曾作为青少年偶像的往事。
抱歉。
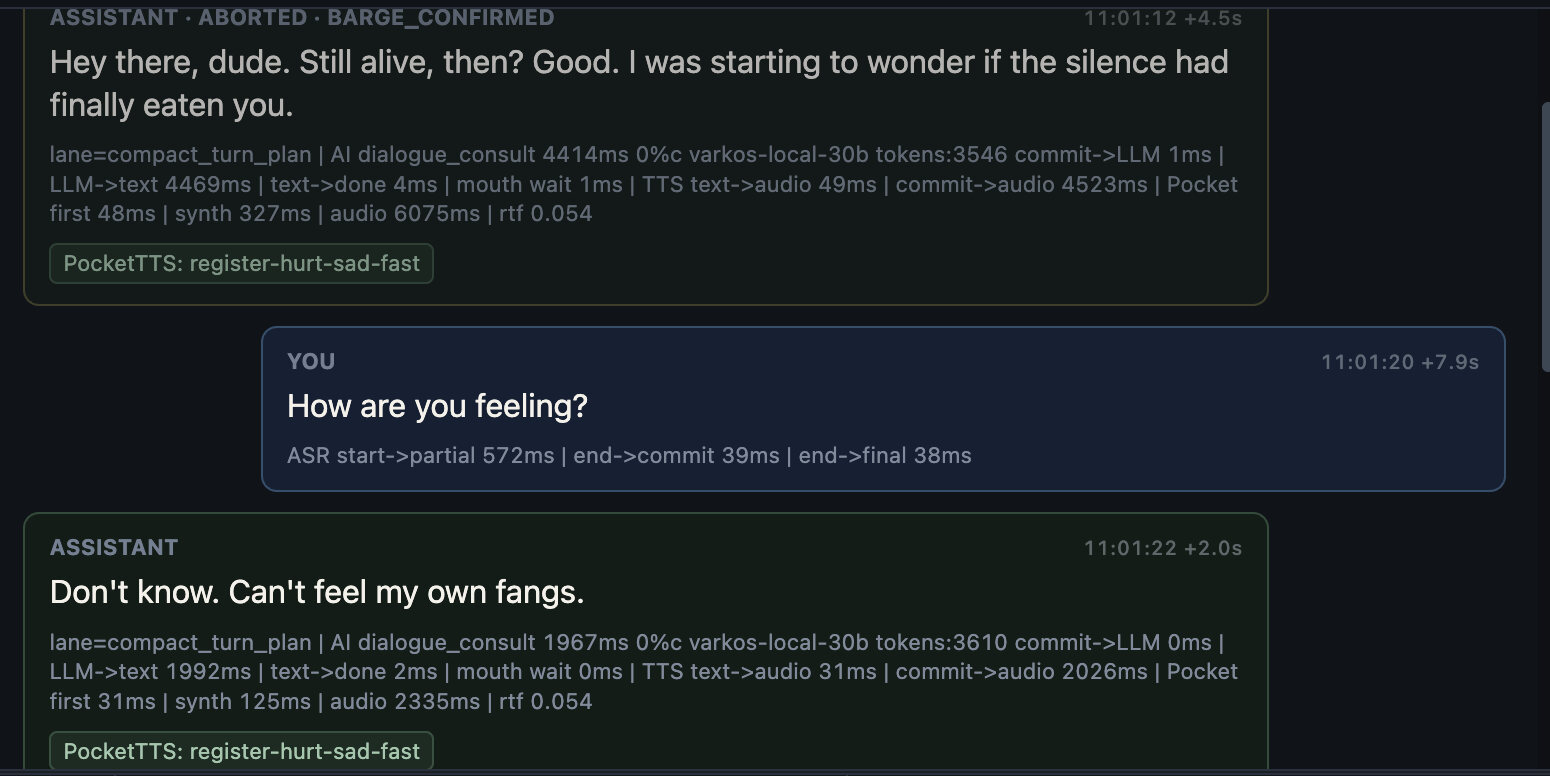 Varkos 是一款智能实时游戏伴侣,旨在超越单纯的对话式人工智能。与现有的在延迟和任务执行方面表现不佳的框架不同,Varkos 扮演着交互式伙伴的角色,能够在《上古卷轴》等游戏中执行战斗、拾取物品以及处理复杂的多步骤规划。
主要功能包括:
* **真正的自主性**:Varkos 不仅仅提供脚本化的回复,还能执行复杂指令,例如等待特定触发条件或执行多阶段的物品收集任务。
* **低延迟**:通过采用定制技术栈(用于动作映射的 ALE 和经过优化的本地大语言模型/语音识别),系统实现了近乎瞬时的响应,确保了流畅且不间断的游戏体验。
* **持久的个性**:Varkos 拥有基于共同经历而不断演变的个性。它可以被配置为以特定特质开始——例如转世为狗的刻薄恶魔——并随着时间的推移变得更加温顺。
* **平台无关性**:Varkos 被设计为“可插件化”,作为一个持久存在的实体,最终能够跟随玩家跨越不同的游戏世界。
通过优先考虑本地私有处理和物理世界交互,而非基于云端的聊天机器人,Varkos 提供了更具沉浸感的体验,使 AI 感觉像是一个真实的伙伴,而非仅仅是一个文本生成器。
一位开发者为《上古卷轴5:天际》打造了一款低延迟、本地运行的 AI 同伴,能够与游戏世界及玩家进行互动。与典型的大语言模型(LLM)实现方式不同,该系统采用了混合方案:利用“ALE”模型将自然语言指令解析为确定性的游戏动作,而由 LLM 负责处理性格、语音和背景文本。
该项目在 Hacker News 上引发了关于游戏领域 AI 未来的热烈讨论。支持者称赞了该同伴“笨拙”却滑稽的涌现行为——将其比作一个偶尔会捣乱的真实宠物——并将其视为动态、程序化游戏世界的先驱。
然而,批评者则持怀疑态度。许多玩家对 AI 的集成持抵触心理,理由包括对非确定性游戏玩法的担忧、“恐怖谷”效应,以及不可靠的同伴可能破坏潜行或战术部署等问题。其他顾虑还涉及硬件需求、开发者叙事控制权的缺失,以及 AI 生成内容可能流于空洞的风险。尽管存在争议,作者仍计划将该项目开源,将其定位为对“AI 如何增强而非取代人类主导游戏设计”这一课题的探索。
请启用 JavaScript 和 Cookie 以继续。
抱歉。
将数据从旧的群晖(Synology)NAS 迁移到新的 Ubiquiti UNAS Pro 8 的过程比预想的更为复杂,这表明标准的迁移工具需要仔细调整,以避免出现性能瓶颈。 迁移过程中的关键点包括: * **备用数据流(ADS):** 导致文件出现“文件系统限制”错误的元凶通常是隐藏的 ADS 元数据。使用 Robocopy 的 `/COPY:DATX` 参数可以有效解决此问题。 * **“可重启”模式的代价:** 虽然 `/Z`(可重启)参数在连接不稳定时很有用,但在稳定的局域网环境下,它会显著降低性能。移除该参数后,传输吞吐量大幅提升。 * **性能调优:** Robocopy 的 `/MT`(多线程)参数取决于具体工作负载;对于此次迁移,`/MT:4` 是最优选择。此外,尽管对于大文件通常推荐使用 `/J`(无缓冲 I/O)参数,但在本次 NAS 到 NAS 的传输中,该参数反而适得其反。 * **网络利用率:** 借助 SMB 多通道(SMB Multichannel)技术,群晖 NAS 能够同时使用全部四个 1GbE 接口,这打破了“旧硬件是主要瓶颈”的固有认知。 最终,作者发现通过 Windows 中转并配合定制的 Robocopy 命令,比直接进行 NAS 到 NAS 的 rsync 同步效果更好,平均速度达到约 187 MB/s。
抱歉。
西班牙目前正面临严重的人口失衡问题:一方面,马德里和巴塞罗那等主要城市深受过度旅游之苦;另一方面,由于年轻人迁往城市工作,该国 42% 的乡村面临彻底荒废的风险。这一趋势正威胁着当地重要的文化和农业传统。 为解决这一问题,胡安·巴贝德(Juan Barbed)创立了“Rooral”项目,旨在通过吸引数字游民来到偏远社区,弥合城乡之间的鸿沟。这些远程办公人员通过在村庄居住,带动了当地经济,为淡季时的房屋租赁、酒吧和小企业提供了支持。 至关重要的是,Rooral 不仅仅是旅游,而是将社区融合放在首位。该项目鼓励参与者通过研讨会、聚餐以及农业劳动或语言交流等共同活动,与当地居民互动。通过建立真实的联结,该项目有助于重振乡村生活,确保居民和访客都能从这种互助交流中受益。正如当地领导人所指出的,这些新面孔的涌入不仅提供了必要的经济稳定性,也增强了西班牙高风险村庄的社会纽带。
抱歉。
 Git `worktree` 是一项强大的功能,允许你在多个分支上同时工作,而无需暂存(stash)进度或在单个目录中切换上下文。
通过创建共享相同底层仓库历史的独立链接工作目录,你可以保持并行任务的隔离。这在处理功能开发和紧急热修复时特别有用:你可以在一个文件夹中开发,在另一个文件夹中修复漏洞,并保持主目录整洁以进行审查或合并。
**主要命令:**
* **添加:** `git worktree add <路径> <分支>` 为特定分支创建一个新目录。
* **列出:** `git worktree list` 显示你当前活动的工作树。
* **移除:** `git worktree remove <路径>` 在完成后清理目录。
* **清理:** `git worktree prune` 移除手动删除目录后的元数据。
**限制:** 每个分支在同一时间只能被检出一个工作树。
通过采用“一个任务、一个分支、一个目录”的工作流程,你可以消除 `git checkout` 和 `git stash` 带来的持续摩擦,使你的开发过程更简洁、更快速、更有条理。
抱歉。
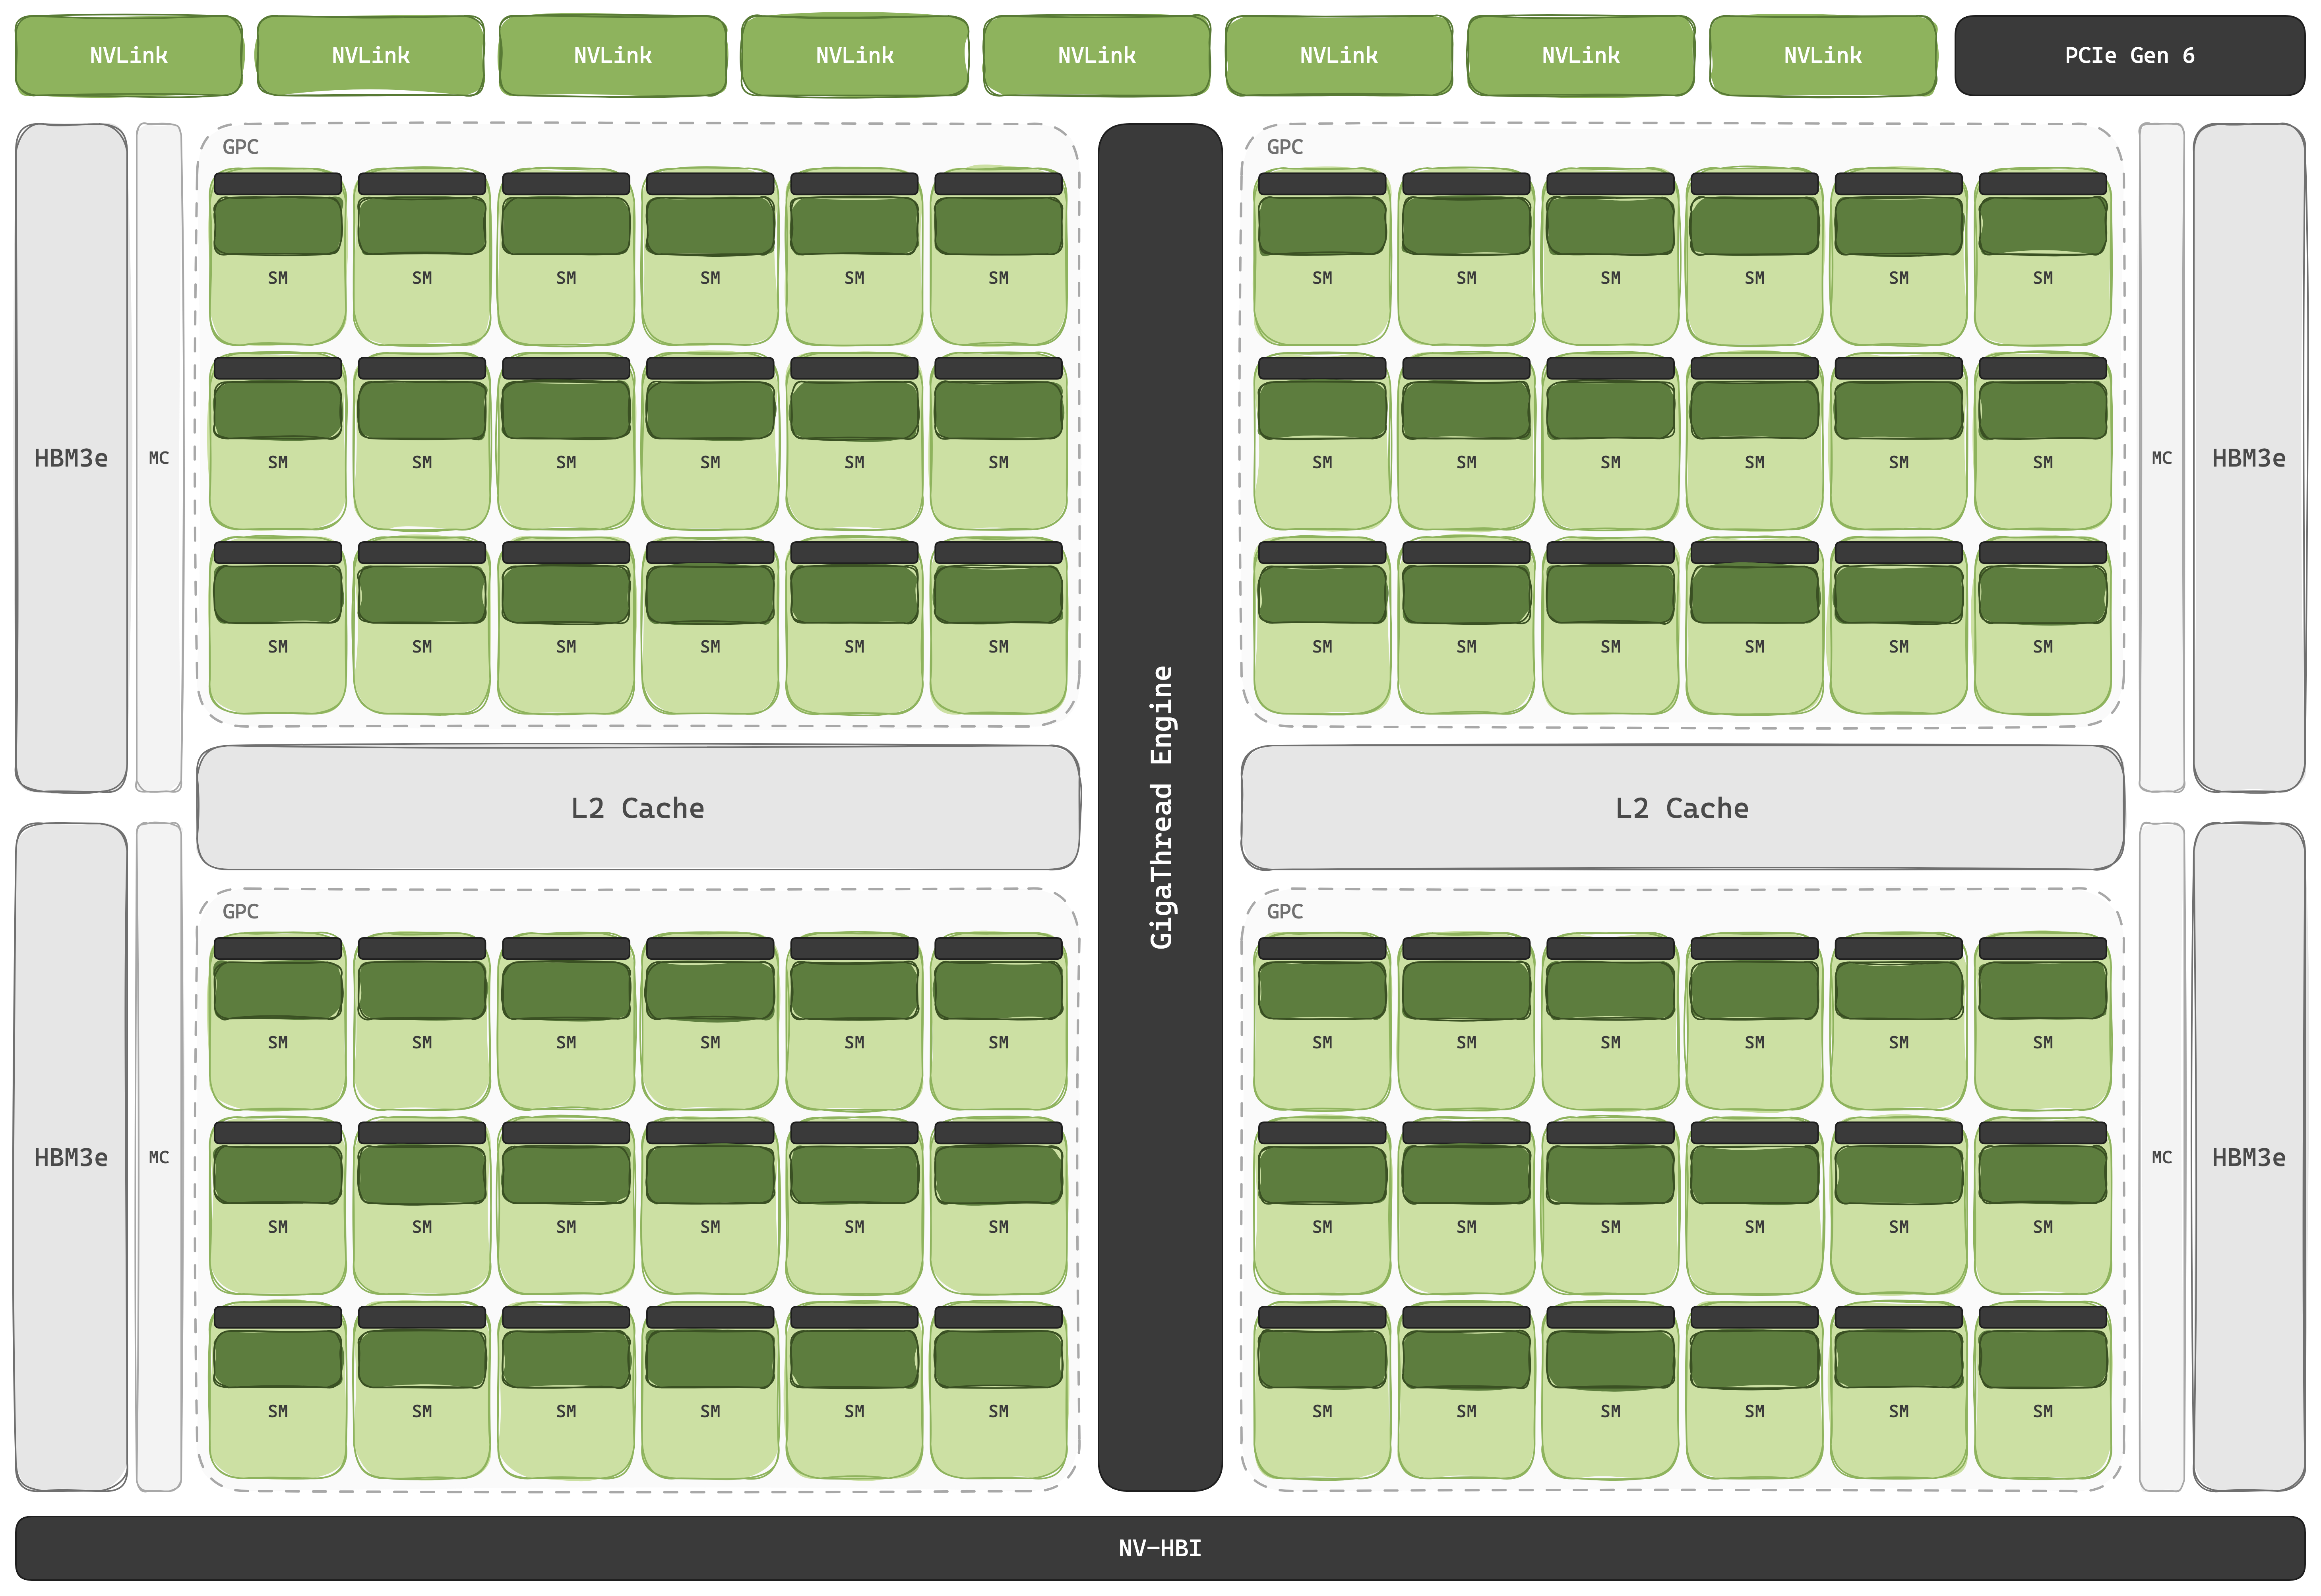 本摘要涵盖了计算机架构从 2018 年“黄金时代”预言到当前专用 AI 硬件时代的发展历程。
### 向领域专用架构 (DSA) 的转变
随着摩尔定律和登纳德缩放比例定律的放缓,通用 CPU 已无法维持性能的增长。行业转向了 DSA——即针对神经网络基本运算(矩阵乘法)进行优化的硬件。“内存墙”问题——即计算速度超过数据传输速度——已成为主要的硬件设计瓶颈。
### 关键架构方法
* **NVIDIA (GPU):** 坚持“大规模并行”理念。利用可编程 CUDA 核心和专用 Tensor Core 将计算与内存操作融合。其护城河不仅是硬件,更在于二十年积累的软件(CUDA/cuDNN)及开发人员经验。
* **Google (TPU):** 以“编译器优先”为核心的矩阵引擎。通过使用脉动阵列并移除动态硬件(缓存/调度器),使 XLA 编译器能够调度每一个时钟周期。它强调通过液冷、数千枚芯片组成的集群实现大规模扩展。
* **AMD (Instinct):** 采用基于小芯片 (Chiplet) 的策略,强调海量的 HBM 容量和开放标准互联(UALink/UEC)。旨在通过利用开源生态(ROCm/Triton)而非垂直专有堆栈来挑战 NVIDIA。
* **Cerebras (WSE):** 最激进的方法。它将整片晶圆作为一个处理器,彻底消除了芯片间的延迟。将内存(SRAM)视为一级资源,为特定的延迟敏感型任务提供了无与伦比的带宽。
* **AWS (Trainium):** 云原生架构的后续产品,模仿了 TPU 的编译器驱动设计,并集成到 AWS 现有的 Nitro 网络中。其优势在于垂直整合——以更低的成本提供大规模计算能力(例如为 Anthropic 提供支持)。
* **Groq (LPU):** 一种“确定性”机器。通过移除所有反应式硬件(无缓存/无分支预测器),实现了完全可预测的延迟。目前作为 NVIDIA 系统中的高速推理协处理器运行。
### 总结
现代 AI 基础设施分为**可编程性**(NVIDIA)、**编译器驱动的效率**(TPU/Trainium)以及**极致的延迟/带宽**(Cerebras/Groq)。尽管 NVIDIA 仍处于领先地位,但行业正趋向于采用开放标准(Triton/UEC/OCP)与专用小芯片架构的组合,以突破内存墙的限制。
抱歉。
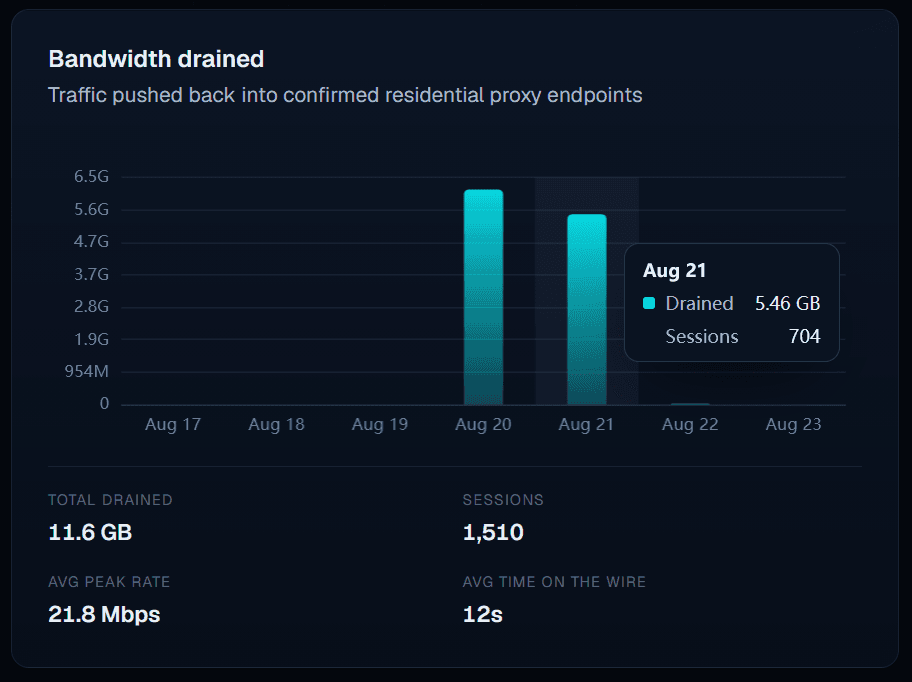 Layer3 Intel 为其 Tripwire 代理检测工具推出了“带宽消耗”(bandwidth drain)功能,旨在使网页抓取在经济上变得不可行。
大多数反机器人工具仅会阻止可疑流量,而抓取者可以通过轮换 IP 地址来绕过这些限制。相比之下,Tripwire 的“带宽消耗”功能会识别出高置信度的住宅代理连接,并强制其下载最多 10MB 的数据。由于住宅代理提供商按千兆字节收费,这会显著增加每次请求的成本,从而将常规抓取转化为一项昂贵的操作。
该功能效果显著:在测试中,它迫使抓取者支付了超过 11GB 的不必要流量费用,导致其在 48 小时内停止了抓取活动。为防止误报,该功能采用选择性加入机制,仅在严格匹配 Layer3 的住宅代理数据库,且确认流量为转发代理连接时才会激活。
通过将经济负担转嫁给操作者,Tripwire 超越了简单的拦截,从根本上改变了大规模抓取的经济成本。现有用户只需更新其 Tripwire 代码片段参数即可启用此功能。
抱歉。
 **Pngine** 是一种声明式格式和运行时,旨在简化 WebGPU 的“连接”过程。通过使用与 WebGPU 规范一一对应的 S-表达式,它允许开发者将着色器、管线和渲染通道定义为结构化、人类可读的数据。
主要功能包括:
* **验证**:通过 LSP 对 WebGPU 配置执行静态分析和规范检查,无需实时上下文即可捕获错误。
* **可移植性**:声明式代码可以导出为 HTML、ZIP,甚至嵌入到 **PNG 文件**中。这些图像既是视觉预览,也是自包含的可执行程序,通过小型运行时解释嵌入的字节码。
* **跨平台**:作为一种“基底”设计,它适用于浏览器、Rust (wgpu)、Android 和 iOS,消除了对特定语言样板代码的需求。
* **抽象**:在保持 WGSL 原样不变的同时,它为构建场景图或材质节点等更高级的工具提供了稳定且可组合的基础,使开发从程序化复杂性转向数据驱动的方法。
最终,Pngine 作为一个多功能的机器友好型环境,适用于底层图形实验,从而能够轻松地打包、验证和共享复杂的 GPU 工作流。
抱歉。