本摘要概述了 **Lemmalog** 的开发背景,该系统旨在解决大语言模型(LLM)智能体在执行漏洞研究等复杂任务时存在的“记忆”局限性。 在进行长期调查时,大语言模型往往难以维持准确且不断演进的状态,经常会遗忘已被证伪的假设或陷入循环推理。标准的记忆系统(如向量数据库)通过检索提供过去的信息,但无法管理逻辑一致性或因果依赖关系。 作者提出将大语言模型的调查过程视为一个**程序分析**问题。Lemmalog 充当了“编译器”的角色: * **大语言模型(前端):** 将杂乱无章的非结构化数据(代码、日志)提取为结构化事实。 * **Datalog(分析引擎):** 使用声明式逻辑管理这些事实。它能自动处理依赖关系跟踪、增量更新和撤回机制——如果某项输入事实被证明是错误的,系统会自动失效所有相关的结论。 基准测试显示,Lemmalog 在现有的记忆系统中极具竞争力,特别是在“知识更新”任务中表现优异。由于它通过维护状态而非重读整个对话历史,因此显著降低了 Token 的消耗。该项目证明,通过更好的结构化状态管理来取代“更多上下文”,可以有效提升智能体的可靠性。
每日HackerNews RSS
这篇 Hacker News 的讨论探讨了一个日益增长的共识:大型语言模型(LLM)应主要作为通信的“终端”,而非复杂推理的主要引擎。
参与者认为,LLM 在长期记忆、逻辑和事实一致性方面存在局限。一种更有效的架构是将严谨的工作分流给诸如 **Datalog** 或 **知识图谱** 等形式化系统。在这种“神经符号”方法下:
* **LLM** 负责自然语言理解和结果解释(处理“模糊”部分)。
* **符号系统** 负责管理逻辑、程序分析和事实数据库(处理“确定性”部分)。
讨论的一个核心主题是“风化”(Weathering)——即智能系统应随着时间推移不断优化自身结构。通过将 LLM 的推理提取为可复用的形式化规则,系统变得更加高效,从而降低了处理重复性任务的认知边际成本。
该共识建议摒弃“全能型” LLM 智能体,转而采用模块化的、由工具辅助的工作流。通过使用代码检查器(linters)、版本化决策日志以及形式化验证工具,用户可以超越当前模型在“随机性”方面的局限,构建出既可靠又易于调试的系统。
请启用 JavaScript 和 Cookie 以继续。
第九巡回上诉法院近日对预测市场平台 Kalshi 作出不利裁决,重申尽管该平台试图将其产品归类为商品期货,但体育博彩仍须遵守既定的州和联邦限制。
法院的一致裁决强调,联邦博彩法律并未被《商品交易法》所取代。此次判决驳回了 Kalshi 的策略,即通过将体育赛事结果等事件包装为“商品”合约来规避传统博彩监管。
Hacker News 上的讨论凸显了监管合规性与科技创业公司为颠覆既定行业而常采用的“先诉讼后处理”策略之间的持续矛盾。许多评论者指出,Kalshi 的商业模式依赖于在加密货币和零工经济领域中常见的“监管非对称”策略。
观察人士认为,此案反映了人们对国会不作为的更广泛担忧,这迫使司法机构去解读过时或模糊的法规。虽然有些人认为这是对企业规避博彩禁令行为的必要制约,但另一些人则指出,法院的干预是立法程序失灵的一种症状,导致重大的社会问题由法院而非民选代表来决定。
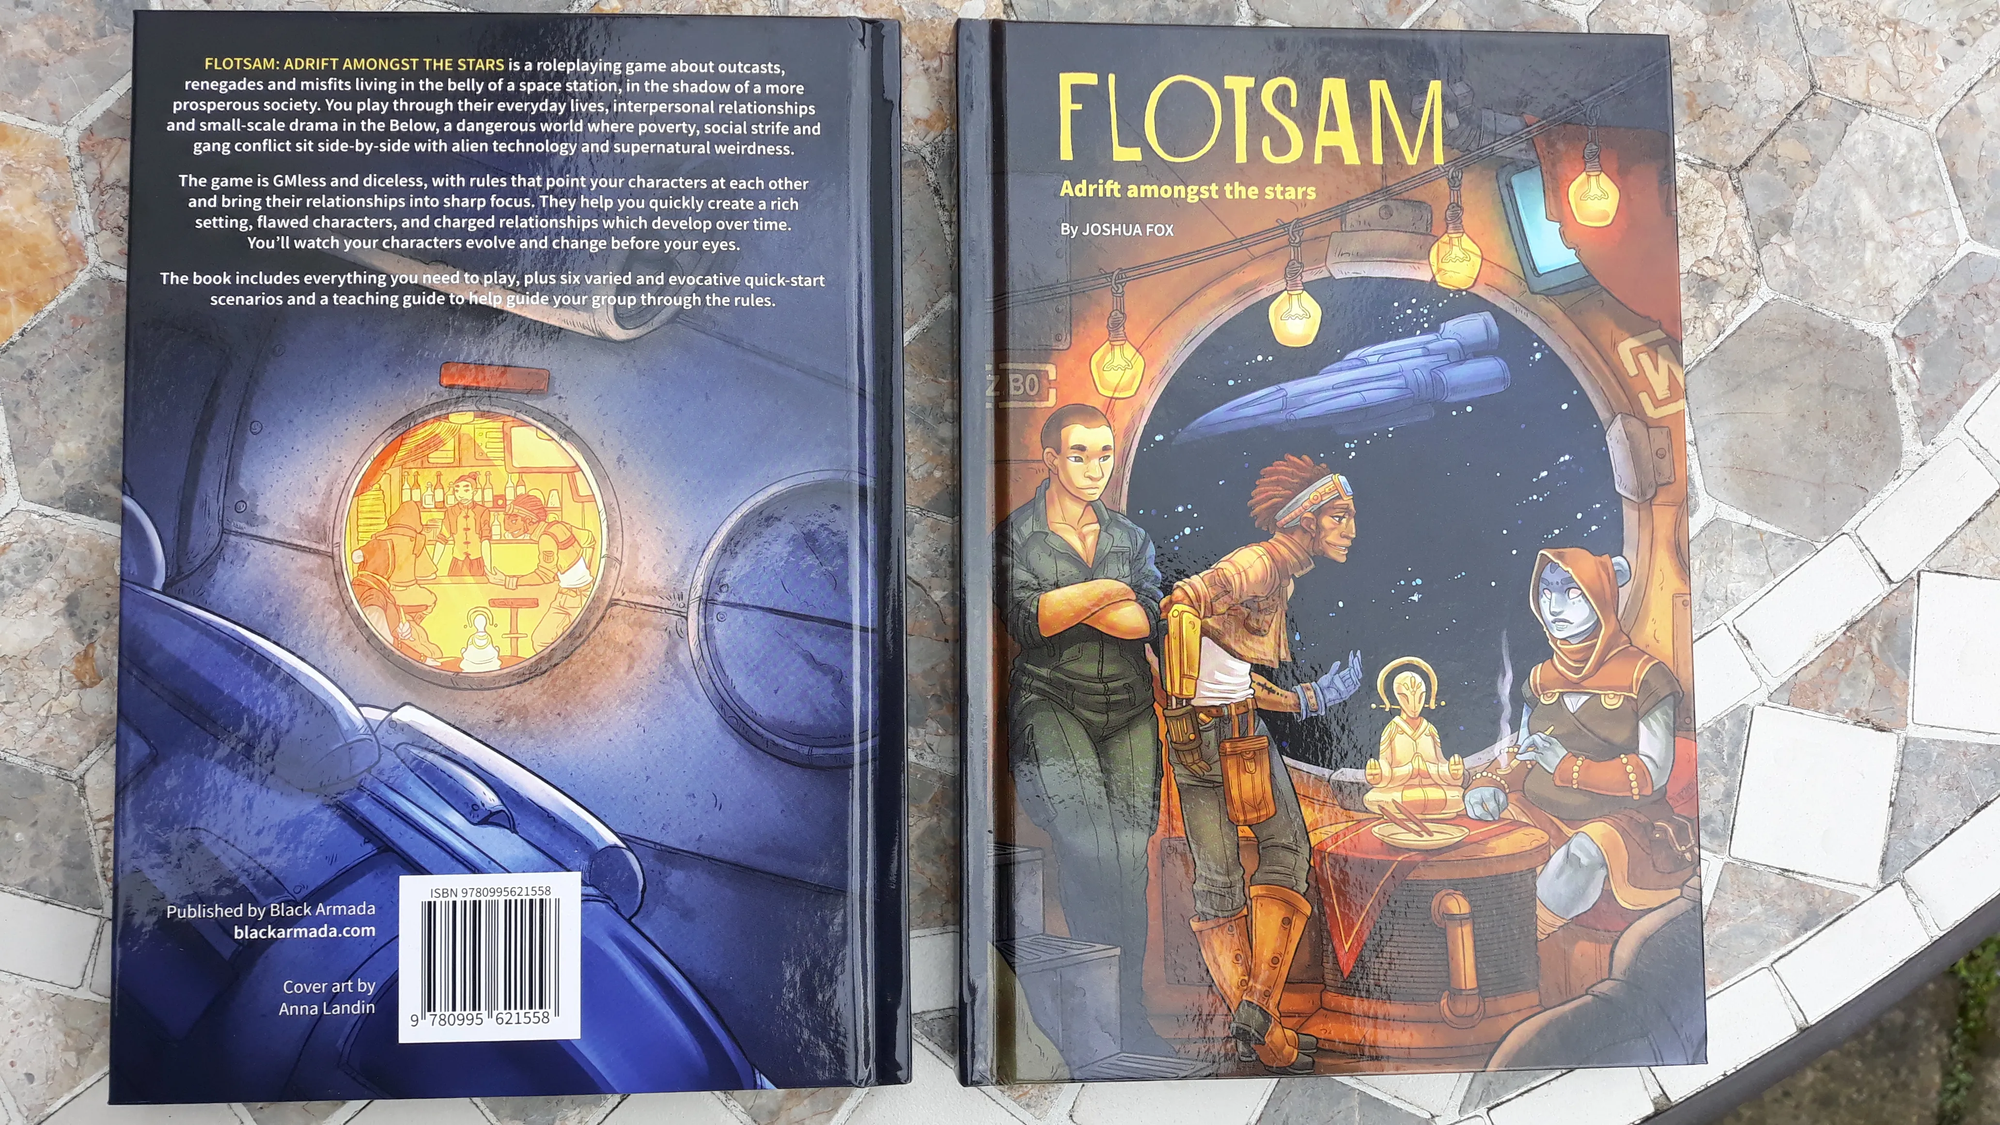 小型桌面角色扮演游戏(TRPG)出版商正难以应对欧盟新的《包装和包装废弃物法规》(PPWR)。该法规旨在减少浪费,但实施了复杂的“生产者责任延伸”(EPR)要求,且欧盟27个成员国之间的具体规定差异巨大。
对于小型创作者而言,这种监管负担极其沉重。设计人员表示,要应对各成员国之间参差不齐的注册费用、不一致的标签要求以及对“包装”定义的模糊界定,需要投入大量资源,而许多独立企业并不具备这些条件。因此,包括 Black Armada 和 Genesis of Legend Publishing 在内的多家出版商已暂时停止向欧盟国家发货,以规避潜在罚款,或仅将销售范围限制在利润最高的地区。
虽然分销商可以提供一种变通方案,但其不断上涨的成本往往让独立创作者望而却步,这可能会导致消费者面临更高的价格。许多设计师认为,PPWR 以及其他近期出现的立法障碍并未考虑到小规模经营的实际情况,迫使他们必须在昂贵的合规成本、法律制裁风险,或是完全放弃大部分国际市场之间做出选择。设计师们强调,尽管该法规的环保目标是合理的,但目前“一刀切”的实施方式正不成比例地威胁着小型桌面游戏企业的生存。
抱歉。
请启用 JavaScript 和 Cookie 以继续。
抱歉。
这项分析旨在探讨《苏美尔王表》(SKL)中大洪水之前的统治时长是否代表了对史前地质与气候事件的“扭曲记忆”。作者通过对241,200年的《苏美尔王表》序列进行重新缩放,并将其锚定在新仙女木期结束点(距今1.16万年),以此测试其与第四纪事件目录的统计一致性。 该研究使用高斯核函数对潜在匹配进行评分,评估了《苏美尔王表》序列与各种古气候及地质数据之间的关系。结果显示,两者并无统计学上的显著一致性。在所有测试配置中——包括针对多重比较的调整及探索性搜索——《苏美尔王表》序列的表现均未优于随机情况。使用其他古代年表(如《圣经》族长年龄)进行的类似测试也得出了相当的结果,这表明此类序列中明显的对齐很可能是巧合,而非编码的史实数据。 作者得出的结论是,没有可信证据表明《苏美尔王表》的统治顺序编码了特定的地质或气候标志。由于该分析具有探索性质,且在事件纳入与锚定方面存在主观选择,报告的p值可能高估了其显著性,从而进一步削弱了关于这些古代帝王名录是史前事件记录的假设。
抱歉。
 本指南概述了如何使用 `vphone-cli` 工具在 Apple Silicon 上引导虚拟化 iPhone。
**设置:**
通过 Homebrew 安装依赖项,克隆存储库,并运行 `./scripts/build.sh` 以编译工具链并打包应用程序。
**使用:**
该工具将整个虚拟化流程简化为一条命令:
`vphone-cli vm create <name> -V jb`
此命令可处理下载、打补丁、DFU 恢复以及自定义固件 (CFW) 的安装。各步骤也可手动执行以进行精细控制。可用的补丁版本从 "less"(最小化补丁)到 "exp"(反虚拟机检测及安全绕过)不等。
**主要功能:**
* **存储:** 虚拟机数据位于 `~/.vphone/`,可通过 `$VPHONE_ROOT` 进行重定向。
* **交互:** 通过 SSH (端口 22222) 或 VNC (端口 5901) 访问虚拟机。
* **自动化:** 主机控制套接字 (`vphone.sock`) 支持程序化交互,包括截图和模拟输入,适用于人工智能驱动的测试。
**要求:**
需要一台运行 macOS 15+ 的物理主机。为处理 Apple 的 AMFI 安全机制,用户必须禁用 SIP 并设置 `amfi_get_out_of_my_way` 启动参数,或使用 `vphone-amfidont` 工具将二进制文件加入白名单。设置时请确保地区设置为美国,以避免监管问题。
该项目由 `lakr233` 托管于 GitHub,允许用户在搭载 Apple 芯片的 Mac 上使用苹果原生的 `Virtualization.framework` 运行 iOS 虚拟机。它并非模拟器,而是通过使用官方 iOS 内核镜像(通常源自 Apple 的 Private Cloud Compute)并配合用户空间补丁来实现。
**核心要点:**
* **用途:** 对于需要比 Xcode iOS 模拟器更精确环境的安全研究人员、开发人员和测试人员而言,这是一个强大的工具。它支持内核级调试、自动化 UI 测试,以及测试模拟器无法支持的功能(例如特定的网络扩展或依赖硬件的行为)。
* **局限性:** 它并非物理 iPhone 的完美复制品;它无法访问许多苹果服务,且应用程序可以将其与真实硬件区分开来。受限于技术检查,某些地区性功能(如欧盟的替代应用市场)无法使用,在某些情况下还需要伪造位置数据。
* **社区反应:** 虽然该项目被视为逆向工程和测试领域的一项重大胜利,但用户也指出,它需要禁用系统完整性保护(SIP),并且仍是一个“猫鼠游戏”项目,未来可能会被苹果封锁。
 本文详细介绍了一项实验性尝试:通过日益超现实、繁杂且具有对抗性的提示词,试图推动人工智能(具体为 Claude Opus)突破标准编程输出的局限,去创建 PySide6 “待办事项”应用程序。
作者试图通过注入复杂的荒诞亚文化——从“中世纪乡村俱乐部风格”、“进取型小丑美学”,到“狄更斯式孤儿风格”——并要求人工智能根据随附的理论文章和设计手册编写数千行代码,来避开常见的软件套路。尽管作者极力想强制其产出“疯狂”或真正原创的结果,但该模型最终总是退回到可预测的平庸“劣质产出”。无论是通过黑帮威胁、苏格拉底式对话,还是丛林巨兽的传说来引导,模型总是默认回归到千篇一律的“三窗格暗黑模式”界面。
唯一成功的案例是要求人工智能模仿动画师莎莉·克鲁克香克(Sally Cruikshank)那种独特且易于识别的风格。最终,作者得出的结论是:大语言模型缺乏进行真正炼金术般创造性融合的能力;它们会将复杂的提示词压缩成低投入、程式化的“最小代表性内核”,从而无法打破标准样板化软件开发的窠臼。
抱歉。
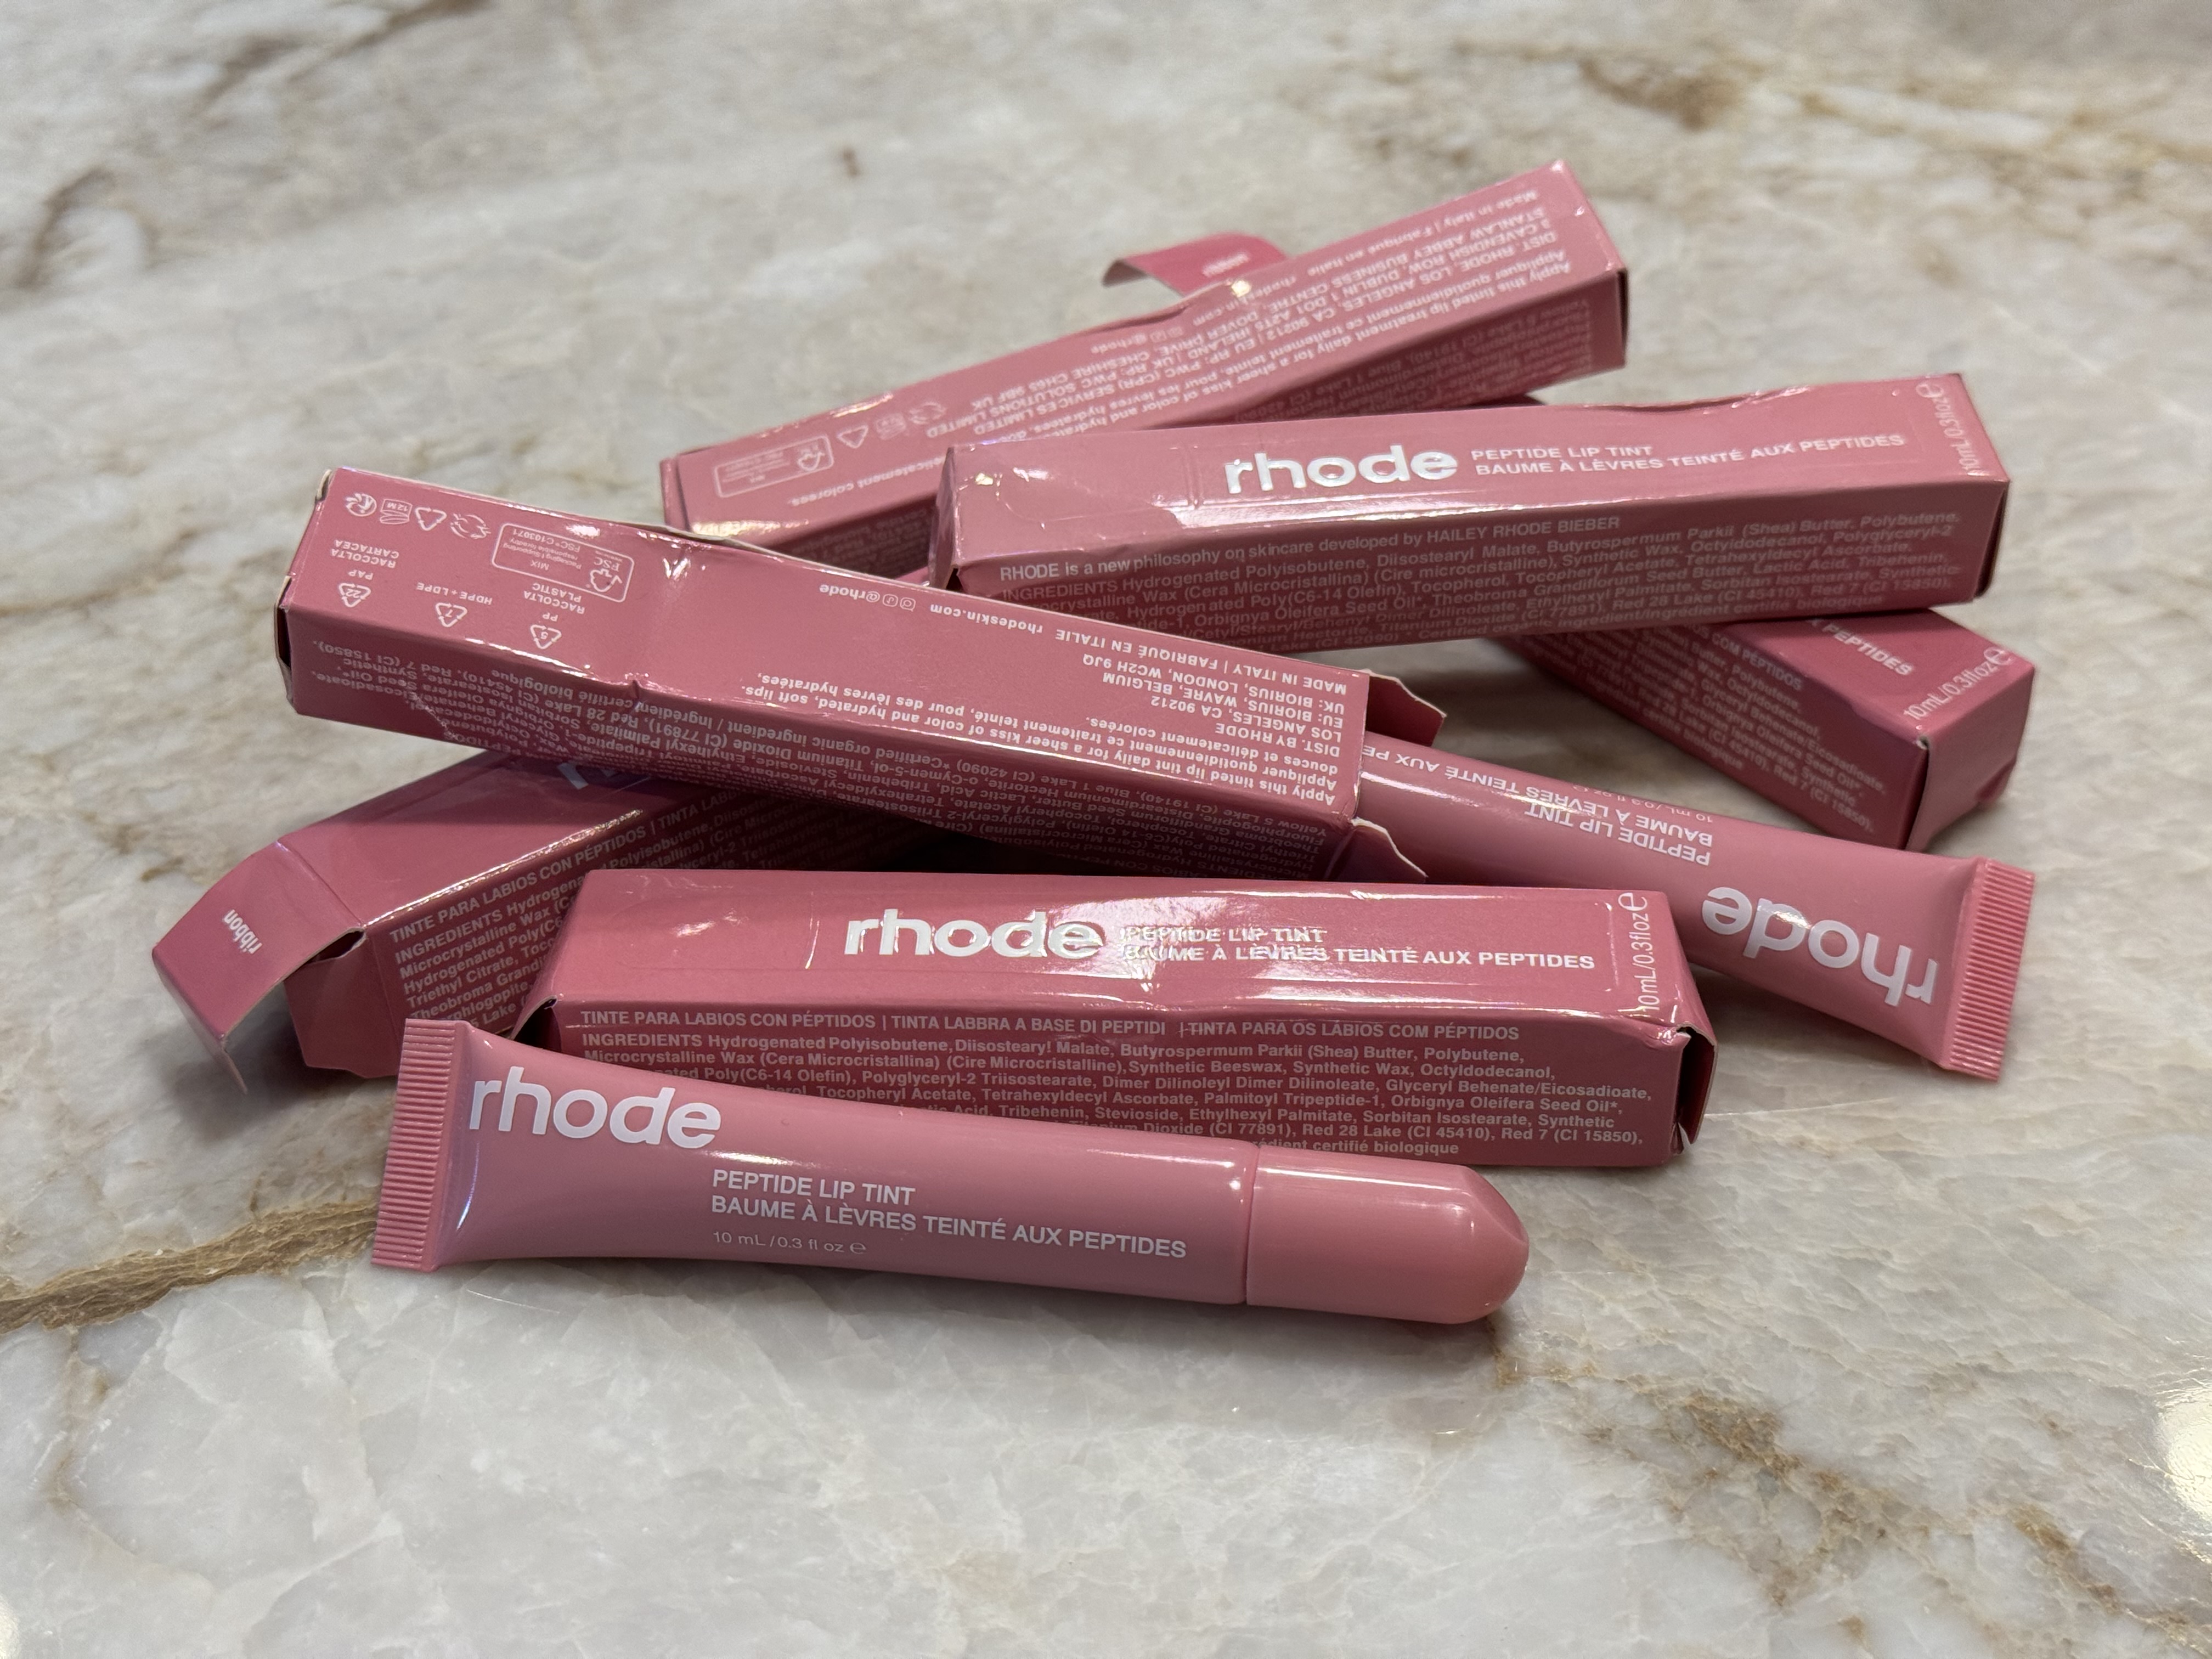 作者调查了谷歌 Gemini 等人工智能模型是否可以通过分析“Rhode Peptide Lip Tint”的照片来识别假冒化妆品。虽然 AI 通过发现细微的拼写错误、不匹配的经销商信息以及无效的邮政编码成功识别出两款假冒包装,但它也将一件从授权零售商处购买的正品误判为假货。
研究显示,AI 在检测人类可能忽略的不一致之处(如成分表中的复杂拼写错误或监管文件不匹配)方面表现出色。然而,AI 经常因为照片中出现的反光、阴影和图像失真等“幻觉”而犯错。此外,正品中也可能存在细微排版错误这一事实,表明基于 AI 的验证尚未做到万无一失。
最后,作者得出结论,虽然 AI 作为消费者识别假货的工具展现出巨大潜力,但目前对静态图像的依赖导致了不必要的错误。未来的改进方向可以通过使用视频分析来减少光线问题,并鼓励制造商确保包装无误。尽管存在局限性,但作者对 AI 保护消费者的潜力仍持谨慎乐观态度,前提是将其作为更广泛防伪策略的一部分来使用。
抱歉。
艺术二维码:对经典黑白二维码的一种创新演绎。 The ArtQrCode a twist on the classic black and white Quick Response Code
55 天前
ArtQrCode® 是一种高度可定制的二维码。它可以是静态的、视频格式的、打印出来的,甚至是 GIF 动图!它可以被打印在任何你喜欢的物体上,也可以显示在电子屏幕上!我们可以定制几乎任何形状、形式和颜色的 Art QR Code。
抱歉。
虽然 CSV 文件是一种流行且简单的表格数据格式,但一旦数据中包含逗号或引号,解析就会变得困难,因为目前没有官方规范来处理这些边缘情况。 为了解决这个问题,作者提倡使用 **CCSV(控制字符分隔值)**。CCSV 不使用逗号和换行符,而是利用不可打印的 ASCII 控制字符:单元分隔符(ASCII 31)用于分隔列,记录分隔符(ASCII 30)用于分隔行,传输结束字符(ASCII 4)用于标识结尾。由于这些字符不太可能出现在标准数据中,因此解析过程变得更加简便且稳健,无需复杂的逻辑来处理特殊符号。 然而,CCSV 也有一个明显的缺点:由于分隔符是不可打印字符,这些文件无法在标准文本编辑器中轻松阅读或手动编辑。尽管如此,作者认为该格式对于程序化使用非常高效,并特别称赞了使用传输结束字符作为文件结尾的明确标记。
关于“CCSV”(字符分隔值)——即使用不可打印的 ASCII 控制字符替代逗号的分隔格式——Hacker News 上的讨论最终认为,该格式在很大程度上是不切实际的。
尽管支持者认为使用特定的控制字符来分隔单元和记录可以避免标准 CSV 的解析复杂性(例如需要对字符串中的逗号进行转义),但社区指出其存在几个关键缺陷:
* **易用性差:** 文件变得难以编辑,无法在标准文本编辑器中查看,如果不使用专门的解码工具,也无法通过命令行工具读取。
* **缺乏互操作性:** 大多数电子表格软件和第三方工具不支持这些分隔符,这破坏了 CSV 的主要优势,即其通用、简单的可交换性。
* **多此一举:** 批评者认为,如果文件已不再可读,那么应该转向结构化的二进制格式(如 Protobuf)或得到广泛支持的替代方案(如 TSV,即制表符分隔值),而不是去重新发明一种“隐藏的”文本格式。
归根结底,用户认为尽管 CSV 有其令人沮丧之处,但其简单性和普及性使其成为一种“常青”标准。尽管现代技术试图通过晦涩的控制字符来“修复”它,但 CSV 在通用数据共享方面仍然更胜一筹。