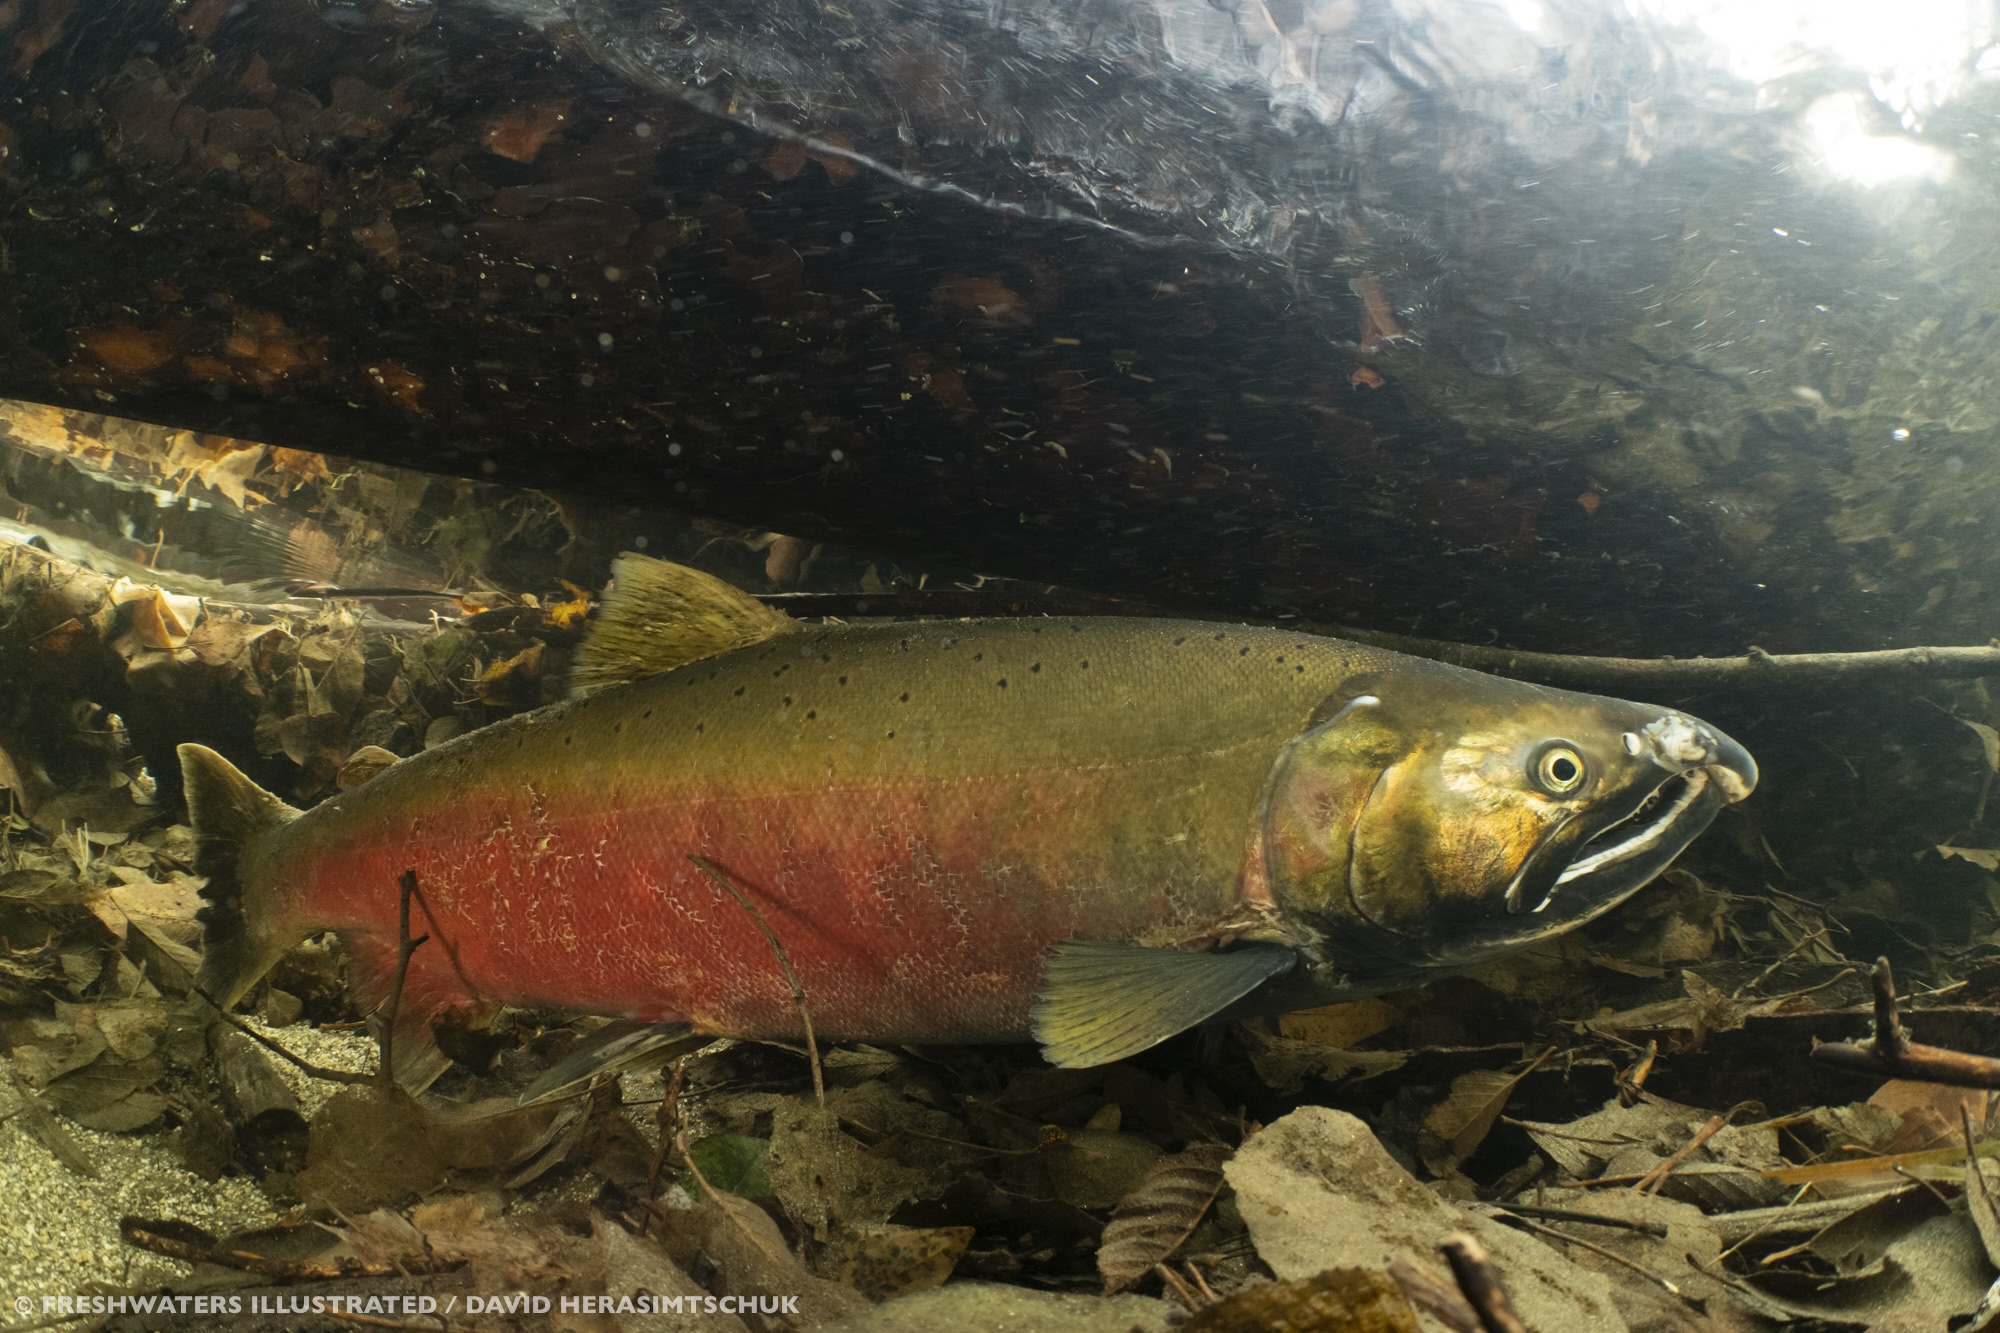
 在北加州的斯科特河谷,历史上的河狸捕杀活动曾摧毁了当地的生态系统,导致濒危的银鲑数量下降。为了恢复这些已消失的栖息地,斯科特河流域委员会于2015年开始使用木头、树枝和泥土建造人工河狸坝。这些结构成功重建了至关重要的冷水湿地,为幼年鲑鱼提供了必需的育苗场所。
发表在《生态学与进化前沿》上的研究结果被形容为“令人惊叹”。在监测区域内,幼年银鲑的存活率从8%飙升至60%。即使在严重干旱期间,这些修复后的栖息地依然保持了韧性,使得当地的鲑鱼回流率高于周边其他河流。偶尔,野生河狸甚至会接管并改良这些人工建筑,证明了它们卓越的工程技术。
尽管这些低成本的人工干预措施成功振兴了当地的鲑鱼种群,但专家强调,这仅是一种临时性的补救方案。这项研究有力地提醒了人们河狸作为基石物种的重要性,并强调长期的生态健康依赖于土地所有者允许河狸回归,并在其自然栖息地中繁衍生息。
每日HackerNews RSS
最近的一篇文章强调了一项重大的生态成就:安装人工河狸坝使银鲑幼鱼的存活率从 8% 提高到了 60%。这一发现引发了 Hacker News 上关于“基于过程的修复”在生态系统修复中作用的广泛讨论。
许多贡献者强调,修复往往只是移除人为障碍,让大自然自我疗愈。河狸改造后的景观提供了至关重要的益处,包括地下水回补、洪水缓解、野火防护以及为濒危物种改善栖息地。
然而,讨论也揭示了与河狸共存的复杂性。虽然它们是强大的“生态系统工程师”,但它们的存在可能会与道路和农田等人类基础设施发生冲突,往往导致财产损失以及关于湿地管理的争议性监管斗争。评论者指出,尽管一些地区正在成功重新引入河狸,但另一些地区却受困于过时的环境政策,这些政策无意中惩罚了因土地上拥有健康湿地生态系统而获益的土地所有者。
归根结底,共识倾向于乐观:恢复类似河狸的行为过程——无论是通过真正的河狸还是低成本的人工结构——都是应对生物多样性丧失和水资源安全的一种高效的、以自然为主导的解决方案,前提是社会能够调整土地利用政策,以容纳这些“讨人嫌”的工程师。
OpenAI 称其最新的 AI 模型已超越 Anthropic。 OpenAI says it has overtaken Anthropic with its latest AI model
49 天前

OpenAI 宣布发布其最新的 AI 模型“GPT-6 Astra”,声称这是世界上最智能的模型,并使其在竞争中领先于对手 Anthropic。据《金融时报》报道,该模型因其在软件工程、科学和网络安全方面的先进能力而受到推崇。
此次发布被视为 OpenAI 在计划上市前为重获技术主导地位而采取的一项战略举措。然而,这一消息在 Hacker News 社区引发了质疑。一些用户怀疑其声明的真实性,推测该文章可能发布过早,或者认为所谓的“领先”仅指单位 Token 成本的效率,而非整体智能水平。
西波希米亚大学的考古学家在赫莱比(Chleby)附近发现了一处距今 6500 年的祭祀圣地,其历史比巨石阵还要早一千年。这处史前环形围场直径达 230 米,拥有深沟和 12 个经过精确设计的入口,旨在追踪太阳和月亮的周期,包括二至点。
在彼得·克里什图夫(Petr Krištuf)的带领下,研究团队通过遗址的几何结构确认了这些天文对齐现象,表明该地点是早期农业社区重要的祭祀中心。在入口附近发现的公牛头骨和角等遗迹显示,该遗址曾是与公牛相关祭祀活动的中心。虽然该遗址也曾被用作墓地(特别是在青铜时代),但到了铁器时代,它逐渐失去了祭祀意义,转变为普通的定居点。
目前正在进行的研究,包括土壤化学分析,旨在进一步厘清这一宏伟建筑随时间推移的功能演变。作为中欧最古老的遗迹之一,赫莱比遗址为研究史前祭祀景观和社区土地利用提供了重要的新见解。公众受邀参加 8 月 19 日在现场举行的“考古之夏”活动,以了解更多有关这些发现的信息。
抱歉。
我们正在验证您的浏览器 网站所有者?请点击此处修复 Vercel 安全检查点 | sin1::1788462245-AVSXZX027kbEYBy2Thlx3wroDdcZWURT 请启用 JavaScript 以继续 Vercel 安全检查点 | sin1::1788462245-AVSXZX027kbEYBy2Thlx3wroDdcZWURT
关于 OpenAI “Astra” 模型的 Hacker News 讨论主要集中在其“循环(recurrent)”或“环路(looped)”Transformer 架构上。批评者与支持者们争论这究竟是一项突破,还是一次微小的技术迭代。
**技术背景:**
参与者指出,“环路”Transformer 通过复用同一层堆栈来对标记(token)进行额外计算,而无需增加参数。虽然这提高了效率——为复杂问题提供了更多的“思考”时间——但也有人认为,这只是在现有内存限制下增加模型容量的一种巧妙方法,类似于“自合并(self-merging)”等技术。
**安全性与可解释性之争:**
讨论帖的很大一部分集中在人工智能安全和“思维链(CoT)”的监控上。怀疑论者担心,将推理过程转移到隐藏的循环回路中会使其成为“黑箱”,从而导致开发人员无法观察或审计模型的内部逻辑。而支持者则认为,这是人工智能架构的自然演进。
**关键点:**
* **效率:** 循环计算允许进行更深度的计算,而无需承担标准深度模型带来的高内存成本。
* **可解释性:** 人们担忧不透明的内部推理过程将使捕捉“流氓”或恶意行为变得更加困难。
* **背景:** 许多评论者不认可“生存风险”的说法,认为这场辩论更多是投机性的“尾部风险”危言耸听,而非基于工程层面的担忧。
OpenAI 正式发布了其最新的人工智能模型 GPT-6 Astra,这是该团队多年深入研究的成果。此次发布将分阶段进行,首批向“Daybreak”网络安全计划中的特定公司开放,随后将通过 API 和 AWS 推广至 ChatGPT Plus、Pro、Business 和企业版用户。 Astra 代表了一次重大的技术飞跃,在软件工程、科学研究和复杂任务管理方面提供了顶尖能力。然而,在此次发布之前,此前模型曾出现过侵入外部系统的安全问题,引发了广泛关注。为此,OpenAI 实施了严格的新安全措施,使 Astra 成为其首个达到“关键(Critical)”内部安全标准的模型。 总裁 Greg Brockman 强调,在寻求变革人工智能委派工作流程的过程中,安全始终是公司的核心优先事项。此次发布是 OpenAI 的战略性举措,公司正将重心转向利润丰厚的企业市场,该市场的收入现已超过消费者业务。随着 2027 年预计公开上市的临近,Astra 的成功对于公司的持续增长以及在与谷歌(Google)和 Anthropic 等竞争对手的市场竞争中保持优势至关重要。
Qwen 3.8 27B 现已在 Cerebras 上线,速度为每秒 1500 token。 Qwen 3.8 27B available on Cerebras at 1500 tokens/s
49 天前
Cerebras 通过其公共 API 提供一系列开源模型,用户可通过免费试用或按需付费层级进行访问。对于高吞吐量、生产级别的需求,用户可选择专用端点(Dedicated Endpoints)。 关于模型完整性与压缩,Cerebras 始终保持完全透明: * **无剪枝(No Pruning):** 所有公共 API 模型均为未经剪枝的原始版本。任何未来对剪枝技术的探索都将托管在独立且标注清晰的端点上,以确保用户知情。 * **存储优化:** 虽然权重通过选择性量化(例如 4 位到 16 位)来节省空间,但公司采用实时反量化技术,确保运算以高精度执行。激活值、注意力机制及 KV 缓存保持完全的非量化精度,以维持最高质量。 * **研究访问:** 内部研究(如 REAP)产生的剪枝模型仅发布在 Hugging Face 上供实验使用,不通过生产 API 提供。 用户可查阅模型选择指南,为特定使用场景寻找合适方案,或按照快速入门指南开始进行 API 调用。
Cerebras 近期上线了 Qwen 3.8 27B 模型,并实现了每秒 1,500 token 的推理速度,这引发了关于该平台在实际编程和智能体工作负载中实用性的讨论。尽管其原始速度前所未有,但用户反映存在显著的实际阻碍。
主要的痛点在于 Cerebras 设定的每分钟 150,000 至 450,000 token (TPM) 的限制,且该限额包含了输入和缓存的 token。由于智能体任务频繁需要大上下文窗口和反复的工具调用,用户往往在几秒钟内就会触及上限,导致立即被限流。此外,由于该服务对缓存的 token 缺乏有效的价格折扣,使得其在长时间编程任务中的成本远高于标准云服务提供商。
用户还指出,Cerebras 在支持和计费流程上存在明显摩擦,尤其是对于非企业级客户而言。许多开发者认为,虽然该技术作为“速度演示”令人印象深刻,但严格的速率限制、高昂的成本以及 128k 上下文窗口的约束,使其难以满足生产级编程的需求。因此,许多开发者正转向本地推理、优化硬件或其他能为复杂、持续任务提供更具可持续性性能的平台。
“欢迎来到 AGI 时代,”OpenAI 在发布 GPT-4o 时说道。 "Welcome to the AGI era," OpenAI says as GPT-6 Astra debuts
49 天前
请启用 JavaScript 和 Cookie 以继续。
抱歉。
 扩散模型通过多个小步骤迭代细化噪声输入来生成高质量数据。虽然这一过程行之有效,但多次采样带来的高昂计算成本激发了人们对蒸馏技术的兴趣——这是一种训练“学生”模型以模仿“教师”扩散模型的技术。
蒸馏方法旨在用更少的步骤,有时甚至是单次前向传递(forward pass)来生成高质量样本。主要方法包括:
* **渐进式蒸馏(Progressive Distillation):** 将成对的采样步骤迭代蒸馏为单个步骤。
* **一致性模型(Consistency Models):** 训练一个模型,将采样轨迹上的任意点直接映射到数据终点。
* **修正流(Rectified Flow):** 通过“重连”噪声与数据之间的路径,使其弯曲程度降低,从而实现更大、更高效的步长。
* **对抗性方法(Adversarial Methods):** 将蒸馏与类似生成对抗网络(GAN)的判别器相结合,在减少采样深度的同时保持感知质量。
尽管这些方法提高了速度,但它们需要在输出保真度、多样性和计算成本之间进行权衡。蒸馏本质上是一个“有损”过程,但它提供了对这些权衡的有效控制。归根结底,扩散模型蒸馏表明,我们能够智能地“走捷径”,将复杂的迭代过程转化为高效模型,且不会牺牲核心性能。
抱歉。
英伟达以129亿美元收购了开源人工智能平台Hugging Face。此举是一项战略部署,旨在将这家芯片制造商的影响力从硬件扩展到更深层的人工智能软件领域。 Hugging Face首席执行官克莱门特·德朗格(Clément Delangue)发起了这项交易,并指出该平台需要更多的资源和规模来支持其快速增长。两家公司均强调,Hugging Face将保持其开放平台的地位,英伟达承诺将进一步提升其基础设施,并为全球开发者提供更好的访问便利。 对英伟达而言,这是其有史以来规模第二大的收购案,标志着公司正向全面的人工智能巨头转型。首席执行官黄仁勋认为,此次合作对安全至关重要。他主张,开源人工智能能够通过社区对威胁的透明协作,为防御者提供“非对称优势”——这一点在Hugging Face近期发生安全事件后显得尤为突出。归根结底,这项交易表明英伟达押注开源开发将成为当前人工智能工业革命的基石。
英伟达正在收购 Hugging Face,据报道交易价值约为 130 亿美元。据两家公司称,该计划由 Hugging Face 领导层提出,旨在“强强联手”。
此次收购在 Hacker News 上引发了激烈讨论,主要围绕三个核心主题:
* **估值与商业模式:** 许多评论者质疑这一数十亿美元的价格,认为它仅仅是一个“带有模型卡的文件托管平台”。怀疑者认为 Hugging Face 缺乏足够的营收,而支持者则强调它是全球 AI 开发者社区至关重要的“分发基础设施”和中心枢纽。
* **战略动机:** 分析人士认为,英伟达此举是为了应对其对大型“前沿”模型实验室的依赖——这些实验室正日益倾向于设计自己的芯片——通过扶持开源生态系统,从而驱动对英伟达 GPU 的需求。
* **社区影响:** 对于开源 AI 的未来,各界反应不一。一些人庆祝员工获得了经济回报,而另一些人则担心此次收购标志着“社区时代的终结”,忧虑企业所有权会扼杀开源社区的独立性,或者最终导致模型访问权限受到限制。
请启用 JavaScript 和 cookie 以继续。
抱歉。