 Proxylity UDP 网关 DTLS 监听器为 UDP 应用(如 RADIUS 或物联网协议)提供 TLS 风格的加密和认证,且无需更改底层数据报传输。通过建立 DTLS 1.2 或 1.3 会话,Proxylity 可解密传入的数据载荷,并将明文转发至您配置的 AWS 目标,同时对响应进行透明加密。
**主要特性:**
* **灵活的认证:** 支持基于证书的握手和预共享密钥 (PSK)。
* **安全性:** 提供可选的 Cookie 交换功能以降低放大攻击风险,并支持针对早期数据的重放保护。
* **高性能:** 支持会话恢复(DTLS 1.3 的 0-RTT)以减少握手延迟,并支持 DTLS 1.2 连接 ID,以便在网络变更或 NAT 重新绑定时维持会话。
* **部署:** 完全通过 CloudFormation (`Custom::ProxylityUdpGatewayListener`) 进行管理。管理员可通过客户端限制策略轮换证书并管理访问权限。
DTLS 监听器非常适合需要在保留数据报边界的同时进行加密 UDP 传输的应用。请注意,它们不支持 SCTP 或 WebRTC 信令层,这些由网关另行处理。
每日HackerNews RSS
 虽然 Python 的 `dict` 和 `set` 在理论上被视为 $O(1)$ 常数时间复杂度的数据结构,但这只是一个简化的模型,而非物理现实。在实际应用中,由于哈希冲突,更重要的是 CPU 缓存缺失(cache misses),它们的性能会随着数据规模的增加而下降。
随着字典容量的增长,它最终会超出高速 CPU 缓存的容量,迫使数据必须从较慢的主内存中读取。基准测试表明,当字典从一千个元素增长到一百万个元素时,其查找时间可能会增加十倍。虽然像 `fastconstmap` 这样专门的不可变库可以通过优化内存布局和缓存局部性来缓解这一问题,但根本结论是:常数时间复杂度仅是一种抽象。现实世界的性能受限于硬件,严格依赖理论模型可能会导致预期偏差。开发者应始终意识到,没有任何模型能完美地捕捉系统内存和执行的复杂性。
这篇 Hacker News 讨论批评了一篇宣称 Python 集合与字典呈现“二次方时间”性能的博文。评论者大多认为该说法具有误导性或属于标题党,并澄清哈希表操作在平均情况下为 $O(1)$,仅在哈希冲突的特定情况下会退化至 $O(n)$。
文中指出的性能问题并非 Python 数据结构本身的缺陷,而是源于“最坏情况”:
* **人为冲突:** 作者使用了特定的梅森素数($2^{61}-1$)作为乘数,这与 CPython 的内部整数哈希机制对齐,导致所有键都映射到了同一个哈希桶中。
* **开销与复杂度:** 用户指出,该基准测试还衡量了处理大整数(bignums)的成本,这类数字在比较和求和时本身就比标准整数慢。
批评者认为,“大 O”符号代表的是预期性能模型,而非针对对抗性输入的保障。普遍共识是,尽管“常数时间查找”这类抽象存在局限,但测试中展示的性能衰退是哈希表在面对非随机、易冲突数据时的已知行为,而非 Python 实现的失败。
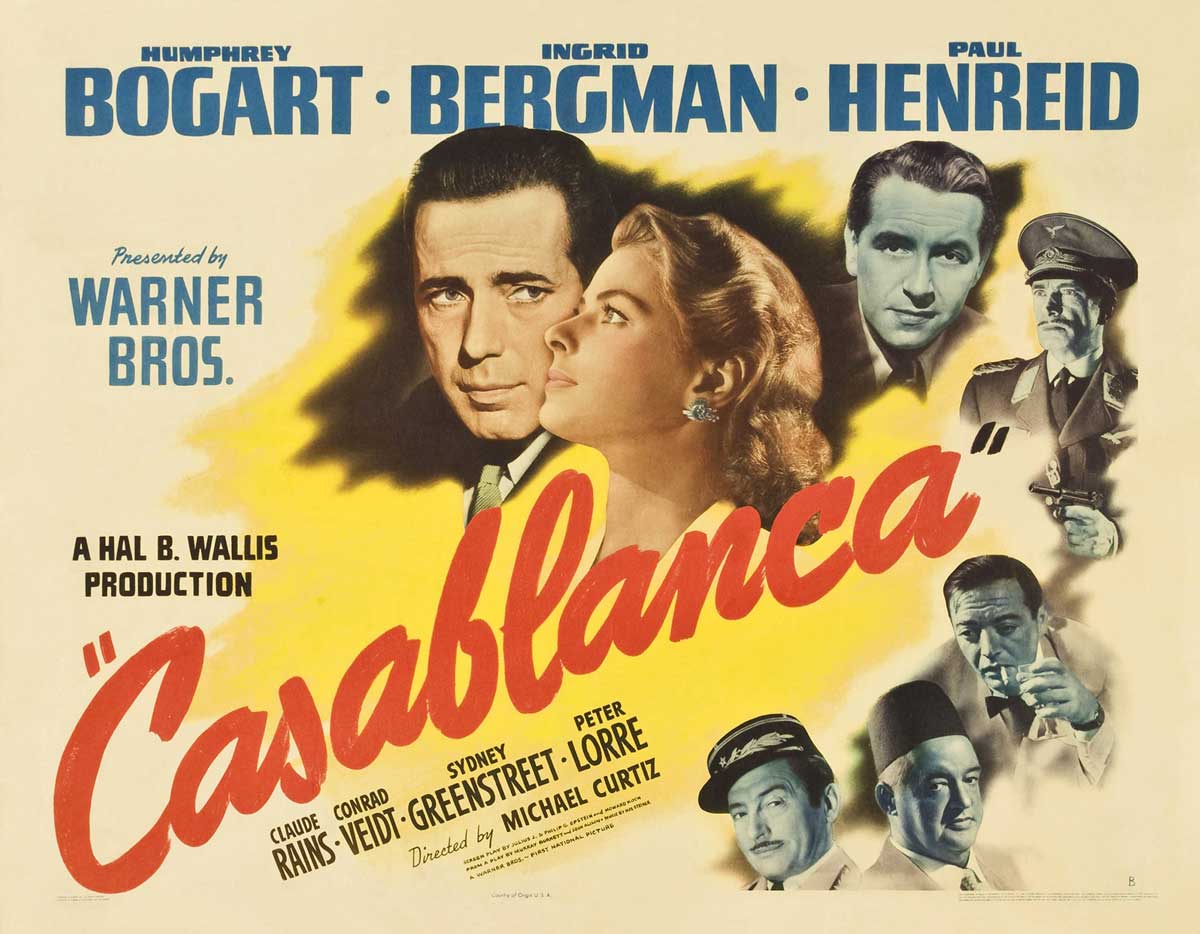 1942年上映的《卡萨布兰卡》至今仍是影史经典,以其传世的对白和永恒的战时恋情而著称。该片由华纳兄弟在第二次世界大战最激烈的时候制作,反映了当时现实世界中美国从保持中立到积极干预轴心国的立场转变。
故事讲述了瑞克·布莱恩(亨弗莱·鲍嘉饰)的故事,他是一位愤世嫉俗、深感幻灭的美国侨民,在摩洛哥经营一家夜总会。当他的前情人伊尔莎(英格丽·褒曼饰)带着身为反抗军领袖的丈夫出现时,瑞克的中立立场受到了挑战。随着他们在争夺离境签证的严峻斗争中周旋,瑞克经历了一场道德上的蜕变,这与美国从孤立主义走向介入世界的转变如出一辙。
该片由迈克尔·柯蒂斯执导,并拥有一支轮换的编剧团队,是在伯班克的摄影棚内精心打造的。它既是成功的通俗娱乐作品,也是深刻的寓言。通过瑞克咖啡馆里那些勇敢的流亡者等角色(其中许多演员本人就是从纳粹占领的欧洲逃出来的),影片捕捉到了坚韧不拔的精神。归根结底,《卡萨布兰卡》证明了电影激励人心的力量,它从个人的心碎出发,最终让人意识到,在暴政面前,有些事业值得为之奋斗。
抱歉。
 作者作为一名曾经苦于出勤率和课堂参与度的历史系学生,反思了自己如何凭借出色的论文写作能力,在教授们的误解中依然取得学业成功。作者认为,高效的非虚构写作依赖于两个基础要素:清晰的“主干”(主题)和明确的“论点”。通过保持一种层级结构——即论点作为树枝,并由证据支撑——作者能够保持写作的专注度与说服力。
至关重要的是,作者强调了针对特定受众的设计以及“语义波”的重要性。正如山径既有起伏,高效的写作也必须在抽象概念(知识打包)与具体实例(知识解包)之间波动。这种平衡能确保读者保持参与感,并在不感到枯燥或负担过重的情况下消化复杂信息。
最终,作者将这些通过练习和学术研讨会学到的结构化习惯,视为自己取得学术成就并成功转型为数据工程师的关键。作者总结道,虽然写作风格应适应各领域的特定规范,但掌握主题、论点与结构之间的关系,是撰写引人入胜的非虚构作品的通用准则。
抱歉。
11 跨分片事务 即将推出 在单个事务中跨分片写入。Neki 协调提交以确保原子性:要么所有分片都应用更改,要么全部不应用。 使用明确的工作流进行导入、重分片、模式变更、切换和清理。Neki 使分布式 Postgres 操作可重复执行。 13 在线版本升级 通过相同的在线迁移模型迁移到新的 Postgres 版本:创建目标分片组、复制、切换并停用旧分片组。 在源数据库持续处理流量的同时导入 Neki。执行复制、验证,并在目标就绪时进行切换。 每个 Neki 分片都有自己的 WAL 和逻辑复制路径。CDC 保持与标准 Postgres 模式和单分片数据流的兼容性。
Magic 正通过优先考虑“算法效率”而非海量原始算力,来推进前沿 AI 的发展。通过优化预训练方案,他们以不到以往 1/50 的算力消耗,实现了超越主流开源基座模型(如 DeepSeek V4 Pro)的性能表现。他们的研究表明,小型、高度优化的团队可以通过严谨的缩放定律、稳定的架构以及精细的数据整理,缩小与大型实验室竞争对手的差距。 其进展的核心要点包括: * **效率提升:** 其最新模型(V5)的计算效率比最初的 V2 基线高出约 500 倍,使其能以极低的成本达到前沿水平的性能。 * **方法论:** 该团队不仅依赖规模扩展,还利用来自 167 个领域的数据反馈,并对多种模型规模进行评估,以确保优化方案在万亿参数规模下依然有效。 * **未来重点:** 在具备成熟的预训练和长上下文能力后,Magic 正将重心转向“长程代理强化学习(RL)”,旨在构建自主编程和 AI 研发代理。 Magic 旨在证明,卓越的个人判断和严谨的研究方法可以克服目前由大型行业巨头所主导的巨大硬件优势。
PlanetScale 推出了全新的 PostgreSQL 扩展平台 **Neki**,目前已开放预览。Neki 旨在解决单实例 Postgres 的局限性,通过处理真空清理(vacuuming)、连接限制和维护窗口等常见的扩展瓶颈,且无需进行应用层分片,同时保持了与 Postgres 的完全兼容。 得益于该公司在管理大规模 MySQL 集群方面的八年经验,Neki 在每个分片上都运行真实的 PostgreSQL。其架构包含四个主要组件: * **路由器(Routers):** 处理分布式查询规划与路由。 * **分片组(Shard Groups):** 支持将工作负载扩展至多个真实的 Postgres 实例。 * **连接池(Connection Pooling):** 通过 Sidecar 优化以提升性能。 * **控制平面(Control Plane):** 管理模式变更、重新分片和升级的自动化工作流,确保零停机。 Neki 集成了分支(branching)和模式洞察(schema insights)等 PlanetScale 的常用功能。用户起初可将其作为单主实例使用,随后根据需求进行横向扩展。尽管 Neki 目前处于预览阶段,不建议用于生产环境,但用户可通过 PlanetScale 控制面板申请试用,以探索其架构与功能。
PlanetScale 最近发布了 **Neki**,这是一款专为处理大规模数据库负载而设计的分片 PostgreSQL 解决方案。
这一公告在 Hacker News 上引发了热烈讨论,主要集中在以下三个方面:
* **沟通缺失:** 许多用户批评最初的发布博文未能清晰解释 Neki 的本质。社区对关键细节被掩盖或缺失表示不满,尽管 PlanetScale 在收到反馈后更新了博文。
* **开源担忧:** Neki 目前是专有软件,这令那些期望它是开源工具的用户感到失望,尤其是考虑到 PlanetScale 在开源 Vitess 项目上的历史背景。公司领导层则为闭源模式辩护,称这是对抗 AWS 等大型云服务商的竞争必要手段。
* **技术审查:** 技术讨论主要集中在一致性保证、跨分片操作的查询处理,以及 Neki 与 Citus 和 Multigres 等现有工具的对比。
此外,讨论中还出现了关于 PlanetScale 首席执行官 Sam Lambert 沟通风格的争议。他对比特竞争对手的激进态度引发了截然不同的反应:一些人认为这是不专业的“兄弟会”式行为,而另一些人则欣赏他的透明度和好战风格。
本网站正在使用安全服务来保护自身免受网络攻击。您刚才的操作触发了安全防御机制。触发此拦截的原因可能有多种,包括提交了特定的词汇或短语、SQL 命令或格式错误的数据。
Windows XP 使用什么算法来选择你的初始用户头像? What algorithm did Windows XP use to choose your initial user picture?
41 天前
Windows XP 使用单遍蓄水池采样算法来选择默认用户账户头像,该算法通过 `RtlRandomEx` 函数并由 `GetTickCount()` 提供种子。 与传统的两遍采样方法相比,这种方法具有两大优势。首先,它通过减少文件系统调用(这是性能瓶颈所在)提高了效率。其次,即使在执行过程中文件目录发生变化,它依然能保持稳定性。 该算法通过遍历文件实现,其中第 $n$ 个项目被选为“获胜者”的概率为 $1/n$。这确保了在单遍遍历中实现数学上合理的随机选择。为了防止包含大量文件的目录出现性能问题或“病态行为”,代码中设置了一个安全限制,将采样过程限制在最多 100 张图像。
这篇 Hacker News 讨论聚焦于微软开发者 Raymond Chen 发布的一篇文章,内容涉及 Windows XP 分配随机用户头像所使用的算法。
主要结论是:Windows XP 使用了**蓄水池抽样(reservoir sampling)**算法——这是一种允许程序在单次遍历中从未知大小的数据流中随机选择一项的技术。在当时,这被认为是“优雅的”,因为它避免了多次文件系统遍历带来的性能损耗,这在 21 世纪初缓慢的机械硬盘上尤为重要。
评论区围绕软件工程中的权衡展开了热烈讨论:
* **性能与复杂性:** 许多用户认为这种复杂性并无必要,而另一些人则指出,在硬件资源受限的年代,微小而高效的决策至关重要。
* **“旧”与“新” Windows:** 讨论引发了怀旧情绪,用户将 Windows XP 的用户界面与其前代(2000, 95)及后继版本(Vista, 7)进行了对比,并经常争论 Windows 设计的“巅峰”时期。
* **代码质量:** 对话突显了技术权衡的演变,指出现代开发往往为了提升开发效率而牺牲性能,这与 Windows XP 时代那种受限且高度优化的环境形成了鲜明对比。
日立全球生活解决方案公司将于2026年11月在日本推出全新的“Y系列”EcoCute二氧化碳热泵热水器。该系列提供370升和460升两种容量,适用于三至六口之家,属于现有平台基础上的升级,而非彻底的重新设计。 此次升级的核心在于增强了能源管理功能。Y系列增强了对日本电价政策的兼容性,旨在鼓励用户在白天加热,特别是对于配备太阳能光伏(PV)系统的家庭。用户可通过设备的遥控器轻松选择此类电价模式。虽然这些机型保留了原有的家庭能源管理系统(HEMS)连接功能和Echonet Lite兼容性,但重点在于根据电网需求的变化和太阳能发电量的增加来优化能源使用。 为了提升可靠性,日立提供为期五年的综合制造商保修,涵盖热泵、储水箱及集成通信组件。目前尚未披露完整的能效规格。