什么是 StemJSON? StemJSON 是一种基于 JSON 的声明式语言,非常适合 AI 生成全面且高性能的原生应用界面与逻辑,无论是构建新应用还是扩展现有应用,皆可适用。该格式完全开放。你可以将其放入 AI 工具、原型开发环境、IDE 插件中,或与手写代码结合使用,从而简化并加速原生应用的设计、开发与交付。 声明式、AI 可读、原生、开放。 立即体验 →
每日HackerNews RSS
StemJSON 是一种基于 JSON 构建的新型领域特定语言,旨在让 AI 能够实时生成并更新原生移动应用功能。通过为 UI 组件和应用程序逻辑提供结构化架构,StemJSON 能够让大语言模型(LLM)输出可在 iOS 和 Android 上原生渲染的功能模块,而无需提交应用商店审核。
在 Hacker News 的讨论中,创作者 vkrychun 阐明,虽然由大语言模型生成输出,但 StemJSON 充当了 AI 提示词与应用程序运行时之间的桥梁。与无法在已发布应用中轻松执行的原始代码不同,StemJSON 作为一种序列化载荷发挥作用。这使得开发者能够交付可复用且表现如同原生代码的服务器驱动型 UI(SDUI)或 AI 生成功能。尽管有评论质疑是否有必要在现有格式之外另辟一种语言,但创作者认为,在移动环境中,一套用于描述应用行为的专用词汇对于保证可靠性和性能至关重要。
 iOS 27 和 macOS “Golden Gate” 的泄露细节显示,苹果已为 Siri 设计了一种复杂的模块化架构,旨在从深层的系统层面支持第三方 AI 模型。
代码研究员“pdfu”发现了两个关键协议。第一个协议是“模型委派”(Model Delegation),它允许 Claude 等外部模型作为 Siri 的扩展运行,在解读用户需求后,将设置提醒等系统任务交还给苹果处理。第二个更高级的协议是“模型管理服务”(Model Manager Services),它甚至可能允许 GPT-5.6 等第三方模型完全取代苹果服务器端的 Siri 模型,使它们能够在调用 Siri 原生界面的同时,跨邮件和信息等系统应用执行复杂的多步骤任务。
这种互操作性很可能是受欧盟《数字市场法案》(DMA)的影响,该法案要求苹果向第三方提供与其自身服务平等的访问权限。尽管目前的最终候选版本仅限于使用 ChatGPT,但这些发现证实,苹果正在为一个支持多种 AI 的生态系统构建稳健的框架。虽然该架构尚未向用户或开发者开放,但它已使 Siri 有望进化为一个通用的接口,能够将任何用户偏好的 AI 模型集成到苹果的核心体验中。
苹果代码中的最新发现表明,Siri 的架构正在进行调整,以便支持接入 Claude 或 ChatGPT 等其他人工智能模型。这一发现引发了 Hacker News 上关于语音助手未来及苹果生态战略的广泛讨论。
评论者们对语音 AI 的实用性看法不一。一些人认为语音是一种不精确且低效的交互方式,而另一些人则将其视为处理简单任务的便捷工具,若能实现更好的集成,将成为智能家居领域的突破口。讨论的焦点多在于:这种“模型切换”是出于灵活性的战略选择,还是为符合欧盟《数字市场法案》(DMA)而采取的被动举措。
批评者认为,苹果放弃自研 AI 转而使用第三方产品,是为了在保持平台控制权的同时实现“向上失败”。另一些人则将其视为一种“天才”的平台策略:通过充当 AI 工作流的核心中介,同时将用户锁定在其硬件生态中,苹果无需承担巨额的模型训练成本即可利用最先进的技术,从而有效地将自身定位为下一代计算的基础设施层。
XCancel 服务已暂停。遗憾的是,由于正在进行的法律程序出现新进展,我们被迫再次暂停此服务,直至另行通知。我们无法提供更多细节。您可以在原网站找到您想要的内容:继续前往 X。感谢您的理解,以及您对 XCancel 项目的信任。
对不起。
 使用您的 Meta Neural Band 来控制您的 Mac。Kinesis 可以实现桌面切换、打开调度中心 (Mission Control)、控制音乐,以及通过“捏合 + 旋转”手势来调节音量或亮度。您可以自定义映射,在设置中练习,并将其保留在菜单栏中运行。
本程序基于 Swift 原生开发,构建于我之前在 neural-band-poc 中对 Astra 进行的一些研究之上(欢迎查阅该存储库以进行二次开发)。我希望将其利用起来,做些有用的事情。
在开始之前,请务必将您的设备与 Meta App 解除配对。
下载 Kinesis,打开 dmg 文件,然后将其拖入“应用程序”文件夹。需要 macOS 14+ 及 Neural Band 设备。支持 Apple Silicon 和 Intel 芯片。
将您的设备设置为配对模式,连接后,在提示时允许蓝牙和辅助功能权限。启用控件,即可开始使用。
开发环境:Xcode 与 Swift 6。
```
git clone https://github.com/callbacked/kinesis.git
cd kinesis
./scripts/build.sh
open dist/Kinesis.app
```
重新构建前请先退出 Kinesis。
抱歉。
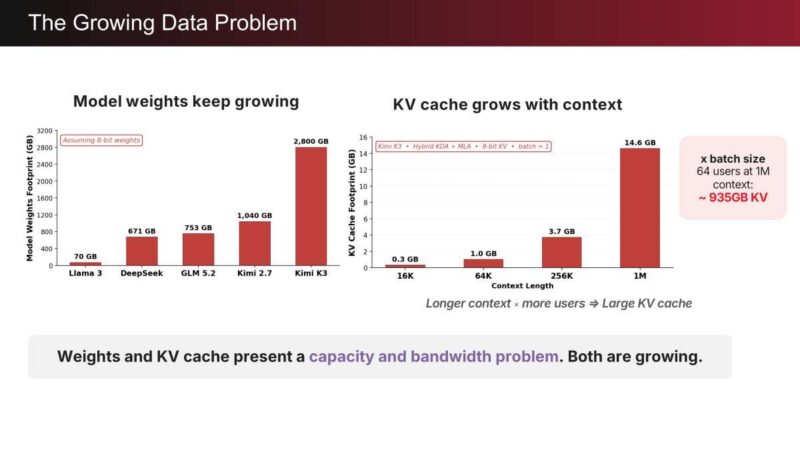 在 Hot Chips 2026 大会上,d-Matrix 发布了 **Raptor**,这是一款 3D-DRAM 加速器,旨在解决生成式 AI 推理中日益严重的内存带宽和容量瓶颈。
随着大语言模型(LLM)权重和键值(KV)缓存的不断增加,当前的解决方案已达到极限:SRAM 虽然带宽巨大但容量不足,而 HBM 不仅功耗高,还受限于物理“空间”和 I/O 限制。Raptor 通过采用低成本、高良率的台积电(TSMC)N4 “逻辑堆叠(logic-on-top)”架构,将计算单元直接堆叠在 DRAM 之上,从而解决了这一难题。
通过利用无 PHY(PHY-less)的垂直 3D I/O 技术,Raptor 实现了约 100 TB/s 的带宽,能效比约为 0.37 pJ/bit,比 HBM 高出约 10 倍。为应对 3D 集成的技术挑战,d-Matrix 实施了多项巧妙的方案,例如用于消除冗余读取的“流阻塞(stream blocking)”、实现低功耗 I/O 的“流翻转(stream flipping)”,以及用于确保在热挑战下依然保持可靠性的先进存储体链式连接(bank chaining)。
d-Matrix 声称,Raptor 在处理 3 万亿参数模型且上下文长度为 100 万时,能够实现每用户每秒 1,000 个 token 的吞吐量。如果这一架构转型成功,3D-DRAM 可能会从根本上改变 AI 加速器在内存容量与带宽之间的权衡方式,为高性能推理提供一条功耗效率显著提升的路径。
抱歉。
正在检查您的浏览器...需要启用 Javascript
抱歉。
我们正在验证您的浏览器。网站所有者?点击此处修复。Vercel 安全检查点 | sin1::1789387348-lHxZj6OJoRUGgLBuPKHoqiShCu9nVxdm。请启用 JavaScript 以继续。Vercel 安全检查点 | sin1::1789387348-lHxZj6OJoRUGgLBuPKHoqiShCu9nVxdm。
抱歉。
正在检查您的浏览器……需要 JavaScript。
抱歉。
请启用 JavaScript 和 Cookie 以继续。
抱歉。
 在 2022 年 Hackaday 超级大会上展示了自制二极管真空管后,作者为《Make:》杂志详细记录了整个制作过程。本摘要概述了在家中制造功能性真空管所涉及的技术挑战与方法。
最关键的步骤是使用“压封法”(pinch method)制作管座。通过清洁钨针并加热使其与硼硅酸盐玻璃熔合,作者实现了真空密封。管座准备就绪后,将钨丝灯丝和镍板等内部元件点焊到位,并加入一种钡基“吸气剂”来吸附残留的氧气。
随后,将组件密封在玻璃壳中,并连接到真空系统上。在将真空管抽至 10⁻⁵ mbar 并通过加热对内部元件进行除气后,作者执行了“封离”(tip-off)工序以永久密封真空管。最后,通过感应加热器激活吸气剂,形成一面反应镜以维持真空状态。尽管作者最终将该真空管测试至损坏,但这一成功的制作过程证明,只要掌握正确的方法并持之以恒,业余爱好者也能制造出高质量、功能完备的真空电子元件。