本项目包含一个轻量级神经网络,旨在判断给定的输入是否为“Numberwang”。整个模型仅存储在一个 1.8 MB 的 JSON 文件中,推理过程完全依赖 Python 标准库,无需 PyTorch 或 NumPy 等外部依赖。 该网络直接处理字符级输入,无需传统的标记化或规则引擎。它被训练用于将输入分为四类:*Numberwang*、*非 Numberwang*、*非数字* 或 *Wangernumb*。它展现了令人印象深刻的语言灵活性,能够识别十一种语言的数字,并能处理罗马数字、序数和基本算术。 在技术上,该模型采用简单的架构(Conv1d、ReLU、全局最大池化),包含 80,804 个参数。尽管其 F1 分数接近 0.90,但它更多依赖于记忆而非严谨的计算,因此对常见表达的判断高度准确,但在处理复杂的未知算术时可靠性稍逊。本项目开源并采用 MIT 许可证,为解决识别 Numberwang 这一历史性难题提供了一种极简且即插即用的方案。
每日HackerNews RSS
抱歉。

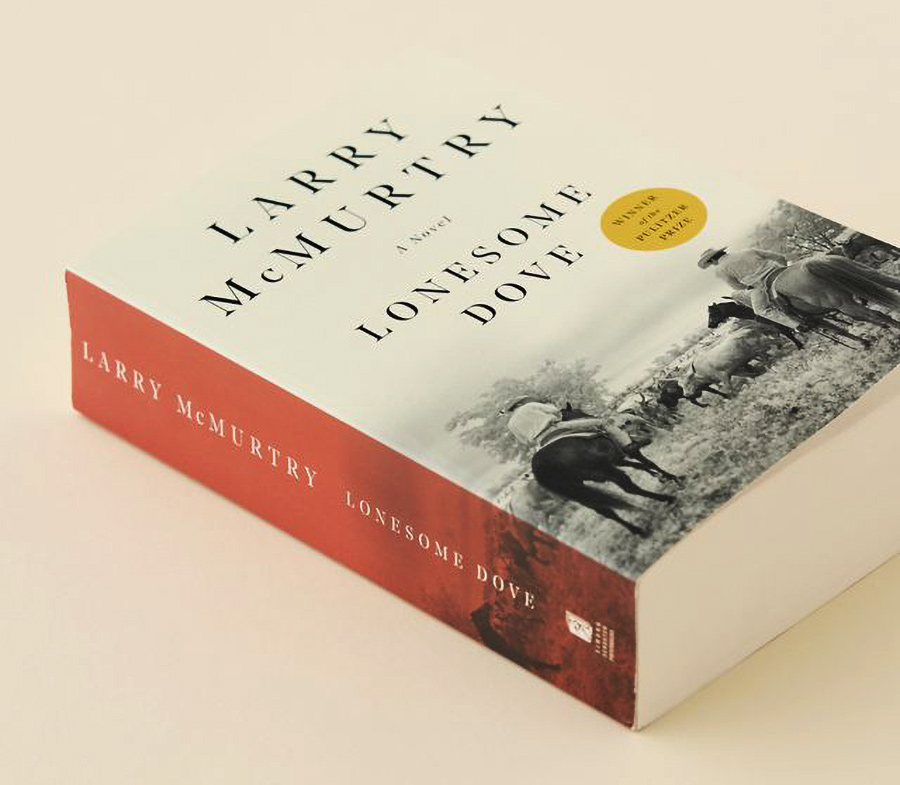 为了让厚重且费力的书籍更易于阅读,作者提倡一种简单实用的方法:将其拆分。像 850 页的《孤独鸽》这样的大部头,无论是手持、在床上阅读,还是旅行时携带,往往都很笨重。将平装本或精装本拆分成几个小巧、易于管理的部分,能显著改善你的阅读体验。
操作过程很简单:购买一本属于你自己的书,找出自然的断点(如章节或部分),然后用美工刀小心地切开书脊的胶水。拆分后,用牛皮纸文件夹和胶水为每一份新的“分册”制作一个简单实用的封皮,以保护书页。
作者强调,这是一种出于个人便利的实用主义方法,而非为了档案保存。无论你是用长尾夹固定封皮,还是用记号笔标记书脊,目的都是为了消除阅读大部头书籍的障碍。正如作者所言,你不需要任何人的许可来定制你的书库;如果一本书“太大了”,你完全可以把它变小。
抱歉。
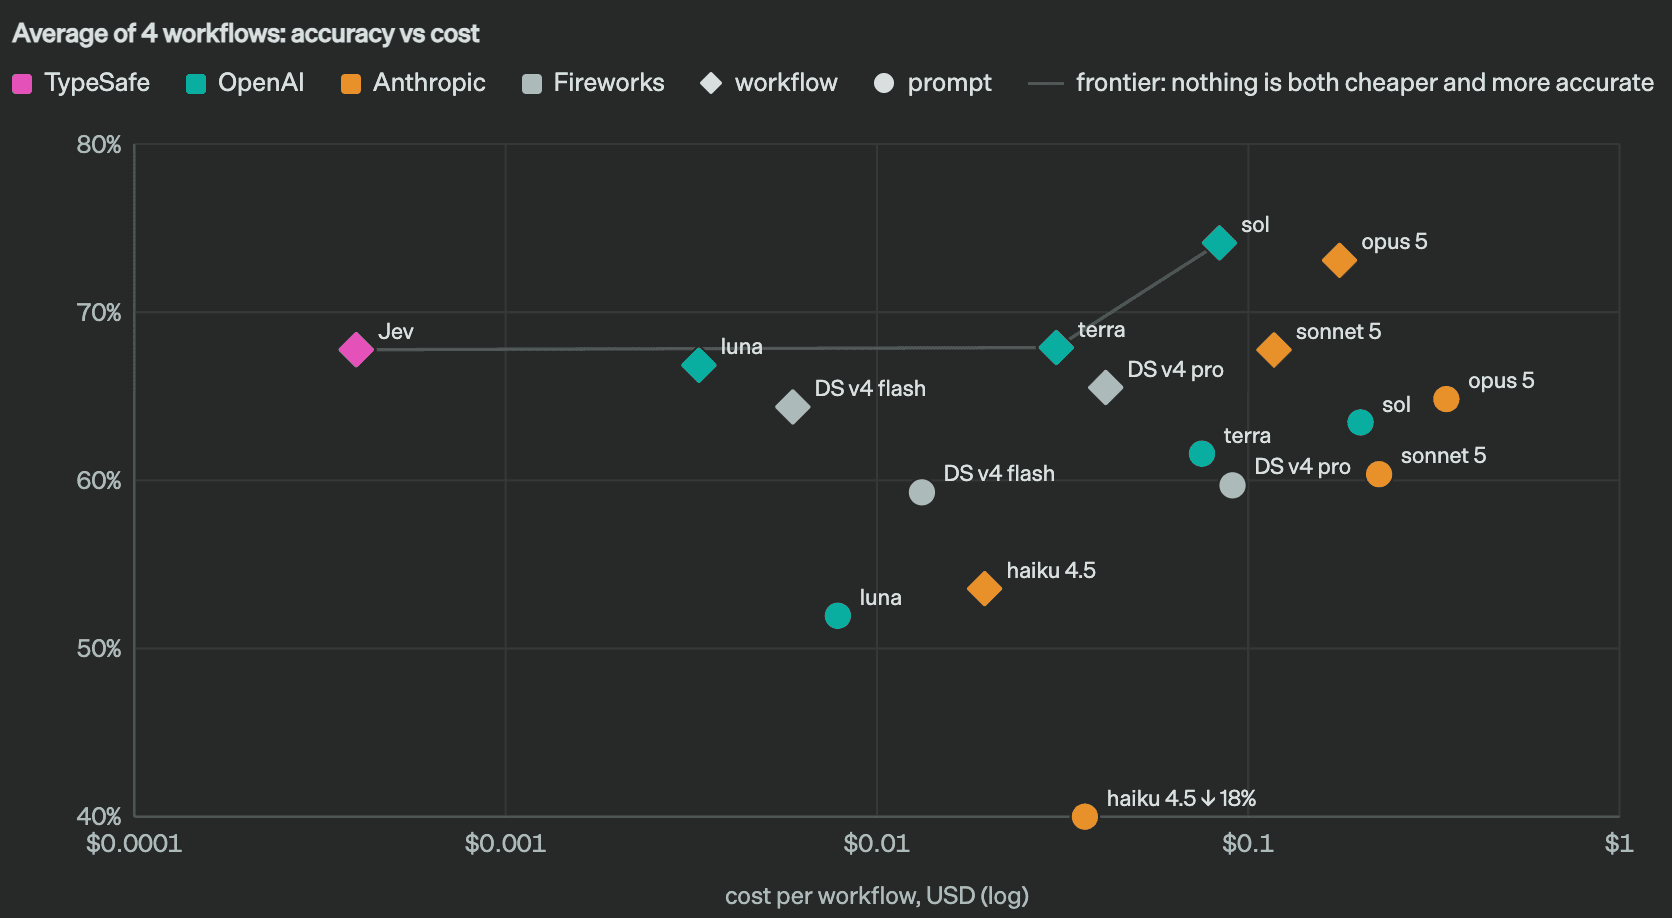 前 OpenAI 研究员 Diogo Almeida 推出了 **TypeSafe AI** 及其首款“系统一模型” **Jev**。
尽管现有的大语言模型(LLM)擅长聊天,但在直接集成到软件时,它们往往速度缓慢、成本高昂且不可预测。Jev 将范式从生成非结构化文本转变为提供快速、**类型安全的结构化输出**。通过采用一种称为“校准决策强化学习”(RLCD)的新型训练方法以及并行采样架构,Jev 具备以下优势:
* **极致效率**:比传统大语言模型快 40 到 200 倍,且成本显著降低。
* **可靠性**:消除了幻觉和类型错误,并在每次输出时提供认知上准确的置信度评分。
* **系统集成**:它作为一种“前沿智能函数调用”运行,允许开发者将人工智能决策直接嵌入代码中,用于路由、分类和复杂数据处理等任务。
Jev 专为程序正确性和延迟至关重要的自动化场景而设计。通过用灵活的文本生成换取确定性的结构化决策,TypeSafe AI 旨在解锁实时、大规模业务工作流中的全新应用场景。Jev 现已开放早期访问。
《纽约时报》的一篇报道强调了移民在合法保护期满后被美国驱逐出境所经历的悲惨遭遇。许多人(包括抵达海地海地角的移民)在被驱逐时身无分文,没有个人证件或当地支持,陷入动荡的环境中而孤立无援。 本届政府的驱逐政策不仅限于海地,据报道,还有人被送往危险或陌生、且与其毫无联系或缺乏文件的国家。一名滞留在中非共和国的古巴移民将这种处境描述为一种痛苦和与世隔绝的状态。批评人士指出,这些驱逐行动无视人类尊严,将弱势群体置于危及生命的境地。尽管国际社会对此表示担忧,且有旅行警告建议不要前往这些地区,但美国政府仍在加速驱逐行动,因未能给予被驱逐者人道主义关怀而招致严厉批评。
抱歉。
Hugging Face 向 OpenAI 开出 1 亿美元账单,指控其进行黑客攻击 Hugging Face is billing OpenAI $100M for hacking it
34 天前
本网站正在使用安全服务以抵御网络攻击。您刚才的操作触发了安全防御机制。触发此拦截的原因可能有多种,包括提交了特定的词汇或短语、SQL 命令或格式错误的数据。
喜欢这篇文章吗?我们需要您的帮助来维持我们的出版。PDR 是一个依靠读者捐赠维持的非营利项目——没有广告,没有付费墙,全靠我们社区的慷慨支持。这是一种非常令人兴奋的模式,但我们需要您的帮助才能让它持续发展。请访问我们的支持页面成为“挚友”,并获取我们的主题明信片套装,或者进行一次性捐赠。已经是我们的支持者了?非常感谢您让这一切成为可能。
抱歉。
AI 工具调用是如何运作的(40 行原生 JavaScript 代码) How AI tool calling works (40 lines of vanilla JavaScript)
34 天前
要将聊天模型转变为智能体(Agent),你必须实现一个简单的四步循环,使模型能够与外界进行交互。 **循环过程:** 1. **消息(Messages):** 将对话历史记录和可用工具定义的列表发送给模型。 2. **模型(Model):** 模型决定是提供文本回复还是发出 `tool_use` 请求(包含函数名称和参数的结构化代码块)。 3. **执行(Execution):** 你的代码执行所请求的函数并捕获结果。 4. **结果(Result):** 将 `tool_result` 追加到对话历史中,并将其发回给模型。 此循环会一直重复,直到模型以纯文本形式结束对话。 **关键原则:** * **无状态(Statelessness):** 模型本身没有记忆;对话数组即是状态。你必须在每一轮重新发送完整的历史记录,因此管理工具输出的大小对于控制成本至关重要。 * **协议(Protocol):** 你必须返回每一个工具的执行结果(即使是错误),并带上正确的 `tool_use_id` 以保持链路完整。 * **工具描述(Tool Descriptions):** 模型将工具描述视为提示词。如果模型误用了工具,应优化工具描述,而不是去寻找代码中的错误。 * **安全性(Safety):** 务必限制循环次数(例如限制在 20 轮内),以防止无限循环和失控的成本支出。
抱歉。
Google 推出了两款全新模型:**Gemini 3.8 Live** 和 **Gemini 3.8 Live Extended Thinking**,旨在增强人工智能语音代理的直觉、智能和响应能力。 * **Gemini 3.8 Live:** 该模型针对规模化和成本效益进行了优化,侧重于流畅的对话和视觉基础,非常适合日常对话应用。它目前备受推崇,在“语音代理竞技场”(Speech Agent Arena)中排名第二。 * **Gemini 3.8 Live Extended Thinking:** 该模型专为高复杂度、多步骤推理而设计,可提供企业级性能。在保持具有竞争力的价格的同时,它目前在语音转语音质量和代理任务完成度方面处于行业基准领先地位。 这两款模型共同为开发人员和企业提供了构建可靠、可投入生产的语音代理的强大工具。通过将这些进展整合到 Google Workspace、搜索和 Gemini 应用中,Google 正在打造一种更加协作、语音驱动的体验,从而简化复杂任务的执行。
关于 Gemini 3.8 及其“实时”功能的最新 Hacker News 讨论显示,社区内部存在严重分歧。
许多用户称赞 Gemini 的语言多功能性,特别是它处理南非语、加泰罗尼亚语和绍纳语等小众语言的能力,以及在实时语音模式下自然、流畅的对话感。对于日常用户和深入调研需求而言,Gemini 因其速度和对话语调而备受青睐,许多人认为它更具“人情味”,不像 Claude 或 OpenAI 模型那样容易出现教条式的“AI 废话”或过度的委婉推托。
然而,相当一部分核心用户和开发者仍持批评态度。批评者认为,虽然 Gemini 在日常互动中表现出色,但在编程、逻辑推理和复杂任务执行方面,它仍落后于 Claude (Sonnet) 或 OpenAI 的最新模型。一些用户对谷歌在 Workspace 和个人账户之间不一致的模型版本发布,以及偶尔出现的“语境健忘”表示不满。
归根结底,这场辩论的核心在于价值判断:有些人认为谷歌因在原始编程基准测试中未能领先而“搞砸了”人工智能竞赛;而另一些人则认为,谷歌通过将高效、快速的 AI 集成到人们现有的工具中,成功占领了庞大的日常用户市场。