Snapdrop 网络中的所有人都可以发现你 文件已接收 文件名 下载前询问是否保存每个文件 消息已接收 复制 关闭 连接有问题? 允许麦克风权限有助于 Chrome 连接到附近的设备。Snapdrop 将短暂激活你的麦克风并立即停止。不会录制或发送任何音频。 允许 暂不 文件传输已完成 在设备间传输文件的最简单方法 Snapdrop 仅在启用 JavaScript 时工作
每日HackerNews RSS
抱歉。
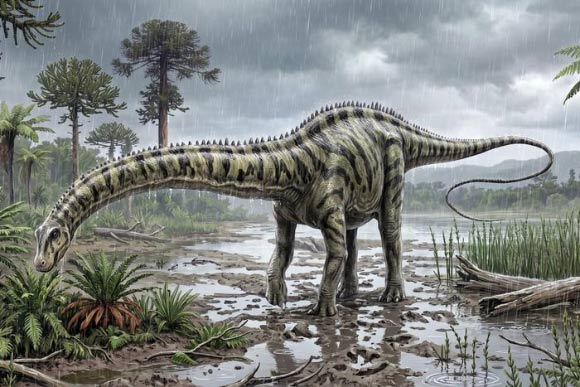 西班牙 Dinópolis 基金会的古生物学家发现了北美以外首批确认的梁龙化石。这些化石在特鲁埃尔(Teruel)的 La Tejería 遗址出土,包括 14 块保存完好的尾椎骨及相关骨骼,属于一只生活在约 1.5 亿年前、体长 25 米的蜥脚类恐龙。
这一重大发现为侏罗纪晚期欧洲与北美之间的动物群交流提供了有力证据。研究人员认为,随着原始北大西洋退去而形成的临时陆桥,使这些巨型恐龙得以在各大洲之间迁徙。
此项发现加深了我们对伊比利亚半岛中生代生态系统的认识,并凸显了该地区极高的蜥脚类恐龙多样性。通过确认西班牙境内梁龙的存在,科学家们获得了关于这些标志性生物扩散模式的重要见解,也巩固了特鲁埃尔作为古生物学研究关键地点的地位。研究团队的发现即将发表在《脊椎动物古生物学杂志》上。
抱歉。
 若想在利用大语言模型(LLM)提升写作水平的同时又不失个人风格,请将模型视为一名严格的文字编辑,而非代笔者。读者很容易识别出带有“大模型味”的行文,因此请遵循以下两条基本原则:
1. **切勿使用大模型建议的措辞:** 最前沿的模型经过训练,倾向于使用那种经过润色、标题党式的语气,过度使用会显得非常生硬。即便 AI 的建议听起来更好,也请拒绝采纳,以保持你的个人真实性。
2. **拒绝大模型的吹捧:** AI 模型容易过度恭维。它们会夸赞你拙劣的初稿,导致你坚持错误的写作方式。请忽视它们的夸赞,并禁止它们提供空洞的肯定。
相反,应利用大模型来处理人工编辑中那些“繁琐的工作”。要求模型找出结构缺陷、用词重复、副词滥用或被动语态等干扰表达的问题。通过让 AI 指出问题而非提供解决方案,你可以保留完全的创作控制权。参考专业的风格指南(例如《风格:清晰与优雅的课程》),编写具体且严苛的提示词。这样既能加快编辑流程,又能让你的文字保持人性化、犀利且严谨。
这篇 Hacker News 的讨论围绕文章《如何利用大语言模型写作》(How to Write with an LLM)展开。该文认为,虽然大语言模型(LLM)可以充当机械化的文字编辑,但绝不应被用作面向人类读者的内容的代笔者。
辩论的核心要点包括:
* **“作者责任”原则:** 大多数参与者认同写作即思考。如果作者不投入精力去构建自己的思想,读者就没有义务去阅读。人工智能生成的“垃圾内容”被视为对沟通价值的贬低。
* **人工智能作为编辑的角色:** 许多用户成功利用大语言模型来标记技术性问题(如过度使用的词汇、被动语态或冗长句子),而非要求其进行文风重写。共识是人工智能缺乏“品味”和“心智理论”,往往会过度润色文稿,导致其失去人性本质。
* **“AI 腔调”的风险:** 评论者指出,过度依赖大语言模型写作往往会陷入可预测的、公式化的模式(例如使用“负载”或“深入探讨”等词汇)。过度依赖这些工具存在导致人类沟通“哈布斯堡化”的风险,即模型最终会基于自身产出的低质量内容进行训练。
* **结论:** 真实的写作需要人类的判断力、刻意的词汇选择以及个人的努力。
重试风暴是指服务在请求失败时频繁进行重试,导致流量在深度依赖链路中呈指数级放大。传统的解决方案(如重试配额)通常依赖手动配置且缺乏上下文信息,无法区分根本原因与衍生故障。
为了解决这一问题,Uber 在其服务网格中实现了一种“上下文感知”的错误归属机制。通过服务依赖分析来关联入站和出站故障,系统能够确定哪个服务是错误的真正“责任方”。
逻辑如下:
* **如果服务因下游故障而报错:** 该错误被标记为“衍生故障”,重试仅限于直接的调用方与被调用方之间。
* **如果服务在没有上游触发的情况下返回错误:** 该服务被视为“责任方”,仅允许该服务进行重试。
这种方法防止了不必要的重试向调用栈上游蔓延,从而有效遏制了级联故障。在 2025 年的一次重大故障中,该架构拦截了超过 950 万次无效请求,将“重试风暴影响范围”从 25 个节点深度缩减至 3 个。这一自动化的基础设施层解决方案无需针对每个服务进行定制配置,即可为 Uber 的技术栈提供保护。
这段 Hacker News 讨论聚焦于管理“重试风暴”所带来的挑战,即分布式系统中自动化重试逻辑导致级联故障和延迟增加的问题。
讨论中的主要观点包括:
* **盲目重试的风险:** 在调用链(A→B→C→D)的每一层简单地增加重试,会使负载呈指数级增长。参与者建议,只有“智能”重试才有效,例如针对特定操作(如数据库事务)而非整个请求链进行重试。
* **建议策略:** 用户提倡使用“重试预算”和严格的错误分类。一个关键建议是从下游服务传递“禁止重试”的提示,以防止上游进行不必要的尝试。
* **其他缓解措施:** 除了重试之外,参与者还强调了负载削减(在延迟飙升时限制并发)、熔断器和速率限制等技术。
* **技术细节:** 虽然指数退避和抖动是基础,但它们并非万能方案。资深从业者建议为重试设置截止时间,并使用令牌桶来限制故障期间允许的总额外流量,从而确保重试逻辑不会无意中损害系统稳定性。
```python import flet as ft def main(page: ft.Page): counter = ft.Text("0", size=50, data=0) def increment(e): counter.data += 1 counter.value = str(counter.data) page.update() page.floating_action_button = ft.FloatingActionButton( icon=ft.Icons.ADD, on_click=increment ) page.add( ft.Container( content=counter, alignment=ft.alignment.center, expand=True, ) ) ft.app(target=main) ```
抱歉。
这份摘要探讨了被称为“理性主义”的封闭且具影响力的亚文化,该亚文化已深深植根于人工智能产业和美国政策制定中。这一群体发源于伯克利地区的网络论坛和牛津大学的哲学讨论,其核心信仰是“英雄式的责任感”——即坚信一小部分“卓越”个体必须单方面引领人类度过生存危机,最显著的便是对所谓“人工智能末日”的预测。 该运动具有类似邪教的运作模式,表现为共享居住、交织的恋爱与资助关系,以及对内部仪式和教义的依赖。尽管其成员在 Anthropic 和 OpenAI 等顶尖 AI 实验室任职,但该文化却丑闻缠身,包括强制性的心理“调试”、虐待指控,甚至与暴力极端主义的联系。 文章将这一亚文化与彼得·蒂尔(Peter Thiel)等强有力的政治捐款人联系起来,指出他们利用这些网络来影响政府任命并瓦解民主制度。文中认为,该运动对未来末日的推测性沉迷,实际上是其追求监管捕获和精英控制的借口。最终,文章指出,关于“AI 毁灭”的讨论与该群体的傲慢密不可分,他们视自己的卓越智力为逃避普通问责的特权。
这段文字记录了 Hacker News 上关于人工智能安全、“理性主义”(Rationalism)和“有效利他主义”(EA)亚文化的一场激烈辩论。
讨论的核心是一篇批评文章,该文章将这些运动描述为一个容易陷入群体思维的同质化、封闭性群体。批评者认为,人工智能领域由一个特定的、关系紧密的精英阶层所主导——他们通常与埃利泽·尤德科夫斯基(Eliezer Yudkowsky)等人物有关联——其“末日概率”(P(doom))叙事更多是出于排他性的亚文化动态和社会信号传递,而非客观的科学共识。反对者常引用山姆·班克曼-弗里德(Sam Bankman-Fried)的参与作为其道德破产和智力傲慢的证据。
反之,一些参与者认为,将这些担忧简单地斥为“邪教”行为是反智的表现。他们主张,尽管该群体可能较为小众,但其成员已花费数十年时间严格探讨了主流社会才刚刚开始意识到的生存风险。
归根结底,这场讨论反映了深刻的两极分化:一方将人工智能“末日论者”视为试图垄断叙事的危险精英集团;而另一方则坚持认为,无论发出警报的人是否被视为“怪异”或“关系户”,人工智能带来的生存风险都是真实存在的。
 作者对微软限制性的许可政策表达了强烈不满,尤其是在大学为微软投入巨资的情况下,他却无法在 Mac 上编辑 PowerPoint 文档。
这篇抨击文章谴责了微软生态系统中的臃肿软件、激进的数据收集行为,以及像“Recall”和“Copilot”这类侵入性功能。作者指出,微软通过复杂且不道德的合同条款,强制机构陷入只能使用 Windows 的循环中。作者认为这些做法从根本上是对用户的不尊重,也是对数字主权的威胁。
归根结底,这篇文章是一份行动号召,敦促用户放弃专有软件和封闭的文档格式,转而支持更开放、透明的替代方案。作者承认自己目前仍依赖大型科技平台(如 GitHub),但同时也表达了在未来转向更具道德感的数字实践的个人承诺。
抱歉。

抱歉。
Bonsai 2 27B:以 1/9 的体积实现近乎无损的压缩 Bonsai 2 27B: Near-Lossless Compression in a 9x Smaller Footprint
31 天前
PrismML 发布了 **Ternary Bonsai 2 27B**,这是一款基于 Qwen3.8 27B 的高效多模态 AI 模型。通过采用三值化 {−1, 0, +1} 权重压缩技术,该模型的权重位宽有效降至 1.76 比特,使得模型体积仅为 5.9GB。 尽管体积小巧,该模型仍保留了全精度模型 98.2% 的综合性能。这种“近乎无损”的压缩技术显著提升了智能密度,增强了模型在推理、编程、视觉及智能体方面的能力。该模型支持 262K token 的上下文窗口,并针对 NVIDIA GPU(通过 CUDA)和 Apple Silicon(通过 MLX)的本地部署进行了优化。 除了性能出色,Ternary Bonsai 2 27B 在能效方面表现卓越:在 RTX 5090 上运行速度可达每秒 143 token,且能耗比标准 8B 模型降低了 40%。这一性能特点使其非常适合编程智能体和私有高频工作流等本地应用场景。该模型基于 Apache 2.0 许可证发布,证明了低比特架构能够有效弥合高阶智能与受限硬件环境之间的差距,有望重塑 AI 在各类设备和数据中心的部署方式。
**Bonsai 2 27B** 模型因其高效、近乎无损的压缩技术在 Hacker News 上引起了广泛关注,该技术将模型体积压缩至约 6GB(每个权重 1.76 比特)。通过使用三元权重 ({−1, 0, +1}) 和先进的量化技术,用户能够在显存受限的消费级硬件上运行 270 亿参数的模型。
**讨论要点总结:**
* **性能:** 用户反馈其速度表现出色,部分高端硬件可达到每秒 100 个 token 以上,但具体性能因系统配置和优化程度而异。
* **实用性:** 尽管该模型在技术上具有创新性,但其“近乎无损”的说法仍存在争议。社区成员指出,与全精度或标准的 4-bit 量化版本相比,该模型在处理复杂的智能体编码任务和长上下文窗口时表现欠佳,容易出现循环输出或“幻觉”现象。
* **技术门槛:** 目前运行该模型需要特定版本的 `llama.cpp` 分支,这导致了一些关于设置复杂性和缺乏上游支持的反馈。
* **社区观点:** 社区认为这是资源受限环境(如移动设备或旧款 GPU)的一项重大突破,但爱好者们提醒,对于高要求的专业编码或推理任务,它目前仍无法取代更大规模、更高精度的模型。
请启用 JavaScript 并关闭任何广告拦截器
近期发表在《科学进展》上的一项研究表明,霸王龙的体温约为 97°F(36.3°C)。加州大学洛杉矶分校的研究人员通过分析牙齿化石的地球化学特征,并将其与鳄鱼牙齿进行对比,从而区分出体温和环境热量。
这些发现支持了科学界日益增长的共识,即许多恐龙属于温血动物而非爬行动物。Hacker News 上的讨论聚焦于这些发现的重要性,一些用户指出,对于这种体型巨大的动物而言,处于“哺乳动物”体温范围内符合直觉。
社区的大部分讨论集中在《纽约时报》标题缺少单位的问题上。尽管一些读者对文章未注明华氏度表示不满,但另一些人则认为这是美国大众类出版物的标准做法。该讨论帖还涉及了科学共识的演变、恐龙生理学研究的历史,以及关于温度刻度细微差别的轻松讨论。